

Introdução
A transcrição de voz em tempo real estabelece uma conexão persistente via WebSocket (um protocolo que mantém uma conexão de longa duração entre cliente e servidor, permitindo enviar dados nos dois sentidos) e processa o fluxo de áudio contínuo recebendo, transcrevendo e retornando ao mesmo tempo, sendo adequada para cenários de voz sensíveis à latência. Diferenças em relação à transcrição de arquivos STT:
Modelos disponíveis:
- gpt-live-transcribe: modelo de transcrição em streaming, suporta múltiplos idiomas e produz o texto transcrito em tempo real conforme o áudio é recebido.
Início rápido
Endpoint de conexão
intent=transcription: obrigatório, declara que esta é uma sessão de transcrição.model=gpt-live-transcribe: obrigatório, o modelo é fixado pelo parâmetro de URL no momento da conexão e não pode ser alterado durante a sessão (veja as restrições abaixo).
Autenticação
No handshake, informe a chave por meio do cabeçalho HTTP padrão:Requisitos de formato de áudio
Atualmente há suporte a apenas um formato de entrada; antes de enviar, converta o áudio para:- Codificação: PCM16 (inteiro de 16 bits com sinal, little-endian)
- Taxa de amostragem: 24000 Hz
- Canais: mono
audio/pcm@24000. Enviar em outro formato (como G.711/µ-law) resulta em rejeição e no fechamento da sessão.
A sessão de transcrição não suporta detecção de atividade de voz (turn_detection / VAD), que deve ser definida explicitamente como
null. Se você omitir ou passar um valor diferente de null, o provedor de modelos rejeita a transcrição com invalid_value. O gateway força turn_detection para null na configuração encaminhada, mas ainda é recomendável defini-la como null no cliente para manter o comportamento claro.Configuração da sessão (session.update)
Depois de estabelecida a conexão, o cliente envia primeiro um framesession.update para configurar os parâmetros de transcrição. Se você não enviar, o gateway injeta uma configuração padrão de contingência com o modelo autorizado, mas recomenda-se configurar explicitamente.
Parâmetros de configuração
string
obrigatório
Tipo de sessão; no cenário de transcrição é fixo em
transcription.object
obrigatório
Formato do áudio de entrada, fixo em
{ "type": "audio/pcm", "rate": 24000 }.string
obrigatório
Modelo de transcrição. Deve ser igual ao
model da URL de conexão (gpt-live-transcribe). Passar outro modelo é considerado acesso não autorizado e a sessão será fechada com 1008.string[]
Lista de idiomas esperados, em forma de array (como
["en", "zh"]). O gpt-live-transcribe usa languages no plural, permitindo declarar vários idiomas de uma vez; especificar o idioma melhora a precisão e reduz a latência. O dicionário de valores está em Códigos de idioma abaixo.string
Forma no singular, um único código ISO-639-1 (como
"en"). Use languages ou language, um dos dois, não passe ambos ao mesmo tempo (passar os dois resulta em rejeição com invalid_value). A recomendação oficial para o gpt-live-transcribe é usar languages no plural; o gateway também aceita language no singular, o que facilita a migração de código antigo.string
Prompt de texto livre que descreve o cenário da gravação (como “atendimento ao cliente” ou “consulta com termos médicos”), ajudando o modelo a se ajustar ao registro de linguagem. Em testes reais, o servidor devolve o valor sem alterações em
session.updated, confirmando que já está em vigor.string[]
Array de termos literais de dica, usado para nomes de produtos, siglas, nomes próprios e outras palavras propensas a erro (como
["AiHubMix", "gpt-live-transcribe"]). É uma dica, não uma saída obrigatória; coloque cada termo como um item separado e evite incluir <, > ou quebras de linha. Em testes reais, o valor é devolvido e já está em vigor.string
Nível de latência / precisão, com valores possíveis
minimal, low, medium, high, xhigh: quanto maior o nível, mais preciso, porém com maior latência. Atenção: o gateway aceita este campo (sem erro), mas em testes reais ele não é devolvido em session.updated; a efetividade segue a documentação oficial e ainda não foi confirmada pelo retorno.null
obrigatório
Detecção de atividade de voz. Na sessão de transcrição deve ser
null.object
Configuração opcional de redução de ruído, como
{ "type": "near_field" } (campo próximo, adequado quando o microfone está perto de quem fala) ou { "type": "far_field" } (campo distante).Códigos de idioma (language codes)
Os valores delanguages / language seguem os formatos abaixo, diferenciam maiúsculas de minúsculas e devem estar em uma das formas suportadas; passar um código não suportado ou com formato incorreto faz a realtime API rejeitá-lo:
Enviar áudio
Divida o áudio PCM16 em pequenos fragmentos (por exemplo, um a cada 100ms), codifique em base64 e envie continuamente pelo eventoinput_audio_buffer.append:
input_audio_buffer.commit para marcar o fim desse trecho, o que aciona a finalização da transcrição e retorna o resultado completed:
Receber os resultados da transcrição
O servidor envia eventos continuamente; os principais tipos de evento são:event
Confirmação da criação da sessão e da atualização da configuração.
event
Resultado incremental da transcrição; o campo
delta é o novo trecho de texto adicionado nesta rodada. Retorna durante a fala, adequado para exibir na tela em tempo real.event
A transcrição de um trecho de fala foi concluída; o campo
transcript é o texto completo desse trecho.event
Evento de erro, contendo o código de erro e a descrição.
Exemplo completo
A seguir, duas abordagens; escolha uma delas:- SDK oficial da OpenAI (recomendado): não é preciso escrever o WebSocket manualmente, basta apontar
websocket_base_url(o parâmetro de base URL do WebSocket do SDK) para o gateway e reutilizar a biblioteca oficial. - websockets nativo: sem instalar o SDK, envie e receba frames diretamente conforme o protocolo, com o mínimo de dependências e mais fácil de depurar.
Por que o demo oficial não passa o nome do modelo, mas nós precisamos? O intent de transcrição da OpenAI coloca o modelo em
transcription.model dentro do session.update, e a URL de conexão traz apenas ?intent=transcription. O gateway da AiHubMix é diferente: o nome do modelo precisa aparecer na URL do handshake (?model=gpt-live-transcribe), porque o gateway usa esse valor já no momento do handshake do WebSocket para selecionar o provedor de modelos, autenticar e reservar a cota, enquanto o session.update só chega depois do handshake concluído, tarde demais. Por isso, ao usar o SDK, passe model explicitamente para connect() (o SDK o insere na query da URL); sem ele, o gateway retorna 400 missing_model_parameter ainda na fase do handshake: connect() lança uma exceção diretamente, a conexão nem sequer é estabelecida e não se chega à etapa de session.update. Dentro da sessão, transcription.model ainda precisa coincidir com a URL.Resultado de execução (teste real em produção)
A seguir está o resultado real do exemplo acima no ambiente de produçãoaihubmix.com (modelo gpt-live-transcribe). Foram configurados languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" }:
Em testes reais,
languages, prompt, keywords e noise_reduction são todos devolvidos pelo servidor sem alteração em session.updated, o que indica que a configuração está de fato em vigor (e não apenas aceita sem processamento). O campo delay é aceito pelo gateway, mas não é devolvido; sua efetividade segue a documentação oficial. Entre language (singular) e languages (plural), só é possível passar um dos dois.Detalhes de cobrança
- Preço unitário: o
gpt-live-transcribeé cobrado a $0.017 / minuto (prevalece o preço anunciado em tempo real na página de detalhes do modelo). - Cobrança pela duração do áudio transcrito: baseia-se nos segundos de áudio efetivamente encaminhados ao modelo de transcrição, arredondados para cima ao segundo inteiro. Por exemplo, transcrever 90 segundos de áudio custa
90 ÷ 60 × $0.017 = $0.0255. - A cobrança não é afetada pela ida e volta na rede nem pela espera ociosa, contando apenas o áudio realmente enviado para transcrição.
- Liquidação contínua durante o uso: esta é uma conexão de longa duração, e o custo não é liquidado de uma só vez ao fim da sessão, mas descontado em tempo real, por segmentos, ao longo da sessão. Ao estabelecer a sessão, é feita uma reserva de cota com base em cerca de 1 minuto de uso (apenas como validação de admissão, não é um débito real); durante a sessão, a reserva é renovada de forma rolante a cada 20 segundos, o custo real é descontado por segmentos conforme os segundos realmente encaminhados, e a reserva restante é liberada ao fim da sessão. Portanto, o saldo disponível da conta precisa cobrir pelo menos cerca de 1 minuto de uso para que a sessão possa ser estabelecida.
- No detalhamento de consumo em Uso e faturamento, a observação de cada registro de transcrição em tempo real indica o “preço por minuto” e os “segundos efetivamente cobrados nesta ocasião”, facilitando a conferência item a item.
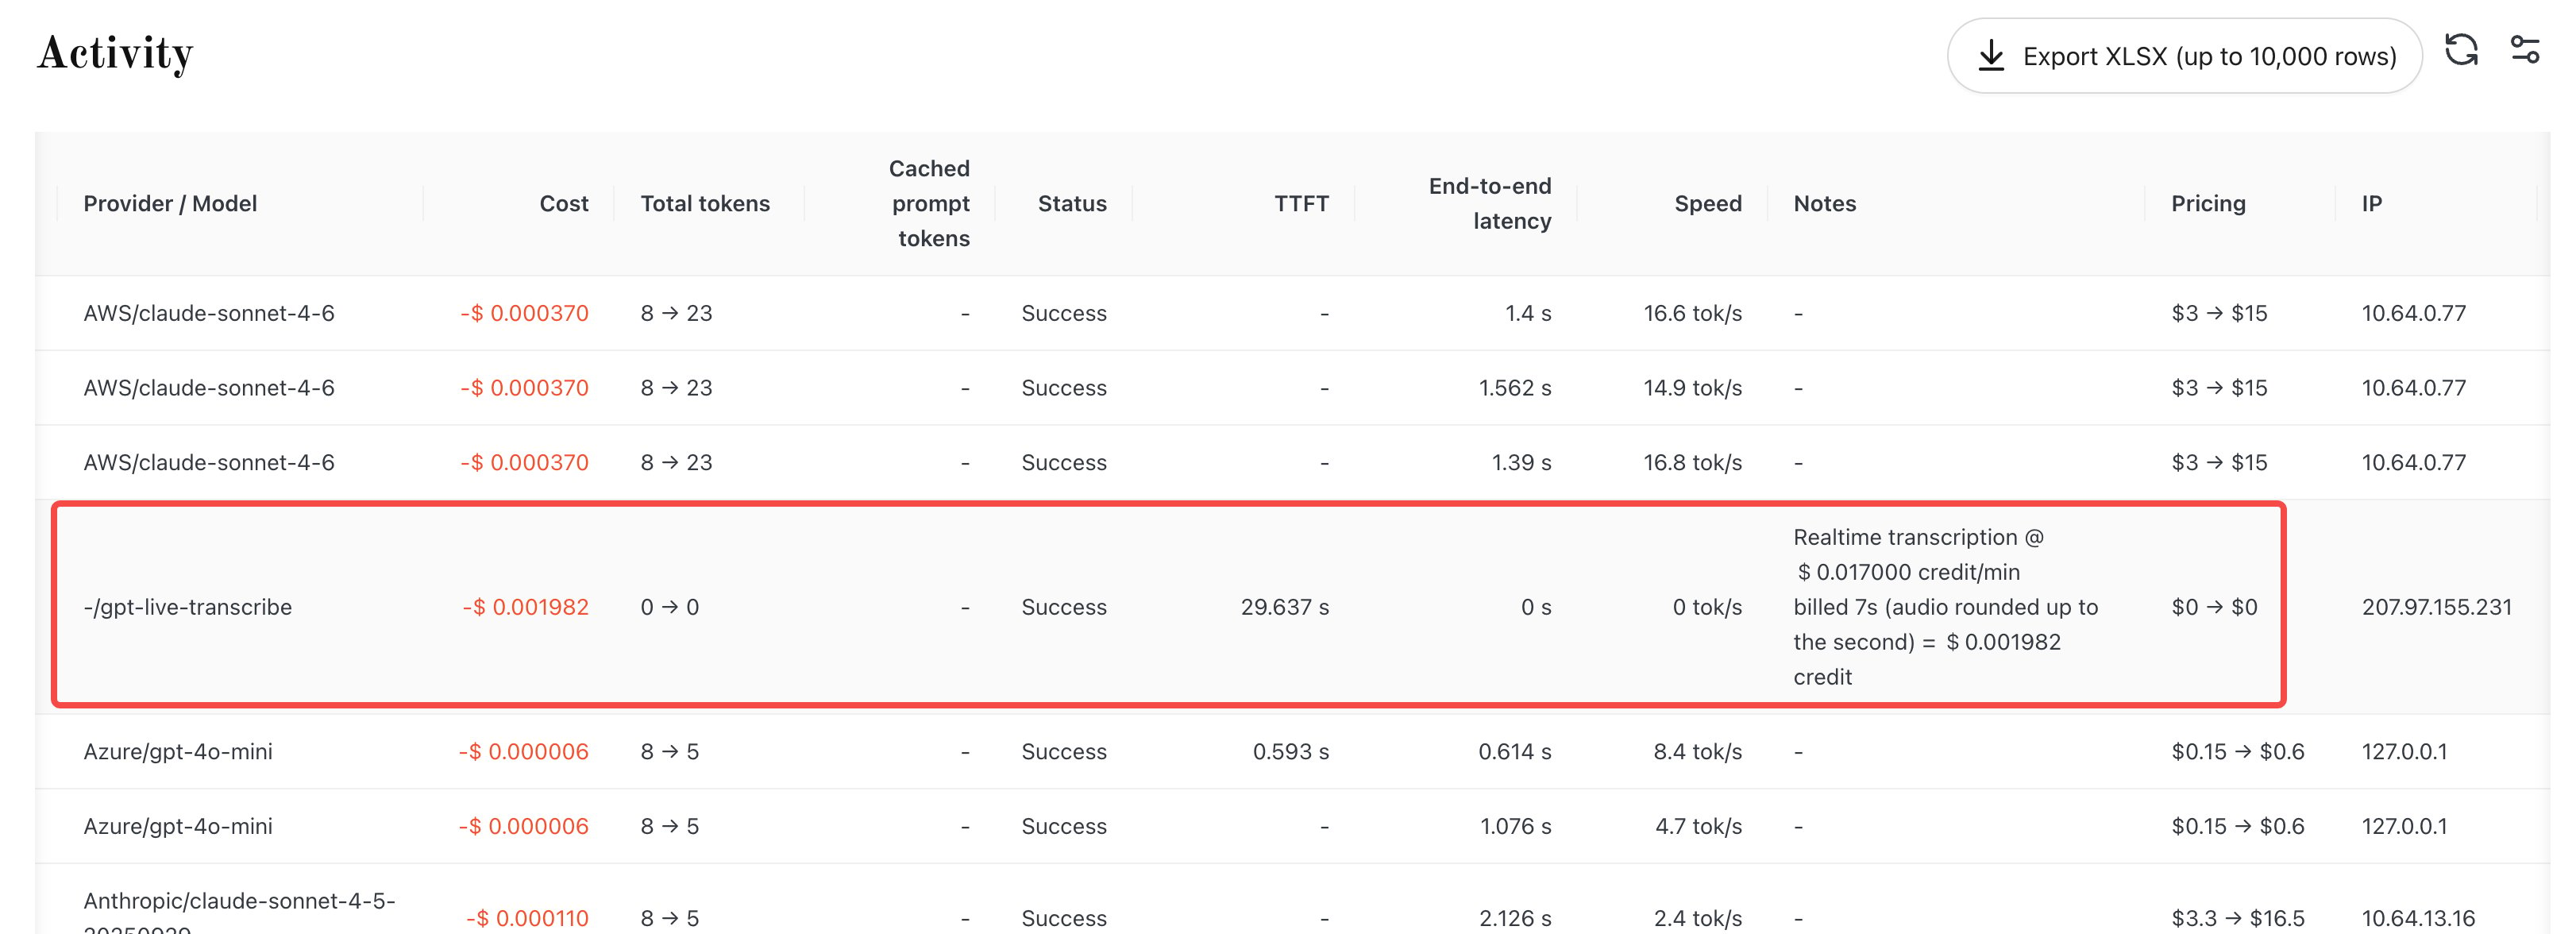
Um registro de cobrança de transcrição em tempo real do gpt-live-transcribe na visão Activity de Uso e faturamento; a observação indica 7 s de áudio cobrados a $0.017 / min = $0.001982, conforme o formato descrito acima.
Limites e restrições
- Duração de uma sessão: uma conexão WebSocket dura no máximo 62 minutos; ao atingir esse limite, o servidor a fecha ativamente; se você precisar de mais tempo, reconecte por segmentos.
- Saldo insuficiente: há dois casos. Ao estabelecer a sessão, se o saldo disponível não cobrir a reserva de cerca de 1 minuto, o handshake é rejeitado diretamente (HTTP 403) e a sessão não é estabelecida; durante a sessão, se o saldo se esgotar (detectado na validação de renovação a cada 20 segundos ou na reverificação após o débito por segmento), a conexão já estabelecida é fechada imediatamente.
- Apenas no lado do servidor: não há suporte a conexão direta do navegador (o cabeçalho
Originé validado); faça a integração no servidor. - Modelo travado: o modelo é fixado na URL de conexão; tentar alterá-lo durante a sessão via
session.updateé rejeitado e a sessão é fechada. - Formato travado: há suporte apenas a
audio/pcm@24000mono; outros formatos são rejeitados.
Erros comuns
Última atualização: 2026-09-16