

Einführung
Die Echtzeit-Sprachtranskription baut über WebSocket (ein Protokoll, das eine dauerhafte Verbindung zwischen Client und Server hält und Daten in beide Richtungen übertragen kann) eine persistente Verbindung auf und verarbeitet den kontinuierlich eingehenden Audiostream so, dass er gleichzeitig empfangen, transkribiert und zurückgegeben wird. Das eignet sich für latenzempfindliche Sprachszenarien. Der Unterschied zur Dateitranskription STT:
Verfügbare Modelle:
- gpt-live-transcribe: Streaming-Transkriptionsmodell, unterstützt mehrere Sprachen und gibt den transkribierten Text in Echtzeit zur Audioeingabe aus.
Schnellstart
Verbindungs-Endpoint
intent=transcription: Pflicht, deklariert dies als Transkriptionssitzung.model=gpt-live-transcribe: Pflicht, das Modell wird beim Verbindungsaufbau durch den URL-Parameter fest vorgegeben und kann während der Sitzung nicht mehr geändert werden (siehe die Einschränkungen weiter unten).
Authentifizierung
Beim Handshake wird der Schlüssel über den standardmäßigen HTTP-Header übergeben:Anforderungen an das Audioformat
Derzeit wird nur ein Eingabeformat unterstützt. Konvertieren Sie das Audio vor dem Senden in:- Kodierung: PCM16 (16-Bit-Ganzzahl mit Vorzeichen, Little-Endian)
- Abtastrate: 24000 Hz
- Kanal: Mono
audio/pcm@24000. Das Senden eines anderen Formats (z. B. G.711/µ-law) wird abgelehnt und die Sitzung geschlossen.
Transkriptionssitzungen unterstützen keine Sprachaktivitätserkennung (turn_detection / VAD), sie muss explizit auf
null gesetzt werden. Wenn Sie das Feld weglassen oder einen anderen Wert als null übergeben, lehnt der Modellanbieter die Transkription mit invalid_value ab. Das Gateway erzwingt für die weitergeleitete Konfiguration turn_detection auf null, es wird jedoch empfohlen, dass Sie es auch clientseitig aktiv auf null setzen, um das Verhalten klar zu halten.Sitzungskonfiguration (session.update)
Nach dem Verbindungsaufbau sendet der Client zunächst einensession.update-Frame, um die Transkriptionsparameter zu konfigurieren. Wenn Sie ihn nicht senden, injiziert das Gateway zur Absicherung eine Standardkonfiguration mit dem autorisierten Modell, eine explizite Konfiguration wird jedoch empfohlen.
Konfigurationsparameter
string
erforderlich
Sitzungstyp, im Transkriptionsszenario fest auf
transcription gesetzt.object
erforderlich
Eingabe-Audioformat, fest auf
{ "type": "audio/pcm", "rate": 24000 } gesetzt.string
erforderlich
Transkriptionsmodell. Muss mit dem
model der Verbindungs-URL übereinstimmen (gpt-live-transcribe). Die Übergabe eines anderen Modells gilt als unbefugt, und die Sitzung wird mit 1008 geschlossen.string[]
Liste der erwarteten Sprachen in Array-Form (z. B.
["en", "zh"]). gpt-live-transcribe verwendet den Plural languages, sodass mehrere Sprachen auf einmal deklariert werden können; die Angabe von Sprachen erhöht die Genauigkeit und senkt die Latenz. Das Wertelexikon finden Sie unter Sprachcodes weiter unten.string
Singular-Schreibweise, ein einzelner ISO-639-1-Code (z. B.
"en"). Verwenden Sie entweder dies oder languages, übergeben Sie nicht beides gleichzeitig (das gleichzeitige Übergeben wird mit invalid_value abgelehnt). Offiziell wird für gpt-live-transcribe der Plural languages empfohlen; das Gateway akzeptiert auch den Singular language, was die Migration von altem Code erleichtert.string
Freitext-Prompt, der das Aufnahmeszenario beschreibt (z. B. „Kundenservice-Anruf”, „Sprechstunde mit medizinischen Fachbegriffen”) und dem Modell hilft, sich dem Sprachregister anzupassen. In der Praxis gibt der Server ihn in
session.updated unverändert zurück, er ist also wirksam.string[]
Array von wörtlichen Hinweiswörtern für fehleranfällige Begriffe wie Produktnamen, Abkürzungen und Eigennamen (z. B.
["AiHubMix", "gpt-live-transcribe"]). Es handelt sich um einen Hinweis und keine erzwungene Ausgabe; jedes Wort steht als eigener Eintrag, und <, > sowie Zeilenumbrüche sollten vermieden werden. In der Praxis wird es zurückgegeben und ist wirksam.string
Latenz-/Genauigkeitsstufe, mögliche Werte
minimal, low, medium, high, xhigh: je höher die Stufe, desto genauer, aber desto höher die Latenz. Hinweis: Das Gateway akzeptiert das Feld (ohne Fehler), gibt es in der Praxis jedoch nicht in session.updated zurück; die Wirksamkeit richtet sich nach der offiziellen Dokumentation und ist bisher nicht durch die Rückmeldung bestätigt.null
erforderlich
Sprachaktivitätserkennung. Bei Transkriptionssitzungen muss sie
null sein.object
Optionale Rauschunterdrückungskonfiguration, z. B.
{ "type": "near_field" } (Nahfeld, geeignet, wenn sich das Mikrofon nah am Sprecher befindet) oder { "type": "far_field" } (Fernfeld).Sprachcodes (language codes)
Die Werte vonlanguages / language folgen dem nachstehenden Format, sind groß-/kleinschreibungssensitiv und müssen einer der unten unterstützten Formen entsprechen; das Übergeben nicht unterstützter oder falsch formatierter Codes wird von der Realtime-API abgelehnt:
Audio senden
Zerlegen Sie das PCM16-Audio in kleine Segmente (z. B. je 100ms), kodieren Sie sie in base64 und senden Sie sie fortlaufend über das Ereignisinput_audio_buffer.append:
input_audio_buffer.commit-Frame senden, um das Ende dieses Segments zu markieren, den Abschluss der Transkription auszulösen und das completed-Ergebnis zurückzugeben:
Transkriptionsergebnisse empfangen
Der Server sendet fortlaufend Ereignisse; die wichtigsten Ereignistypen:event
Bestätigung der Sitzungserstellung bzw. der Konfigurationsaktualisierung.
event
Inkrementelles Transkriptionsergebnis, das Feld
delta ist das neu hinzugekommene Textsegment. Wird während des Sprechens zurückgegeben, geeignet für die Echtzeitanzeige.event
Ein Sprachabschnitt ist fertig transkribiert, das Feld
transcript ist der vollständige Text dieses Abschnitts.event
Fehlerereignis, enthält Fehlercode und Beschreibung.
Vollständiges Beispiel
Nachfolgend werden zwei Schreibweisen gezeigt, wählen Sie eine davon:- Offizielles OpenAI SDK (empfohlen): Kein manuelles Schreiben von WebSocket erforderlich, richten Sie einfach
websocket_base_url(der WebSocket-Basisadressparameter des SDK) auf das Gateway aus, um die offizielle Bibliothek weiterzuverwenden. - Natives websockets: Ohne SDK-Installation direkt Frames gemäß Protokoll senden und empfangen, mit minimalen Abhängigkeiten und einfacher Fehlersuche.
Warum übergibt das offizielle Demo den Modellnamen nicht, wir aber schon? Der Transkriptions-Intent von OpenAI legt das Modell in
transcription.model von session.update ab, die Verbindungs-URL trägt nur ?intent=transcription. Beim AiHubMix-Gateway ist es anders: Der Modellname muss in der Handshake-URL erscheinen (?model=gpt-live-transcribe), denn das Gateway benötigt ihn genau im Moment des WebSocket-Handshakes, um den Modellanbieter auszuwählen, zu authentifizieren und das Kontingent zu reservieren, während session.update erst nach Abschluss des Handshakes eintrifft und dafür zu spät kommt. Deshalb müssen Sie bei Verwendung des SDK dem connect() explizit model übergeben (das SDK hängt es an die URL-Query an); fehlt es, antwortet das Gateway bereits während des Handshakes mit 400 missing_model_parameter: connect() wirft direkt eine Exception, die Verbindung kommt gar nicht zustande und der Schritt session.update wird nie erreicht. Innerhalb der Sitzung muss transcription.model weiterhin mit der URL übereinstimmen.Laufverhalten (produktiv getestet)
Nachfolgend die tatsächlichen Laufergebnisse des obigen Beispiels in der Produktivumgebungaihubmix.com (Modell gpt-live-transcribe). Konfiguriert wurden languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" }:
In der Praxis wurden
languages, prompt, keywords und noise_reduction vom Server allesamt in session.updated unverändert zurückgegeben, was zeigt, dass die Konfiguration tatsächlich wirksam ist (nicht nur akzeptiert, aber unverarbeitet). Das Feld delay wird vom Gateway akzeptiert, aber nicht zurückgegeben; die Wirksamkeit richtet sich nach der offiziellen Dokumentation. Von language (Singular) und languages (Plural) darf nur eines übergeben werden.Abrechnungshinweise
- Stückpreis:
gpt-live-transcribewird mit $0.017 / Minute abgerechnet (maßgeblich ist der aktuelle Listenpreis auf der Modell-Detailseite). - Die Abrechnung erfolgt nach der transkribierten Audiodauer: maßgeblich sind die tatsächlich an das Transkriptionsmodell weitergeleiteten Audiosekunden, aufgerundet auf ganze Sekunden. Beispiel: Bei der Transkription von 90 Sekunden Audio werden
90 ÷ 60 × $0.017 = $0.0255berechnet. - Die Abrechnung wird nicht durch Netzwerk-Roundtrips oder Leerlaufzeiten beeinflusst, sondern misst nur das tatsächlich zur Transkription zugeführte Audio.
- Laufende Abrechnung: Dies ist eine dauerhafte Verbindung, die Kosten werden nicht erst am Ende der Sitzung auf einmal abgerechnet, sondern während der Sitzung segmentweise in Echtzeit abgezogen. Beim Aufbau der Sitzung wird zunächst eine Kontingentreservierung in Höhe von etwa 1 Minute Verbrauch vorgenommen (nur als Zugangsprüfung, kein tatsächlicher Abzug); während der Sitzung wird die Reservierung alle 20 Sekunden rollierend verlängert, die tatsächlichen Kosten werden segmentweise nach den real weitergeleiteten Sekunden abgezogen, und nach Sitzungsende wird die verbleibende Reservierung freigegeben. Daher muss das verfügbare Guthaben des Kontos für mindestens etwa 1 Minute Verbrauch ausreichen, damit die Sitzung aufgebaut werden kann.
- In den Verbrauchsdetails unter Nutzung und Abrechnung weist die Anmerkung jedes Echtzeittranskriptions-Eintrags den „Stückpreis pro Minute” und die „diesmal berechneten Sekunden” aus, was die einzelne Abstimmung erleichtert.
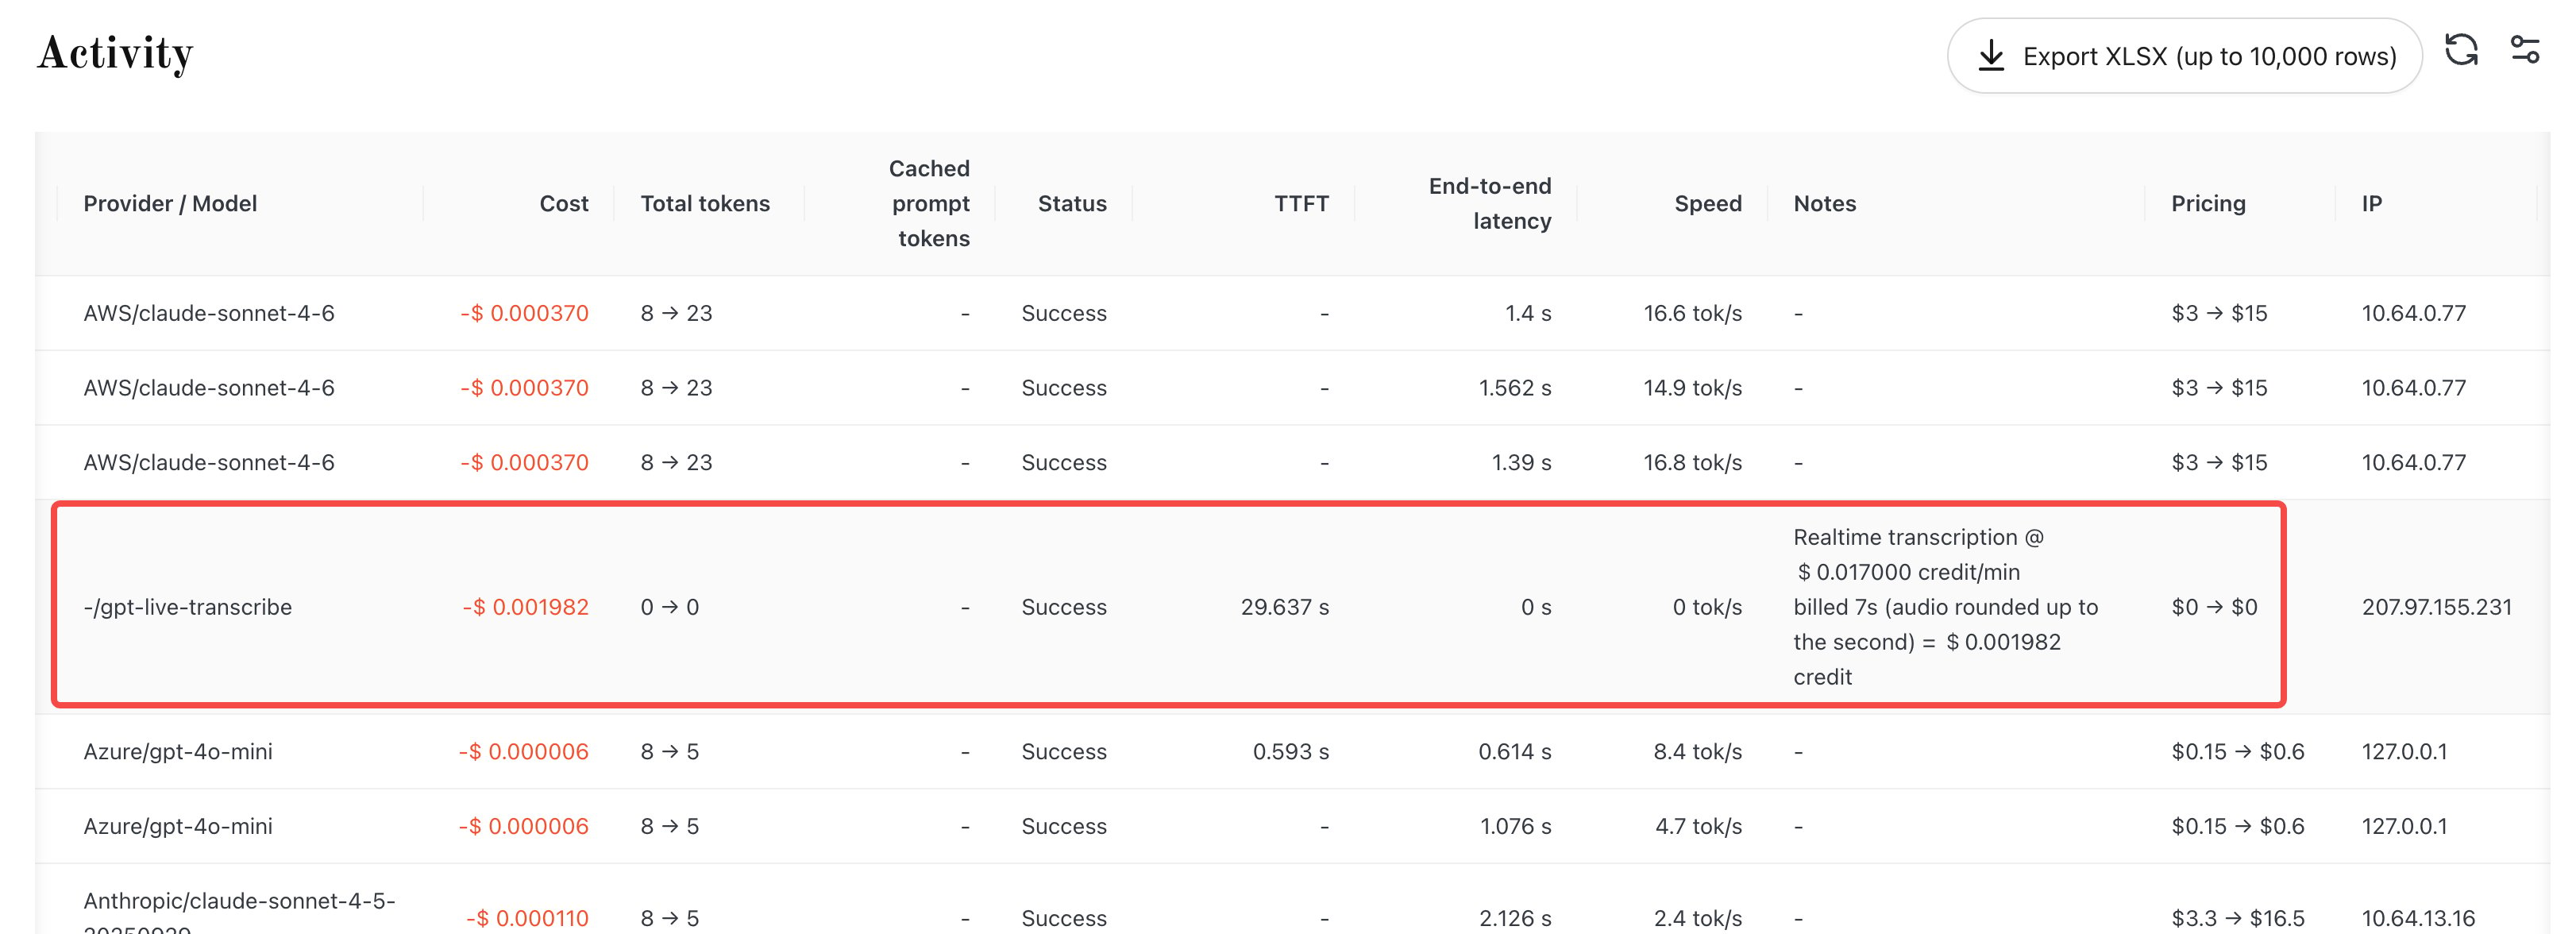
Ein gpt-live-transcribe-Echtzeittranskriptions-Abrechnungseintrag in der Activity-Ansicht von Nutzung und Abrechnung; die Anmerkung weist 7 s Audio zu $0.017 / Min. = $0.001982 aus und entspricht dem oben beschriebenen Format.
Einschränkungen und Auflagen
- Dauer einer einzelnen Sitzung: Eine WebSocket-Verbindung dauert maximal 62 Minuten, danach schließt der Server sie aktiv; wenn Sie länger benötigen, teilen Sie die Verbindung auf und verbinden sich erneut.
- Unzureichendes Guthaben: Es gibt zwei Fälle. Beim Aufbau der Sitzung: Reicht das verfügbare Guthaben nicht aus, um die Reservierung von etwa 1 Minute abzudecken, wird der Handshake direkt abgelehnt (HTTP 403), und die Sitzung kommt nicht zustande. Während der laufenden Sitzung: Wird das Guthaben aufgebraucht (festgestellt bei der Verlängerungsprüfung alle 20 Sekunden oder bei der Nachprüfung nach segmentweisem Abzug), wird die bereits aufgebaute Verbindung sofort geschlossen.
- Nur serverseitig: Direkte Browser-Verbindungen werden nicht unterstützt (der
Origin-Header wird geprüft), bitte serverseitig integrieren. - Modellsperre: Das Modell wird in der Verbindungs-URL fest vorgegeben; der Versuch, das Modell während der Sitzung über
session.updatezu ändern, wird abgelehnt und die Sitzung geschlossen. - Formatsperre: Es wird nur
audio/pcm@24000in Mono unterstützt, andere Formate werden abgelehnt.
Häufige Fehler
Zuletzt aktualisiert: 2026-09-16