

介绍
实时语音转录通过 WebSocket(一种在客户端与服务端之间保持长连接、可双向推送数据的协议)建立持久连接,将持续输入的音频流边接收、边转写、边返回,适合对延迟敏感的语音场景。 它与文件转录 STT 的区别:
可用模型:
- gpt-live-transcribe —— 流式转录模型,支持多语言,随音频输入实时输出转写文本。
快速开始
连接端点
intent=transcription—— 必填,声明这是一条转录会话。model=gpt-live-transcribe—— 必填,模型在连接时由 URL 参数定死,会话中不可再更改(见下方约束)。
鉴权
握手时通过标准 HTTP 头传入密钥:音频格式要求
当前仅支持一种输入格式,发送前请将音频转换为:- 编码:PCM16(16 位有符号整数,小端序)
- 采样率:24000 Hz
- 声道:单声道(mono)
audio/pcm@24000。发送非该格式(如 G.711/µ-law)会被拒绝并关闭会话。
转录会话不支持语音活动检测(turn_detection / VAD),必须显式设为
null。若省略或传非 null 值,模型推理厂商会以 invalid_value 拒绝转录。网关会对转发的配置强制把 turn_detection 置为 null,但仍建议你在客户端主动设为 null 以保持行为清晰。会话配置(session.update)
连接建立后,客户端先发送一帧session.update 配置转录参数。若你不发送,网关会用授权模型注入一份默认配置兜底,但推荐显式配置。
配置参数
string
必填
会话类型,转录场景固定为
transcription。object
必填
输入音频格式,固定为
{ "type": "audio/pcm", "rate": 24000 }。string
必填
转录模型。必须与连接 URL 的
model 一致(gpt-live-transcribe)。传入其它模型视为越权,会话将被以 1008 关闭。string[]
预期语言列表,数组形式(如
["en", "zh"])。gpt-live-transcribe 用复数 languages,可一次声明多种语言;指定语言能提升准确性并降低延迟。取值字典见下方 语言代码。string
单数写法,单个 ISO-639-1 代码(如
"en")。与 languages 二选一,不要同时传(同时传会被以 invalid_value 拒绝)。官方对 gpt-live-transcribe 推荐用复数 languages;单数 language 网关也接受,便于从旧代码迁移。string
自由文本提示,描述录音场景(如「客服通话」「含医学术语的问诊」),帮助模型贴合语域。实测服务端会在
session.updated 中原样回显,已生效。string[]
字面提示词数组,用于产品名、缩写、专有名词等易错词(如
["AiHubMix", "gpt-live-transcribe"])。它是提示而非强制输出;每个词单独一项,避免包含 <、>、换行符。实测已回显生效。string
延迟 / 准确率档位,可选值
minimal、low、medium、high、xhigh——档位越高越准但延迟越大。注意:网关接受该字段(不报错),但实测未在 session.updated 中回显,生效性以官方文档为准、暂未由回显确认。null
必填
语音活动检测。转录会话必须为
null。object
可选的降噪配置,如
{ "type": "near_field" }(近场,适合麦克风贴近说话人)或 { "type": "far_field" }(远场)。语言代码(language codes)
languages / language 的取值遵循以下格式,大小写敏感、必须是下方支持的形式,传入不支持或格式错误的代码会被 realtime API 拒绝:
发送音频
将 PCM16 音频切成小片(如每 100ms 一片),base64 编码后通过input_audio_buffer.append 事件持续发送:
input_audio_buffer.commit 标记该段结束,触发转录收尾并返回 completed 结果:
接收转录结果
服务端会持续推送事件,关键事件类型:event
会话创建、配置更新的确认。
event
转录增量结果,字段
delta 是本次新增的文字片段。边说边返回,适合实时上屏。event
一段语音转录完成,字段
transcript 是该段的完整文本。event
错误事件,包含错误码与说明。
完整示例
下面给出两种写法,任选其一:- OpenAI 官方 SDK(推荐):无需手写 WebSocket,把
websocket_base_url(SDK 的 WebSocket 基址参数)指到网关即可复用官方库。 - 原生 websockets:不装 SDK,直接按协议收发帧,依赖最少、便于排查。
为什么官方 demo 不传模型名,我们却要传? OpenAI 的转录 intent 把模型放在
session.update 的 transcription.model 里,连接 URL 只带 ?intent=transcription。AiHubMix 网关不同:模型名必须出现在握手 URL(?model=gpt-live-transcribe)——因为网关在 WebSocket 握手那一刻就要用它选择模型推理商、鉴权、预留额度,而 session.update 是握手完成之后才到、来不及。所以用 SDK 时要给 connect() 显式传 model(SDK 会把它拼进 URL query);缺了它网关在握手期就回 400 missing_model_parameter——connect() 直接抛异常、连接根本建不起来,压根进不到 session.update 那一步。会话内 transcription.model 仍需与 URL 一致。运行效果(线上实测)
以下为上述示例在aihubmix.com 线上环境(模型 gpt-live-transcribe)的真实运行结果。配置了 languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" }:
实测中
languages、prompt、keywords、noise_reduction 均被服务端在 session.updated 中原样回显,说明配置已实际生效(并非仅接受不处理)。delay 字段网关接受但不回显,生效性以官方文档为准;language(单数)与 languages(复数)二者只能传其一。计费说明
- 单价:
gpt-live-transcribe按 $0.017 / 分钟 计费(以模型详情页实时挂牌价为准)。 - 按转录的音频时长计费:以实际转发到转录模型的音频秒数为准,向上取整到整秒。例如转录 90 秒音频,计费
90 ÷ 60 × $0.017 = $0.0255。 - 计费不受网络往返或空闲等待影响,只对真正送入转录的音频计时。
- 边用边结算:这是一条长连接,费用不是等会话结束才一次性结算,而是在会话过程中分段实时扣除。建立会话时会先按约 1 分钟用量做一次额度预留(仅作准入校验,不是真实扣费);会话中每 20 秒滚动续期一次预留,实际费用按真实转发秒数分段扣除,会话结束后释放剩余预留。因此账户可用余额至少要够约 1 分钟的用量,会话才能建立。
- 在 用量与账单 的消费明细里,每条实时转录记录的备注会标注「每分钟单价」与「本次实收秒数」,方便逐条核对。
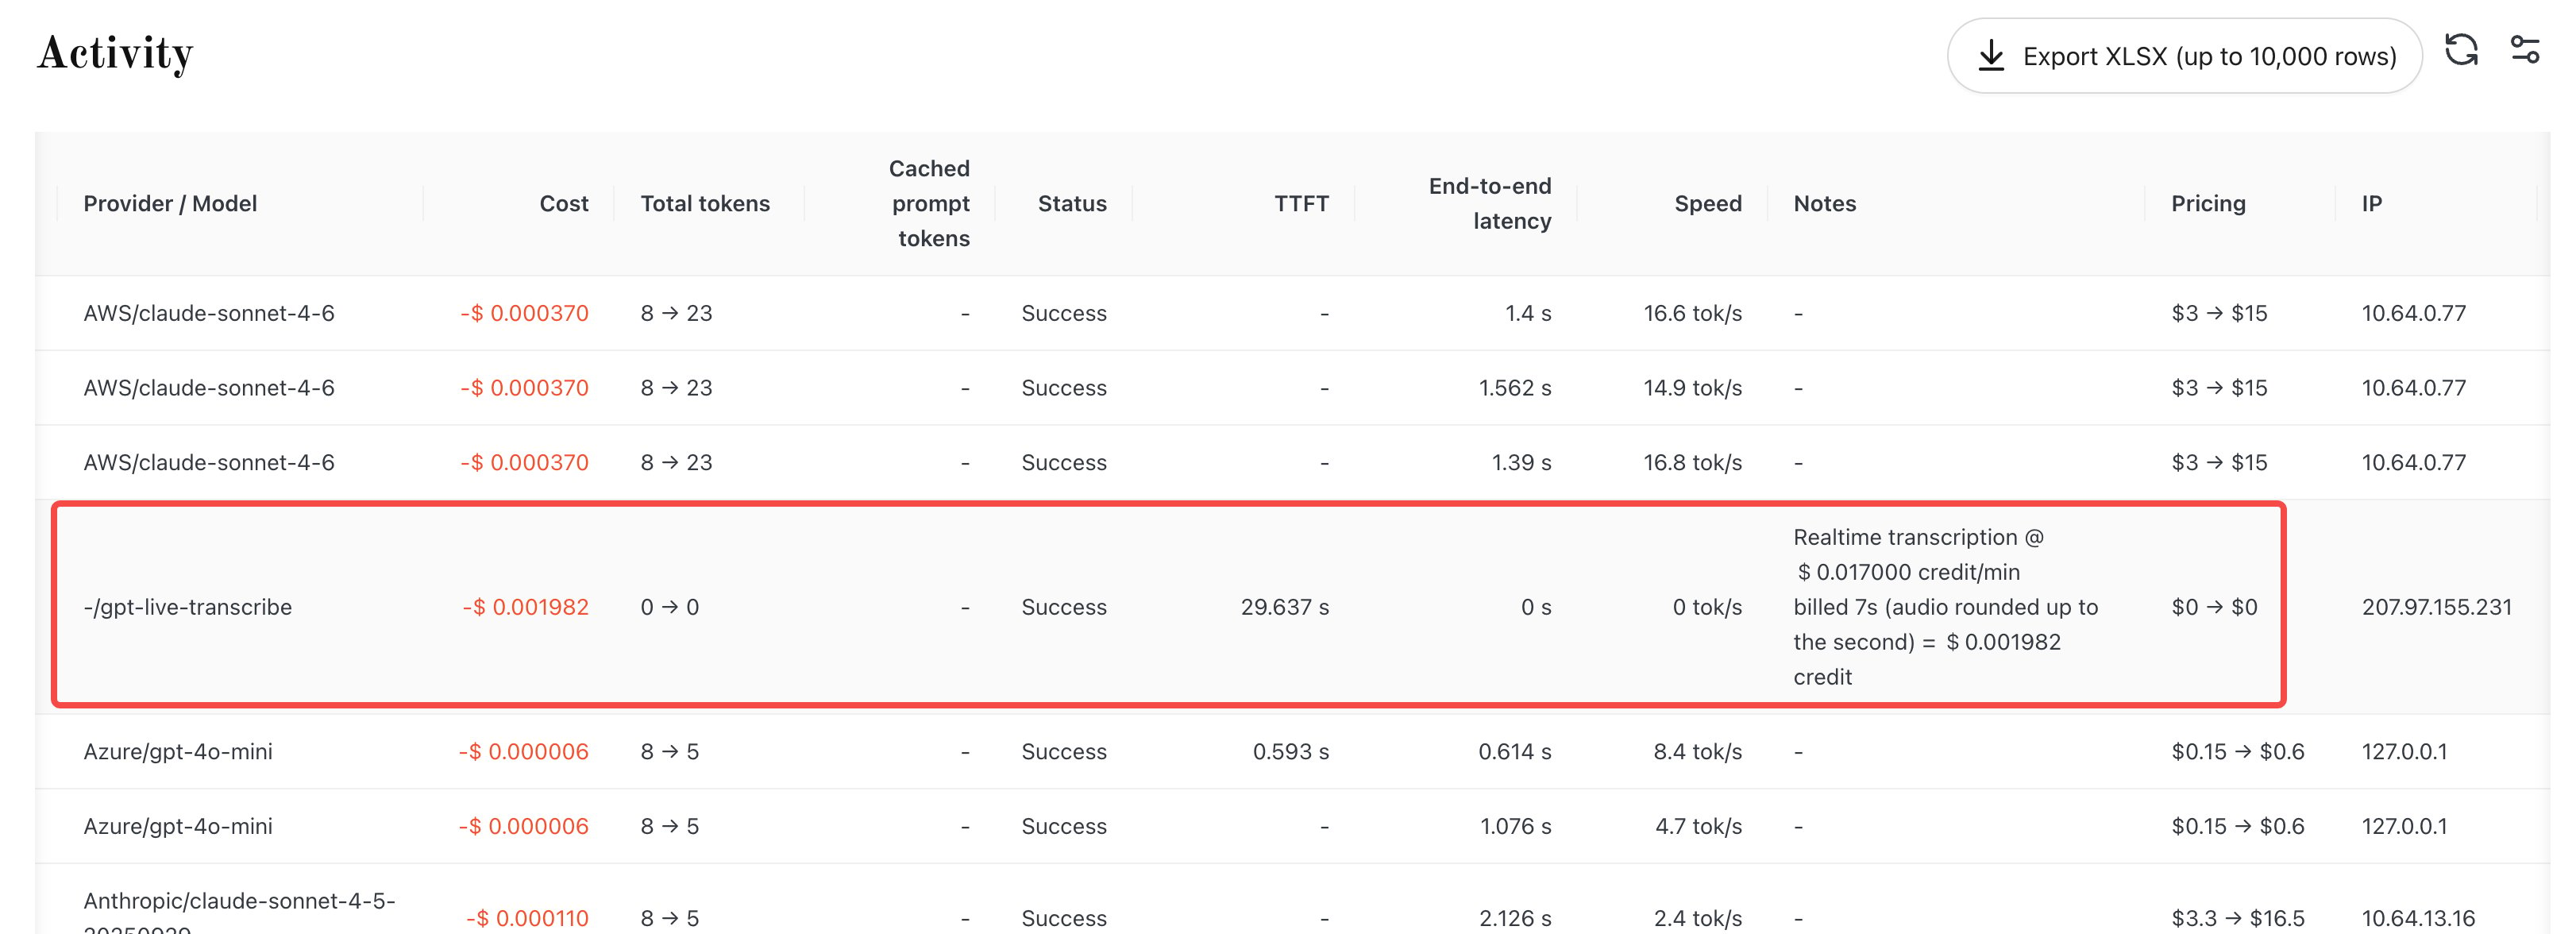
用量与账单 Activity 中的一条 gpt-live-transcribe 实时转录计费记录,备注标注按 7 秒音频 × $0.017 / 分钟计费,实收 $0.001982,与上文口径一致。
限制与约束
- 单会话时长:一条 WebSocket 连接最长 62 分钟,到时服务端主动关闭;需要更长请分段重连。
- 余额不足:分两种情况——建立会话时可用余额不足以覆盖约 1 分钟的预留额度,握手直接被拒(HTTP 403),会话不会建立;会话进行中若余额耗尽(每 20 秒的续期校验或分段扣费后复查发现),已建立的连接会被立即关闭。
- 仅服务端:不支持浏览器直连(校验
Origin头),请在服务端集成。 - 模型锁定:模型在连接 URL 定死,会话中通过
session.update改模型会被拒绝并关闭会话。 - 格式锁定:仅支持
audio/pcm@24000单声道,其它格式会被拒绝。
常见错误
更新时间:2026-09-16