

2026 年
新增模型
- 新增
claude-haiku-5-5:Anthropic 面向高吞吐、成本敏感任务的模型,适用于摘要、上下文压缩、数据库查询、分类和编程子智能体工作流。
新增模型
- 新增
gemini-nano-banana-2.1:Google 高效图像生成与对话式编辑模型,相比 Nano Banana 2 提升画质、提示词遵循、多轮角色一致性与文字渲染,保持 Flash 级响应速度。
新增模型
- 新增
doubao-seedream-5-0-flash:字节跳动快速图像生成与编辑模型,支持精准编辑、图层分离和透明背景输出,适合高频批量生图与快速交互。
Realtime 对话支持图片输入
gpt-realtime-2.1的 Realtime 对话支持 PNG/JPEG/WebP 图片输入,可结合文本构建实时对话。gpt-realtime-2.1已在生产环境模型名单中可用,可接入文本与图片的实时对话。
新增模型
- 新增
claude-opus-5-5:Anthropic 旗舰模型,适用于智能体编程、大型代码库、计算机操作和复杂任务。 - 新增
gpt-6-sol:OpenAI 面向复杂编程、智能体工作流和长上下文推理的模型,支持文本与图像输入、105 万 token 上下文及最高 128K 输出。 - 新增
gpt-6-luna:OpenAI 面向聚焦任务与高并发工作负载的高效模型,支持文本与图像输入、105 万 token 上下文及最高 128K 输出。
新增模型
- 新增
mimo-v2.6-flash:小米原生多模态高效模型,适合高频调用和大规模专业任务。 - 新增
mimo-v2.6-pro:小米原生多模态旗舰推理模型,适合复杂项目、编程、研究和长期智能体任务,支持 100 万 token 上下文。 - 新增
mimo-v2.6-pro-ultraspeed:小米面向低延迟场景的 Pro 高速版本,输出速度最高提升至 20 倍。 - 新增
grok-4.7:xAI 面向编程、智能体任务和专业知识工作的旗舰模型,增强自我校验与长上下文处理能力。
新增模型
- 新增
step-5-preview:阶跃星辰面向实际任务的新一代旗舰预览模型,尤其适合编程和专业知识工作。
新增模型
- 新增
jev-latest:TypeSafe 的结构化决策模型,可快速返回类型化选择,适合路由和分类等任务。 - 新增
qwen3.8-omni-flash:阿里巴巴通义千问原生多模态模型,面向音视频分析与智能体,支持文本、图像、音频和视频输入及 100 万 token 上下文。 - 新增
glm-5.3-flashx:智谱 Z.AI 面向编程智能体和实时工作流的高速模型,支持 100 万 token 上下文及图像、视频理解。
新增模型
- 新增
union-alpha-free:可免费试用的多模态模型,适用于研究、编程和智能体工作流,支持文本与图像输入及 262K token 上下文。
实时语音转录上线(gpt-live-transcribe)
新增模型
- 新增
gpt-live-transcribe:OpenAI 实时低延迟语音转录模型,通过 WebSocket 长连接边说边出文字(delta增量 +completed完整文本),按转录音频时长计费 $0.017 / 分钟。
新增功能:实时语音转录
- 新增实时语音转录接口,基于 WebSocket 长连接
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe,支持 OpenAI 官方 SDK 与原生 websockets 两种接入方式。 - 音频采用 PCM16 / 24kHz / 单声道,通过
input_audio_buffer.append分块推送、input_audio_buffer.commit触发转录收尾;支持多语言(languages)、场景提示(prompt)、关键词偏置(keywords)与降噪(noise_reduction)配置。 - 详见 实时语音转录 文档。
Gemini 流式工具调用兼容性提升
- Gemini 流式响应中,只要本次流出现过工具调用,结束原因会正确返回为
tool_calls,即使最后一个 chunk 只包含文本或结束标记。 - 依赖
finish_reason判断是否执行工具调用的 OpenAI 兼容客户端,更不容易把工具调用流程误判为普通对话结束。
模型能力元信息更完整
/api/v1/models可在模型资料源提供时返回思考内容的协议载体信息,帮助下游模型目录和 SDK 判断思考内容应从哪个响应字段读取。- 资料源尚未提供时字段保持缺席,不改变现有调用行为。
用户通知邮件更稳
- 欢迎邮件、额度提醒、发票、自动充值到账和渠道封禁通知会与验证码、密码重置邮件分开投递,降低业务通知挤占认证邮件发送额度的风险。
媒体兼容性更新
多轮推理兼容性提升
- Cerebras 模型在多轮对话中会更稳定地保留历史推理内容,减少续问或工具闭环时因字段格式不兼容导致的 400 错误。
- Chat、Responses 和 Messages 入口的推理历史处理口径更一致;其他供应商请求不受影响。
MAI 图片编辑更稳定
- 旧版
/v1/images/edits通过 MAI 图片模型编辑时,会走编辑端点而不是生成端点,避免图片编辑请求被错误转发。 - MAI 图片模型的生成与编辑路径配置更清晰,
mai-image-2.5、mai-image-2.6和 Flash 版本相关编辑链路更易验收和排查。
媒体失败提示更可操作
- 图片、视频和异步媒体任务遇到供应商不可用、模型未开通或部署不存在等场景时,会返回更贴近用户理解的展示文案,同时保留原有错误码、HTTP 状态、重试和计费行为。
- 即时接口、任务详情、任务列表和 webhook 的失败文案更一致,客服可继续依据 request 或 task ID 定位问题。
Responses 图片工具计费与 Azure 部署更稳
图片工具调用更稳定
- 通过 Responses 使用
image_generation工具时,Azure 图片部署会尊重模型映射中填写的部署名,包括gpt-image-2.5-*这类带点号的名称,减少因部署名被改写导致的 404。 - 多个图片工具映射到同一部署但计费模型不一致时,请求会收到明确错误,避免消费记录归属不清。
图片消费记录更易核对
- 按 token 计费的图片工具会在消费记录中保留文本输入、图片输入和图片输出 token 依据,方便对照上游账单与用户侧消费明细。
- 显式配置为 0 费率的免费图片模型会继续保持免费结算,不会回退为按张收费。
Qwen 3.8 27B 视觉语言模型上线
新增模型
- 新增
qwen-3.8-27b:阿里巴巴开源的稠密视觉语言模型,原生支持文本、图像和视频理解。基于 Qwen3.5 架构,提升编码、专业任务、研究任务和长周期复杂工作流能力,支持 131K token 上下文和灵活的认知控制。
GPT Image 2.5 上线与媒体体验优化
新增模型
- 新增
gpt-image-2.5-flare:OpenAI 图像模型,适合快速完成日常高质量生图,支持文本与图像输入、图像输出,以及 low、medium、high、xhigh、max 和 auto 六种质量设置。 - 新增
gpt-image-2.5-sunburst:OpenAI 图像生成与编辑模型,适合对编辑精度要求较高的工作流,支持文本与图像输入、图像输出,以及 low、medium、high、xhigh、max 和 auto 六种质量设置。
图片结算兜底更可靠
- 当上游图片 usage 缺少
InputTokensDetails时,平台会继续使用可用输入用量结算,不再把有效输入误记为 0;消费记录与相关日志保持同一口径。 - 完整 usage 明细仍优先按上游明细结算。
公开模型信息更一致
- 模型信息接口现在只返回公开字段,已停用接入不会继续混入公开数据;模型详情和可用参数展示更稳定。
- 性能指标按实测结果回写,减少模型页面与接口展示过期指标的情况。
媒体错误提示更清晰
- 图片、视频和异步媒体任务会使用统一的公开错误码、HTTP 状态和可操作提示,区分模型不可用、输入不合法、格式不支持、上游拒绝和结果过期等场景。
- 列表、详情和 webhook 的错误语义更一致;响应不会暴露上游原文、媒体内容或内部配置细节。
Playground 模型端点筛选更准确
- Playground 现在会按协议版本筛选模型端点,其他协议版本的入口不会混入当前列表。
- 选择模型和端点时更少出现协议不匹配导致的调用失败。
旧版 Claude system 兼容性提升
- 旧版 Claude 模型仍使用
system角色的请求,现在可在 Chat 和 Responses 调用中更稳定地转换处理。 - 兼容路径保留现有消息、缓存和 thinking 相关语义,调用方无需为旧模型单独改写请求。
DeepSeek 多模态试用与临时文件上传
新增模型
- 新增
deepseek-v4.1-flash:DeepSeek 采用新架构的原生多模态内测模型,支持文本与图像输入、文本输出,以及推理、工具调用和结构化输出。当前开放限流试用,仅供测试,不建议用于生产环境。
Gemini usage 缺失时计费更稳
- Gemini 原生透传请求在客户端中断或上游没有返回 usage 时,会基于已下发内容估算输出用量,避免把预扣值误当作最终实收导致异常超收。
- Web Search 和 cachedContent 场景保留现有计费语义;有真实 usage 时仍优先使用上游返回的用量。
模型路由错误更易排查
- 当模型不存在或当前没有可用接入时,错误信息会回显用户原始请求的模型 ID,并引导到模型页复制正确 ID。映射、重定向和 fallback 不会改写这个回显名称,客服和调用方更容易定位失败请求。
GPT 与 Claude 工具调用兼容性更稳
- 推理模型的 Chat 请求在桥接到 Responses 后,会过滤
temperature/top_p等不被目标模型接受的采样参数,减少 gpt-5.6、gpt-6-astra 等模型的 400 错误。 - AWS Bedrock Claude 路径会移除 Bedrock 当前不支持的 advisor 工具声明;其他工具、非 AWS 平台和消息内容保持原样。
新增临时文件上传 API
- 新增
POST /v1/oss/upload,支持通过 API Key 上传单个 50 MB 以内的图片、PDF、文本、音频或视频文件,并返回 15 分钟有效的读取链接。 - 上传接口不单独计费,适合把多模态文件临时托管后交给模型使用;文件类型校验不等同于病毒扫描或所有模型输入兼容保证。
模型标签与 GPT 工具、缓存兼容优化
模型标签显示更一致
- 模型广场、模型详情和
?tag=new列表现在统一按上架时间派生 New 标签;New 会在窗口到期后自动消失,旧的 Hot 标签不再展示。近期上线模型不会因为供应商自绑定数据而丢失 New 角标。
GPT 工具调用兼容性提升
- gpt≥5.5 模型通过
/v1/chat/completions搭配 tools 调用时,会自动走 Responses 兼容路径,减少上游 400 错误;使用 Claude Messages 入口转接这类模型的工具调用也覆盖该兼容口径。 - OpenAI/Azure 直连渠道会过滤不兼容的 reasoning 参数,避免参数方言造成请求失败。
GPT 缓存写计费档位更准确
- GPT 模型含缓存写入的请求会按原始总输入长度选择计费档位,长上下文首轮请求更贴近官方口径;普通输入、缓存写数量和非 GPT 模型计费逻辑不变。
GPT-6 Astra 与 MAI 图像模型上线
新增模型
- 新增
gpt-6-astra:OpenAI 面向复杂推理、编程、计算机操作、研究和文档创作的模型。支持 105 万 token 上下文、最高 128K 输出、从 low 到 max 的推理强度、异步工具调用,以及回合执行中的指令调整(mid-turn steering)。上线公告。 - 新增
mai-image-2.6:Microsoft 的图像生成与编辑模型,支持文生图、多种宽高比生成和图像引导编辑。 - 新增
mai-image-2.6-flash:Microsoft MAI-Image-2.6 的低延迟版本,支持多种宽高比的图像生成和图像引导编辑。
图片高并发调度与媒体错误优化
图片生成请求更稳
- 图片生成、编辑、变体和
gpt-image-2预测请求现在会结合 Azure 返回的限频信息和分布式在途上限调度请求。高并发或上游 429 场景下,平台会更早限流、释放容量并尝试可用渠道,减少图片请求被瞬时流量拖垮的情况。 - 依赖
by-bill图片模型的请求在缺少上游用量字段时会使用统一兜底用量,限流与计费口径更一致;当 Redis 限流组件异常时,图片请求会保守失败并返回错误,避免无限制打到上游。
媒体任务错误返回更一致
/ai/v1、/call/media、任务查询、列表和 webhook 中的媒体任务失败会使用同一套公开错误码和失败快照。调用方看到的 HTTP 状态、error.code与失败原因更一致,便于重试、展示和客服排查。- 上游原文、媒体 URL、data URI、Base64 和内部错误细节不会进入用户可见响应;坏 JSON、未知模型、输入超限或上游拒绝等场景会归类到更明确的公开错误。
长周期 Agent 与多模态模型扩容
新增模型
- 新增
muse-spark-1.3:Meta 面向长周期 Agent、多智能体与复杂编码工作流的多模态推理模型。支持文本、图像、音频和视频输入、文本输出、100 万 token 上下文与最高 100 万 token 输出,以及推理和工具能力。相比 Muse Spark 1.2,它以更少的不必要轮次和工具调用、更精炼的输出,提高长周期 Agent 与编码任务的执行效率。 - 新增
gemini-3.8-flash:Google Flash 系列中智能能力最强的模型,面向长时间运行的软件工程、自主 Agent 与复杂企业工作流。支持文本、图像、音频和视频输入、100 万 token 上下文、最高 65K 输出、推理、联网、工具调用、结构化输出与长上下文。 - 新增
gemini-3.8-flash-free:Gemini 3.8 Flash 的免费试用版本,保留核心多模态与 Agent 能力。免费资源有限、稳定性不保证,使用时可能出现 429;生产环境如需稳定并发,请使用 gemini-3.8-flash。
Claude Fable、Qwen 与创作模型更新
新增模型
- 新增
claude-fable-5-1:Anthropic 面向高强度推理、长周期 Agent、多步研究和文档/表格/幻灯片处理的旗舰模型。支持文本与图像输入、100 万 token 上下文,以及思考、工具调用、代码解释器、Computer Use、记忆工具、结构化输出、引用和提示词缓存;缓存读取价格较 Claude Fable 5 降至四分之一。 - 新增
mercury-2.5-preview:Inception 的扩散式大语言模型预览版,面向高速度文本生成场景。支持 26 万 token 上下文,官方资料强调可并行生成和优化多个 token,标准 GPU 上生成速度可达 1,107 tokens/s;该模型能力标记尚未完整发布,接入前建议做最小调用验证。 - 新增
qwen3.8-max-2026-09-02:Qwen3.8 Max 的 2026-09-02 快照版本,面向复杂工程项目、长程自主开发和多工具协作 Agent 场景。AIHubMix 当前记录为文本输入、约 99.1 万 token 上下文;能力标记尚未完整发布,依赖视觉、工具或结构化输出前需以实测为准。 - 新增
minimax-h3-max:MiniMax H3 系列面向广告、品牌、电商、产品设计、UI/UX 和游戏创意工作流的多模态创作模型。AIHubMix 当前记录支持文本与图像输入;H3 系列资料强调视频、音频和参考编辑能力,具体能力标记尚未完整发布,生产接入前建议先验证目标链路。
模型退役提示与媒体输入优化
模型下线提示更明确
- 调用已下线模型时,API 会返回明确的
model_retired404 错误,而不是笼统的模型不存在提示;如果已配置继任模型,响应头会带上下线和替代模型信息,便于客户端迁移。 - 创建或编辑 Key 时会拒绝已下线模型,智能路由也会避开已下线模型,减少请求落到不可用模型后的失败。
媒体输入错误更可操作
- 图片、视频等媒体输入格式不受支持时,错误会稳定返回
media_form_unsupported,并说明检测到的媒体类型和当前模型可接受的输入形式。 - 同步、异步和回调场景的媒体错误提示保持一致,并避免把 URL、Base64 或内部原因暴露给用户。
Google 图片输入上限临时放宽
- AIHubMix 侧对 Google/Gemini 图片输入的网关校验临时放宽到 20 MB,较大的图片请求不会再被平台提前拦截。
- 由于当前链路仍使用 Google inline media 方式,超过 Google 实际可接受范围的输入仍可能被上游拒绝;大文件调用仍需关注返回错误。
腾讯混元 Hy4 Preview 上线
新增模型
- 新增
hy4-preview:腾讯混元 Hy4 Preview,采用 770B 总参数、49B 激活参数的 MoE 架构,面向 Agent、Coding 与生产力工作流优化。它强化复杂任务中的理解、规划、工具调用与持续执行,适合编码、复杂软件工程、文档处理、信息分析、办公自动化、网页生成及跨工具协作。支持 100 万 token 上下文、最高 64K 输出、推理、联网、工具/函数调用和结构化输出。
Qwen 3.8 Flash 与 MCP 图片工具更新
新增模型
- 新增
qwen3.8-flash:阿里云通义千问的旗舰原生视觉语言模型,适合编程、办公、长上下文推理和 Agent 工作流。支持 100 万 token 上下文、最高 128K 输出,以及思考、联网、工具调用和结构化输出。相比 Qwen3.7-Plus,进一步增强编程与办公能力,并提升训练和推理效率。
MCP 图片工具调用更明确
- MCP 图片生成工具现在要求调用方显式传入模型,避免在未指定模型时被静默使用默认模型。
openai/gpt-image-1是对外展示和转发使用的标准模型 ID;历史拼写错误仍作为兼容输入保留,旧客户端可继续提交但会被规范化处理。
Broadcast、远程 MCP 与 Access Key
新增模型
- 新增
glm-5.3-flash:Z.AI 面向 Coding Agent、复杂推理和长周期软件工程任务的高效率多模态模型。支持文本、图像和视频输入、约 100 万 token 上下文、最高 128K 输出,以及思考、工具调用和结构化输出。模型基于现有 GLM 技术栈进一步后训练和优化,更侧重推理效率与响应速度。
新增功能
- 新增 Broadcast:可将 AIHubMix API 请求的 Trace 自动发送到 LangWatch,无需在应用代码中额外埋点。支持隐私模式、采样率和 API Key 过滤,可在 LangWatch 中查看模型、token 用量、实际计费成本、耗时、会话和 Trace 信息。
MCP 与 Access Key 入口补齐
- 旧版
/mcp/入口可继续按既有鉴权方式使用,并统一到远程 HTTP MCP 能力;旧客户端不需要立即迁移,仍可访问模型、价格、文档检索、余额查询以及聊天、图像和视频工具。 - 控制台将提供只读 Access Key 复制入口,外部 MCP 客户端也可使用
X-Aihubmix-Access-Key请求头;服务端不轮换密钥,不缓存该响应。
图片透明背景请求更稳
gpt-image-2透明背景请求会优先走支持该能力的 OpenAI 原生渠道,减少在不支持透明背景的渠道间连续失败。其他图片请求路径不变。
Agent 文件更新更及时
- 面向 AI Agent 和外部工具的模型清单与指南更新会更及时。
Wan 3.0 上线与 GPT-5.6 Sol 降价
新增模型
- 新增
wan3.0-video:阿里云通义万相预览版 All-in-One 视频模型,整合文生视频、首尾帧图生视频与参考视频工作流,支持最长 30 秒、30 fps 的 480P/720P/1080P 输出,适用于一体化生成与编辑。 - 新增
wan3.0-video-prime:能力对齐的高速版,面向一体化视频生成与编辑工作流,提供更快的端到端生成周转。
GPT-5.6 Sol 价格下调
gpt-5.6-sol已同步官方价格下调 20%,当前价格为输入 20/百万 token。现有调用方式不变,复杂推理、编码和长上下文任务的调用成本降低。
异步媒体任务开通提示更清楚
- 用户未开通异步任务功能时,媒体创建接口会在
async_not_enabled错误中返回对应站点的控制台开通入口。aihubmix、inferera、shkq 用户会被引导到各自控制台,减少 403 后不知道如何开通的问题。
DeepSeek 新版本与图片生成恢复优化
新增模型
- 新增
deepseek-v4-flash-0731-fast:DeepSeek Agent 模型的高速版本,面向编码、工具调用和高并发 Agent 工作负载。它保留 V4 Flash 0731 的能力并提供更快推理;相比 V4 Pro,更侧重低延迟与执行效率。支持 100 万 token 上下文窗口、最高 384K 输出、思考、工具调用和结构化输出。 - 新增
deepseek-v4-flash-vision-exp:DeepSeek 实验性多模态视觉理解模型,支持文本和图像输入、文本输出。适合图像描述、截图 OCR、图表分析和视觉 Agent;纯文本 Agent、推理与世界知识能力与 DeepSeek V4 Flash 正式版保持同级。 - 新增
ox-alpha:由匿名第三方供应商提供的隐身推理模型,真实开发者和所有者尚未披露。AIHubMix 免费提供,支持文本和图像输入、文本输出及 1,048,576 token 上下文窗口,适合编程、长周期软件工程、持续 Agent 工作、复杂推理和图文工作流。
图片生成失败恢复更稳
- 图片生成请求遇到临时服务错误时,自动恢复能力更稳定;当错误明确属于当前模型能力限制时,仍会停止重试并返回清晰原因。使用
gpt-image-2等图片模型时,偶发服务差异导致的直接失败会减少。
Agent 接入与模型广场升级
平台公告
- 上线面向 AI Agent 的接入能力:
agents.md接入说明、站点与每模型llms.txt机读文档、Playground Skill(固定地址分发)、Playground 深链(?models=多模型开局,一条链接开出最多 6 个模型的标签页;?config=配置直达)。需要并排查看两个模型的规格与价格,可用主站对比页https://aihubmix.com/compare/{model_a}/{model_b}。入口清单见 Agent 接入。
图片生成 API 参数与错误更一致
- 图片生成请求对
resolution、imageSize等尺寸参数的处理更稳定;当请求参数不符合当前模型能力时,接口会返回更明确的错误说明,便于调用方快速修正。
模型广场支持主模型与多版本展示
- GLM 5.2、Coding 版和 Free 版这类同一模型的不同形态可按“主模型 + 版本”归并展示。用户浏览模型广场、对比价格和选择版本时,更容易理解它们之间的关系。
异步图片任务处理能力提升
- 异步图片任务可按实时空闲能力并发推进。高峰期排队和处理延迟有望降低,任务状态与结果交付更稳定。
GPT-5.6 Sol 折扣线路与媒体任务优化
新增模型
- 新增
gpt-5.6-sol-disc:AIHubMix 为 OpenAI GPT 5.6 Sol 提供的限时折扣线路,当前最高优惠 50%,底层能力与标准gpt-5.6-sol相同。该前沿推理模型适合复杂编程、专业知识工作、深度研究与长程 Agent,支持文本和图像输入、约 105 万 token 上下文、最高 12.8 万 token 输出,以及思考、工具和结构化输出。
媒体生成任务更稳
- 图片、视频等媒体任务的完成时间、结果过期时间和产物归档口径更一致;滚动发布或高并发场景下,任务状态、下载结果和用户侧记录更不容易出现延迟或重复处理。
- 媒体生产服务容量已提升,较大媒体响应的处理上限也更宽,长耗时或大产物任务的可用性更稳。
Microsoft MAI Thinking 1 上线
新增模型
- 新增
mai-thinking-1:Microsoft MAI 系列推理模型,面向企业级推理、数学、通用智能和高吞吐工作负载。支持 256K 上下文窗口、Chat Completions 与结构化输出,适合需要长上下文推理、稳定响应格式和全天候调用成本控制的业务场景。
Gemini 3.7 Flash 与 Coding GLM-5.3
新增模型
- 新增
gemini-3.7-flash:Google 原生多模态推理模型,面向编程、Agent、Web 开发和知识工作。支持文本、图像、音频和视频输入、100 万 tokens 上下文窗口、可调思考级别、工具调用、联网搜索和结构化输出;相比 Gemini 3.6 Flash,在编程、工具使用、多步规划和指令遵循方面进一步提升。 - 新增
coding-glm-5.3:Z.AI 面向编程与 Agent 工作流的推理模型,适合复杂软件工程、长程 Agent 和漏洞分析。它与 GLM-5.2 使用相同底座,通过扩大后训练规模提升编程、任务执行和 token 效率。当前为限时预览版,仅供测试与评估,服务稳定性不作保证,不建议用于生产环境。
API 兼容性与任务可靠性
- Gemini 原生 embedding 请求现在能正确保留 Gemini Files API 返回的
fileUri所属模型服务来源。使用embedContent/batchEmbedContents搭配已上传文件时,减少因文件来源不一致导致的 403;批量请求引用多个不同来源文件会明确返回 400。 - OpenRouter 返回模型推理厂商结构化错误时,接口错误会优先展示内层
message/param/type,减少难以解析的长文案;单个模型推理厂商的错误也更不容易影响整个 OpenRouter 服务。 - 媒体异步任务的轮询、终态归档和产物处理更稳。图片、视频生成等长耗时任务在高并发、重启或产物较大时,更不容易重复处理、丢失终态或延迟交付;公开 API 字段、状态词和计费公式保持不变。
Grok 4.6 与 DeepSeek V4 Pro 更新
新增模型
- 新增
grok-4.6:xAI 旗舰多模态推理模型,面向编程、长程 Agent、知识工作和交互式应用开发。支持图像理解、500K 上下文窗口、工具调用和结构化输出;相比 Grok 4.5,在多步执行、自我验证、编程和视觉项目生成方面进一步提升。 - 新增
deepseek-v4-pro-0813:DeepSeek 高性能通用推理与 Agent 模型,适合复杂推理、编程、长文档分析和 Agent 工作流。支持思考与非思考模式、100 万 tokens 上下文窗口、最长 384K 输出、工具调用和 Responses API。
Agnes 模型扩容与视频、工具兼容优化
新增模型
- 新增
agnes-2.5-flash、agnes-2.5-pro、agnes-2.5-pro-alpha与agnes-image-2.1-flash。文本与图像类 Agnes 模型现已可通过 AIHubMix 统一入口调用。
Veo 视频时长返回更准确
- Gemini Veo 任务在创建、轮询和结果读取时会更稳定地保留真实视频时长。使用自定义秒数生成视频的用户,看到的任务时长、下载文件时长和后续计费/展示口径会更一致。
Azure Responses 工具调用兼容性提升
- 通过 Azure Responses 使用 namespace 工具时,空白或缺失的 description 不再直接导致 Azure 在模型执行前返回 400。原本可在 OpenAI 官方接口通过的工具调用,更容易在 Azure 上保持一致行为。
模型与供应商页面数据更完整
/call/devs现在支持返回厂商官网字段,模型聚合页和供应商页面可在数据补齐后展示 Official site 入口。/providers/<slug>厂商页也补齐了边缘缓存策略,页面响应会更稳定。
Gemini 异步交互与多协议兼容优化
Gemini interactions 支持异步任务
- Gemini interactions 请求现在可显式使用
background: true走异步任务,并通过返回的任务 ID 查询状态、取消或清理任务。长耗时的多模态/omni 交互更适合接入,不必保持同步连接等待完成。 - 异步任务按真实用量结算,并补齐 token 分列、取消全额释放和长响应保护。用户控制台里的消费记录、余额预扣与最终扣费更一致。
Claude Messages 桥接 thinking 兼容性提升
- 通过 Messages 协议调用 OpenAI 兼容模型提供方时,模型返回的 thinking/reasoning 内容会被保留,并可在后续多轮中回传。使用 Claude SDK、tools 多轮和 DeepSeek thinking 模式的应用更不容易遇到空响应、400 或思维链上下文丢失。
- 无签名 thinking 块在切换到原生 Claude 服务时会被兼容处理,减少多模型 fallback 或桥接链路中的格式错误。
Doubao 视频素材提示词兼容性提升
- 调用豆包视频模型时,
prompt与extra_body.content中的参考素材可以一起生效;仅素材内容的请求会保留提示词与素材顺序。 - 创建响应中的尺寸与提示词信息更贴近实际下发内容,并继续忽略暂未支持的原生字段,减少 SDK 额外参数导致的视频生成失败。
Seedance 2.5 音视频生成上线
新增视频生成模型
- 新增
doubao-seedance-2-5-260628:ByteDance Seed 新一代统一多模态音视频生成模型,可一次生成最长 30 秒的音视频同步内容,并支持多轮延展。相比 Seedance 2.0,它在叙事、转场、参考素材支持、真实感和精准编辑方面进一步提升,适合影视制作、广告、教育、仿真和长内容创作。
Wan 3.0 与 Qwen Image 3.0 上线
新增模型
- 新增
wan3.0-video:阿里通义实验室推出的一体化视频生成与编辑模型,目前处于公测阶段。它支持最长 30 秒的原生视频生成、生产级角色一致性、逼真的画面与声音,以及统一的参考生成、编辑、复刻和动作驱动工作流,适合广告、电商、影视制作、角色动画、视频编辑和文档转视频。 - 新增
qwen-image-3.0:阿里云通义千问团队的图像生成与编辑模型,支持文生图、参考图创作和图像编辑。兼顾画质与速度,适合社交媒体、电商、创意设计、日常内容生产以及高频大规模创作。 - 新增
qwen-image-3.0-pro:阿里云通义千问旗舰级图像生成与编辑模型,面向广告、品牌视觉、UI、演示、产品图和专业设计场景。擅长复杂版式、精准的中英文字渲染、真实材质、参考图编辑,以及细节、构图和商业级视觉品质。
多模态 Embedding 与 Seedance 调用优化
Gemini embedding 支持多模态输入与分模态计费
gemini-embedding-2-preview现在可以通过 OpenAI 兼容 embeddings 入口和 Gemini 原生入口处理文本、图片、音频、视频和文档输入。使用多模态向量检索、内容理解或知识库构建的用户,可在同一模型上接入更多输入类型。- Gemini embedding 的费用会优先按模型推理厂商返回的分模态 token 用量计算;图片、音频、视频和文档不再被统一当作文本估算。多模态 embedding 账单更贴近真实用量。
- 单条 embedding 请求可直接使用新一代 Gemini embedding;包含多条输入的批量请求会明确返回能力不支持的提示。
Seedance 2.0 视频生成调用更稳定
- Seedance 2.0 的图片、音频、视频等引用会按媒体类型更准确地映射,
adaptive、4K、尺寸等能力约束更清晰。视频生成工作流中因参数映射不准导致的失败会减少。 - 自适应时长请求会先按 15 秒预扣,并在任务完成后按真实时长结算;用户余额预扣和最终账单更一致。
- 媒体生成失败时,接口会返回脱敏后的错误信息,方便用户和客服定位参数、签名链接或模型推理厂商限制问题,同时避免暴露敏感凭证。
Qwen 3.8 Max 与供应商展示优化
新增模型
- 新增
qwen3.8-max:阿里云旗舰原生视觉语言模型,基于 2.4 万亿参数的 Mixture-of-Experts (MoE) 架构,最大上下文窗口达 100 万 tokens。适合复杂多模态理解、高阶推理、软件开发、agent 工作流以及长上下文处理。与 Qwen3.7-Max 价格相近,在推理、编码和 agent 能力上均有明显提升,整体表现对齐当前主流领先模型。
模型详情中的供应商可用性更清晰
- 模型详情会优先展示当前更适合调用的供应商,并把仅作备用或暂不可用的供应商放到后面。用户选择模型供应商、客服排查模型可用性时,可以更直观看到哪些供应商当前更适合使用,减少因展示顺序过期带来的误判。
DeepSeek、MiniMax 更新与模型优惠
新增模型
- 新增
deepseek-v4-flash:面向效率优化的 Mixture-of-Experts 模型,总参数 284B,激活参数 13B,上下文窗口 100 万 tokens。为快速推理和高吞吐场景设计,同时保留强劲的推理与编码能力,适合编码助手、聊天系统和 agent 工作流。
新增视频生成模型
- 新增
minimax-h3:MiniMax 的通用多模态视频模型,支持文本、图像、音频和视频输入,可用于文生视频、图生视频、首尾帧生成、参考素材生成和视频编辑。需要搭建视频创作、广告素材、产品演示或多模态内容工作流的用户,可以通过 AIHubMix 统一接口接入。
GLM-5.2 分时段限时特惠
glm-5.2调用价格按每日时段打折,时间以 UTC 为准:每日 14:00 至 24:00 享 5 折,每日 00:00 至 14:00 享 7 折。活动限时。
GPT-5.6 Luna/Terra 价格下调
gpt-5.6-luna已同步官方降价 80%,当前价格为输入 1.20;gpt-5.6-terra已同步官方降价 20%,当前价格为输入 12.00。对这两个模型有稳定调用量的用户,可重新评估成本敏感和通用任务的模型选择。
官方 MCP 服务开放接入
AIHubMix 官方 MCP Server 上线
- 新增面向 MCP 客户端的官方托管入口 mcp.aihubmix.com/mcp 或 mcp.inferera.com/mcp。支持在 Claude Code、Codex、Cursor 等工具中通过同一入口查询模型与价格、检索文档、查看余额,并调用聊天、图像生成和视频生成等工具能力。
- MCP 请求凭证由客户端逐次传入,服务端不保存 API Key;适合希望在 IDE 或 Agent 工具里直接使用 AIHubMix 模型和媒体能力的开发者。
Jina Reranker V3.5 上线
新增模型
- 新增
jina-reranker-v3.5:Jina AI 的 0.6B 多语言 listwise 文档重排模型,可作为jina-reranker-v3的同接口升级版本。它面向 RAG、搜索和结构化资料排序场景,支持长上下文候选排序,并提升领域鲁棒性、多语言检索、结构化数据排序和推理效率。
Claude Opus 5 上线
新增模型
- 新增
claude-opus-5:Anthropic 旗舰模型,面向高强度推理、编码和长程 agent 任务。擅长端到端软件开发、代码审查与缺陷发现、图表与文档视觉分析、复杂办公交付以及并行子代理协作,具备 1M 上下文窗口,最大输出 128K。
MAI 图像与 Qwen TTS 音频能力更新
新增模型
- 新增
mai-image-2.5-pro:微软旗舰级图像生成与编辑模型,具备高保真写实效果、精准的图内文字渲染以及强大的图像编辑能力,适合商业设计、产品摄影和专业创意工作流。 - 新增
qwen-audio-3.0-tts-flash:通义千问实时语音合成模型,支持更多低资源语言与中文方言,具备丰富的表现力控制,首包延迟低于 200 ms,适合语音助手、实时对话和智能客服。 - 新增
qwen-audio-3.0-tts-plus:通义千问高品质语音合成模型,可精细控制情感、语气、角色、语速、音量与合成风格,并在噪声和混响环境下更稳定,适合内容创作、有声书、影视配音、品牌声音设计及高品质语音服务。
Qwen TTS 音频生成能力
- 两个 Qwen TTS 模型均可通过
/v1/audio/speech调用;非流式请求返回音频结果链接,流式请求返回 SSE 音频生成事件。下表结合 AIHubMix 兼容字段与阿里云官方 Qwen-Audio-TTS 口径整理;voice需按模型分别选择,plus 与 flash 的系统音色不可混用。
Messages 响应兼容性提升
- 通过
/v1/messages调用桥接模型或 Claude/Bedrock 等模型服务时,响应字段与 Anthropic Messages 生态更一致,减少严格 SDK 或校验器因缺少响应字段而报错的情况。
AWS Bedrock 流式断连后的用量更完整
- 客户端中途断开 AWS Bedrock 流式请求时,平台会继续收口模型推理厂商结束信号和最终 usage,减少断连场景下请求日志、结算明细和实际模型推理厂商用量不一致的情况。
Qwen3-Coder 与 Gemini 轻量模型扩容
新增模型
- 新增
qwen3-coder-480b-a35b-instruct:Qwen3-Coder 旗舰代码模型,面向代码生成、软件工程 Agent 和工具调用工作流,适合长上下文代码理解与自动化开发任务。 - 新增
gemini-2.5-flash-lite:Google 2.5 系列轻量模型,面向低延迟、低成本的高频文本、多模态和批处理场景。 - 新增
Qwen/Qwen3-235B-A22B-Instruct-2507:Qwen3 235B-A22B Instruct 2507 版本,适合通用对话、指令跟随、多语种与长上下文任务。
Gemini、GLM 扩容与 Qwen 流式修复
新增模型
- 新增
gemini-3.6-flash:Google 最新 Flash 系列模型,适合复杂工作流、计算机使用、图表推理和长上下文任务。 - 新增
gemini-3.5-flash-lite:更轻量、低成本的 3.5 系列模型,适合高吞吐、日常自动化和批量处理场景。 - 新增
glm-5.2-fast-preview:智谱 GLM-5.2 系列快速预览模型,适合低延迟对话、快速推理和高吞吐应用场景。
Qwen 3.8 流式请求稳定性提升
- 通过
/v1/responses和/v1/messages调用qwen3.8-max-preview的流式请求更稳定;此前可能被误判为empty_stream或 502 的有效流式响应,现在可正常完成。
Gemini、Responses 与分时计费优化
Gemini 图像参数透传
- 通过 OpenAI 兼容的 Chat Completions 调用 Gemini/Vertex 图像输出模型时,现在可在
extra_body.generationConfig.imageConfig中传递aspectRatio和imageSize。
Gemini embedding 计费更贴近真实用量
- Gemini embedding 响应提供真实
usageMetadata时,平台会优先按模型推理厂商返回的 token 用量计费;缺失时仍保留原本地估算兜底。
Responses 动态工具兼容性提升
/v1/responses请求中的 system/developer 消息现在可携带 message-local function tools,并在桥接到 Chat 模型时保留工具声明。依赖 Kimi K3 等动态工具工作流的客户端,工具调用链路更稳定。
Responses stop 参数修复
- 通过
/v1/responses调用会桥接到 Chat 的模型时,stop现在会随请求传给模型推理厂商。单个停止词可正常生效,超过模型推理厂商限制的数量或长度会返回与 Chat Completions 一致的边界错误。
DeepSeek V4 分时段计费支持
- DeepSeek V4 相关模型可按配置支持峰谷分时段计费;预扣与最终结算使用同一请求提交时间口径,跨峰谷边界的流式请求也按提交时刻计价。预扣保护仅作用于配置了分时段计费的模型,避免影响其他普通模型的余额冻结体验。
Qwen 3.8 Max Preview 限时优惠
新增模型
- 新增 qwen3.8-max-preview:
限时福利:Qwen3.8-Max-Preview 调用价格按 1 折计算,相当于用量直接扩大 10 倍,活动限时,先到先用。
Qwen3.8-Max-Preview 是通义千问系列最新一代基座模型,参数量达 2.4T,并仍在持续进化中。相较上一代旗舰 Qwen3.7-Max,它在代码工程(Coding)、专业办公(Cowork)等核心能力上实现显著提升,在全栈开发、数据分析、Office 办公工作流等复杂长程任务中展现出全球领先的综合能力。
Kimi K3 与混元 3D 生成上线
新增模型
- 新增
kimi-k3:Kimi K3 是 Moonshot AI 发布的开放 3T 级长上下文模型,采用 2.8T 参数、1M 上下文窗口,并原生支持视觉输入,适合长程编码、知识工作、复杂推理和多模态理解场景。调用方式见 Kimi K3 实测调用指南(三接口示例与能力支持矩阵)。 - 新增
hy-3d-3.1:腾讯混元生 3D 专业版模型,支持文生 3D、图生 3D 与多视图输入,面向游戏、电商展示、3D 打印、产品设计等 3D 资产生成场景;3.1 版本在几何精度与纹理细节上进一步提升,并支持八视图多角度输入。
3D 生成接口上线
- 新增
/v1/3d/generations异步 3D 生成接口,首期接入腾讯 TokenHub 混元 3D。支持提交生成任务和查询任务结果,便于把 3D 资产生成接入自动化工作流。
Kimi K3 动态工具兼容
- Kimi K3 请求中的 message-level 动态工具声明会被保留并透传,模型推理厂商不再因为工具声明丢失而返回 400;使用 Kimi 动态加载工具的客户端兼容性更好。
请求转换错误更清晰
- Chat Completions 中的 custom tool、Cohere 文本块和
assistant.content: null等请求形态兼容性提升。合法请求更稳定地到达模型推理厂商;畸形或不支持的输入会返回结构化错误,不再被误判为空 200 成功。
Seedream 图片计费口径更新
doubao-seedream-5-0-pro的图片生成计费现在支持按输出像素档和输入图片张数计价,文生图、图生图等请求的费用更贴近实际生成规格。
OpenAI 音频模型与智能路由页面上线
新增音频模型
- 新增
gpt-audio-1.5:OpenAI 首个正式可用(GA)的音频模型,支持音频输入与音频输出,可通过 Chat Completions REST API 调用,适合语音对话、音频理解与音频生成场景。 - 新增
gpt-4o-transcribe-diarize:带说话人分离的 ASR 转写模型,可把对话中的音频片段关联到不同说话人;该模型仅在 Transcription API 中可用。
智能路由功能介绍页上线
- 智能路由功能介绍页现已上线,展示公开路由维度评分与在池模型。同时新增两个开放接口:获取自动路由策略对应模型范围返回 5 大类 23 个子维度的模型评分、价格系数、首字延迟与在池模型,获取模型厂商图标返回模型厂商的显示名与图标;图像与视频生成维度暂未纳入。使用方式参见模型智能路由文档。
API 错误校验与提示词缓存优化
API 错误提示更一致
/v1/responses使用未知模型时,现在返回 400,与其他 API 入口保持一致,便于客户端按“无可用服务”场景处理,而不是收到 500。
请求参数校验更早返回给客户端
- 请求体转换或参数校验失败时,API 会直接返回相应的 400/错误信息,不再把原始请求继续转给模型推理厂商,减少无效调用和难以理解的失败。
Claude Code 缓存命中更稳定
- Claude Code 通过 Bedrock 调用 Claude 时,同一会话内的 prompt cache 命中更稳定,有助于减少重复缓存写入费用和首 token 延迟。
Gemini 多轮/缓存请求粘性更精确
- Gemini 请求现在按响应中实际出现的思考签名或缓存活动决定是否保持同一服务,减少多轮验签或缓存状态不一致;图片生成等无状态任务不会被不必要地固定到同一服务。
GPT-5.6 系列与提示词缓存更新
新增模型
- 新增
gpt-5.6-sol、gpt-5.6-terra、gpt-5.6-luna三款 GPT-5.6 系列模型(OpenAI 2026-07-09 正式发布)。三档均为 1,050,000 上下文窗口、128K 最大输出、知识截止 2026-02-16,支持文本与图像输入,可通过 Chat Completions、Responses 与 Claude 兼容的 Messages 接口调用。Sol 为旗舰档,面向复杂专业工作,官方称其为当前最佳编码模型;Terra 性能与 GPT-5.5 相当且价格减半;Luna 面向成本敏感场景。
GPT 提示词缓存文档上线
- 新增 GPT 提示词缓存文档:GPT-5.6 系列起缓存写入按 1.25 倍输入价计费、缓存读取按 0.1 倍计费、缓存至少保留 30 分钟;覆盖
prompt_cache_key与显式缓存断点参数说明、计费逻辑、接口示例与命中排查。提示词缓存实践与 Claude 提示词缓存的 OpenAI 缓存口径同步更新。
Claude Fable/Mythos 思考模式兼容
- Claude Fable 与 Mythos 系列在请求中使用
reasoning_effort时,现在会按 adaptive thinking 处理,减少这类模型因思考参数不匹配导致的模型推理厂商 400。
Claude 与 Gemini 的 stop 参数生效更一致
- OpenAI 兼容请求里的
stop现在会映射到 Claude 与 Gemini 原生请求。Claude 不接受的纯空白 stop 会被过滤,OpenAI/Gemini 的数量限制也按各自规则处理,跨协议生成截断更稳定。
gpt-chat-latest token 上限参数兼容
gpt-chat-latest以及后续 GPT/ChatGPT latest 别名在需要时会保留max_completion_tokens,减少因误发旧字段max_tokens导致的 400。
Key 额度耗尽提示更清晰
- 当 Key 级别使用限额耗尽时,API 现在返回更明确的引导文案,提示去调整并激活 Key 限额,而不是仅返回底层 quota 报错。
Tool calls 响应结构对齐 OpenAI
- 非流式 chat 响应在只有
tool_calls、没有文本内容时,现在会显式返回content: null,提升 OpenAI 风格 SDK 与响应解析器的兼容性。
结构化输出修复与 Grok 4.5 上线
结构化输出修复:JSON 格式错误自动修复
- 新增 Key 级别的结构化输出修复能力,默认关闭。开启后,对声明了结构化 JSON 输出的非流式请求,当模型返回的 JSON 存在截断、尾随逗号、代码块包裹等格式错误时,网关在返回前自动修复为可解析的合法 JSON,数值保持原样,客户端无需改动。支持 Chat Completions、Responses、Claude、Gemini 四种协议;发生修复时响应带有
X-JSON-Repaired: true响应头。
Claude 提示词缓存文档:补齐各模型最小缓存 token 门槛
- 完善 Claude 提示词缓存 与提示词缓存实践文档,补齐按模型区分的最小可缓存 token 门槛(512 / 1,024 / 2,048 / 4,096),新增 Claude Opus 4.8、Opus 4.7、Fable 5 等当前模型。该门槛并非随模型版本升级而提高;低于门槛的前缀即使显式设置
cache_control也不会被缓存。
用量看板与结算明细口径对齐
- 用量看板的聚合结果现在更接近日志明细结算口径,减少并发聚合丢数,并统一延迟重放时的小时归桶。历史看板数据仍可能存在小幅差异;对账和结算仍以请求日志明细为准。
新增模型
- 新增
grok-4.5,面向代码、Agent 任务和知识工作,支持可配置推理、工具调用和 500K 上下文,适合代码修复、复杂工程任务、知识问答与 Agent 工作流。
GPT 工具调用自动桥接 Responses
gpt-5.5+ 工具调用自动桥接 Responses
- 使用 OpenAI 兼容
/v1/chat/completions调用 gpt-5.5 及以上模型时,带 tools 和reasoning_effort的请求会自动走 Responses 能力,减少模型推理厂商因参数组合不支持导致的 400。现有客户端无需改成/v1/responses也能获得更稳的工具调用体验。详见:Responses API
结构化输出与 Vertex Messages 兼容优化
结构化输出跨协议兼容
- OpenAI 兼容的
response_format与 Claude 原生output_config.format现在可在相关路径中双向适配。调用方在跨 OpenAI/Claude 协议切换时,更容易保留结构化输出约束。详见:Structured Output。
Vertex AI 的 /v1/messages 调用更稳定
- 通过 Vertex AI 调用 Gemini 等非 Claude 模型时,
/v1/messages请求会按模型族正确分流,减少误走 Claude 路径导致的 not found 或 404。
Gemini 原生端点与腾讯混元 Hy3 上线
Gemini 原生端点补齐
@google/genaiSDK 通过 AIHubMix 的 Gemini 入口调用时,现已支持原生 Embeddings、Interactions 和 Context Caching 相关能力。此前这些路径可能返回路由未注册或 404;现在可用于向量生成、交互式推理(含文本与图像生成)和缓存创建/查询/删除等工作流。详见:Gemini 原生 SDK 接入
长上下文模型计费覆盖扩展
hy3-preview、ERNIE、Grok、Mimo 等长上下文模型现已支持按上下文长度分档计费,费用计算更精确。
Vertex AI 流式日志指标修复
- Vertex AI 的 Gemini/Claude 流式请求现在会记录更准确的首 token 与延迟数据,日志页和监控排查看到的耗时信息更可信;该变化不影响模型响应内容。
新增模型
- 新增
tencent-hy3文本生成模型(腾讯混元 Hy3 正式版)。MoE 架构,295B 总参数 / 21B 激活参数,256K 上下文窗口。支持快慢思维融合推理模式,适合复杂推理、代码生成和 Agent 工作流。Apache 2.0 许可证开源。
Jina 文件上传与流式响应修复
Jina Search/Reader 支持 POST 与文件上传
- Jina Search 与 Reader 现在支持 POST 调用;Reader 可通过 multipart 上传 PDF、Word、Excel、PPT、HTML 和图片等本地文件。默认响应更贴近 Jina 原生 markdown;需要 JSON 的客户端可显式发送
Accept: application/json。
Responses 端点的 Azure 类服务调用更稳定
- 修复
/v1/responses经兼容桥接调用 Azure 类非 GPT 服务时可能因api-version为空而返回 404 的问题,减少此类请求的直接失败。
流式回答截断问题修复
- 修复部分 vLLM / Azure Foundry 类模型推理服务在流式输出中可能随机截断的问题,用户更容易收到完整回答、结束信号和用量信息。
新增模型:Command A Plus 05-2026
- 新增
command-a-plus-05-2026文本生成模型,适合企业对话、文本生成和 Agent 工作流。
搜索、视频与账号能力更新
Jina 搜索与网页读取接口上线
- 新增 Jina 搜索与 Reader 能力,支持通过 AIHubMix API Key 调用 Jina 搜索结果获取与网页内容读取能力,适合需要外部网页信息检索、资料读取和 Agent 工具调用的场景。详见:Jina AI
Veo 3.1 图生视频支持首尾帧与参考图
- Veo 3.1 图生视频现支持首帧、尾帧和参考图输入,用户可以更精确地控制视频起止画面、角色参考和风格参考,适用于更复杂的视频创作工作流。详见:视频生成
Gemini 重试稳定性优化
- 优化 Gemini 请求在重试与 fallback 场景下的兼容性,减少部分重试场景下的 400 错误,提升兜底调用的成功率。详见:Gemini 使用指南
OpenAI 兼容响应字段对齐
- OpenAI 兼容接口在非流式和流式响应中保留
logprobs、refusal、finish_reason等字段的null值,减少依赖 OpenAI 标准响应结构的 SDK、Agent 和日志解析工具出现兼容差异。
Claude Code 接入隐私与兼容性优化
- 优化 Claude Code 通过 AIHubMix 调用 Claude 模型时的请求兼容处理,减少客户端环境信息进入发往模型推理厂商的请求,提升第三方 Agent 客户端接入的隐私保护。
登录注册与个人中心能力完善
- 自建账号体系补齐邮箱验证码登录/注册、密码设置、资料修改、第三方账号绑定解绑与账号注销等后端能力,并加强验证码用途隔离与禁用账号拦截;Stripe 充值回调处理也更稳健。
新增模型
- claude-sonnet-5(对话 / 推理 / Agent 场景)。
- gemma-4-31b、longcat-2.0(文本生成模型)。
- gemini-3.1-flash-lite-image(图像能力模型)。
- mai-image-2.5、mai-image-2.5-flash(图像生成模型)。
Responses 跨模型支持与 Codex 自定义模型
Responses 协议支持任意模型
/v1/responses端点不再限于 GPT 系列,现可调用平台上的任意模型。基于 Responses 协议的工具(如 Codex CLI)因此能通过本地模型目录使用 GLM、Gemini、DeepSeek、Kimi、Qwen 等模型,不再局限于 OpenAI 官方模型。
Step 3.7 Flash 的 Responses 输出修复
- 修复
step-3.7-flash通过/v1/responses调用时可能返回空白内容或空响应的问题,推理内容和最终回答现在可正常返回。
Codex CLI 新增自定义模型支持
- Codex CLI 文档新增「在 Codex 中使用自定义模型」教程:通过本地模型目录(
model_catalog_json)声明 AIHubMix 上的任意模型(GLM、Gemini、DeepSeek、Kimi、Qwen 等),即可在 Codex 的/model列表里自由切换,不再局限于 OpenAI 官方模型。文档含一键生成前 30 名模型目录的脚本与常见踩坑说明。详见:Codex CLI · 在 Codex 中使用自定义模型
CLI、智能路由与 Agent Skill 上线
新增 AIHubMix CLI(命令行工具)文档
- 新增 AIHubMix CLI(命令行工具) 文档:单一二进制、零依赖(无需 Python / Node / Go),在终端即可查询账户余额、管理 API Key、查看可用模型,并对脚本与 AI Agent(如 Claude Code)友好。
新增模型智能路由(LLM Router)
- 请求模型名填
auto,网关按请求内容从平台数百个模型中自动选出最优模型,支持成本优先 / 质量优先 / 低延迟等策略,按实际命中模型计费,客户端代码零改动。详见:模型智能路由
DeepSeek 缓存命中率修复
- 修复
deepseek-v4-pro、deepseek-v4-flash两个模型缓存命中率低于预期的问题。
新增 AIHubMix Skill(AI 编程助手扩展)
- 为 Codex、Claude Code、Cursor、Cline 等支持 Skills 的 AI Agent 提供本地扩展能力:用自然语言完成 AIHubMix 接入、模型查询、按能力选型、示例生成与错误排查。该 Skill 按需从官方接口读取模型、价格、协议契约等实时信息,避免 Agent 依赖过期记忆。详见:Skills
OpenClaw 插件修复与 GLM-5.2 上线
OpenClaw 接入插件问题已修复
- AIHubMix 的 OpenClaw 接入插件 aihubmix-auth 已修复此前的接入问题,现可稳定使用。安装并填入一把 AIHubMix Key 即可在 OpenClaw 中同时调用 OpenAI / Anthropic / Gemini 等模型。
新增模型
- 智谱 glm-5.2。
Open Design 接入与编程模型更新
新增 Open Design 接入支持
- AIHubMix 现已是 Open Design(开源、本地优先的 Claude Design 平替)内置支持的 BYOK 网关。在其 API(BYOK)模式里选 AIHubMix、填一把 Key,即可同时驱动聊天 / 图像 / 视频 / 语音生成,并按模型名走各家原生协议。详见:Open Design 接入教程
智谱 GLM 5.2 支持推理强度分档
- 原生智谱服务的
glm-5.2支持reasoning_effort分档调节思考深度,旧版模型按版本自动分流,调用方无需改动。
新增模型
- kimi-k2.7-code-highspeed(Kimi 代码高速版)。
Claude Fable 5 上线记录与特性说明
新增模型
- claude-fable-5【已退役】。
Claude 新模型 Fable 5 / Mythos 5 的特性说明
- Fable 5 有更强的安全护栏,部分正常问题也可能被拦: 会对网络安全、生物 / 化学、模型蒸馏 / 推理提取等方向做额外分类。有些技术研究、漏洞分析、生物医药相关问题,可能被拒绝,或转交到 Opus 4.8 回答。
- Mythos 5 是受限访问,不是普通开放模型: Mythos 5 和 Fable 5 能力同源,但少了部分安全分类器;目前只面向 Project Glasswing / 获批客户。一般用户实际用到的是带护栏的 Fable 5。
- API 成本更高: Fable 5 价格为每百万输入 token 10 美元、每百万输出 token 50 美元,约为 Opus 4.8 的两倍。
- 隐私: Fable 5 / Mythos 5 被列为 Covered Models,默认要求至少 30 天数据保留,不支持 Zero Data Retention。
- API 调用拒绝显示: Fable 5 拒绝请求时,API 返回的是 HTTP 200,但
stop_reason是refusal。
Claude 4.7 系列接入
新增模型支持
- Claude 4.7 系列: 正式接入最新一代 Claude 4.7 模型,包括
claude-opus-4-7以及具备深度思考能力的claude-opus-4-7-think。该系列在复杂逻辑推理、代码编写及长文本处理能力上实现大幅跃升。详见官方文档:Claude 4.7 新增参数说明
全球加速网络与健康监测上线
- AIHubMix 全球加速网络正式上线:自建全球边缘节点与智能调度体系,通过持续监控与动态优化,实现响应延迟降低 75%、稳定性提升 60%、可用性达 99.99%,让 AI 应用体验更快更稳。
- 新增 7×24 实时健康监测:多区域探针每分钟全网检测延迟、成功率与稳定性,异常可在用户感知前自动识别并处理,保障服务持续稳定。
- 优化智能流量调度:基于多时间窗口动态计算节点健康评分,毫秒级自动切换最优路径,显著降低波动与超时,提升整体请求成功率。
Chat 转 Responses 与模型弃用通知
- 新功能: Chat → Responses 兼容调用 本次上线 Chat → Responses 兼容能力,支持通过 chat/completions 接口调用 OpenAI 仅支持 Responses 协议的模型,包括 gpt-5.2-codex、gpt-5.1-codex-max、gpt-5.2-pro 等。 如需要强制 AIHubmix 的 chat 接口让背后路由都走 Responses 协议,请在请求中添加 Header:X-Use-Responses-Enabled: true。当模型同时支持 Chat 与 Responses 双协议时,设置该参数将强制请求使用 Responses 接口。当前 Responses 协议暂不支持音频输入输出,请注意使用场景。
- 模型弃用通知:OpenAI 将于 2026 年 2 月 17 日 下线 chatgpt-4o-latest,我们会在下线后自动将 chatgpt-4o-latest 映射至 gpt-4o-2024-11-20
2025 年
Qwen、Seedream 与百度绘图模型接入
AIHubMix 图片生成 MCP 上线
- 推出 Aihubmix 图片生成 MCP,方便开发者接入图片生成服务
Claude Code 跨模型调用支持
- 在 Claude Code 中使用 AiHubMix 平台的任何大模型
Gemini CLI 与 Responses 工具扩展
- 新增 Gemini Cli 转发支持,多种使用方式,由你灵活掌控。
- OpenAI Responses API 接口新增代码解析器和 Remote MCP 调用。
APP-Code 应用标识与开发者优惠
- 推出 应用标识码 APP-Code,为开发者们提供全部模型 10% 优惠;
Gemini 隐式缓存支持
- 新增 Gemini 隐式缓存功能,支持自动命中与命中反馈。开发者可以通过 usage_metadata 判断命中情况。成本节省非保证,实际效果因请求结构和使用场景而异。
Claude 4 工具与缓存能力更新
Claude 4 新功能全面支持- ⏳ 新的缓存周期:1 小时级别的缓存Beta 支持
- 🎉 新的文本编辑工具:Claude 4 模型支持全新的 text_editor_20250429 工具类型和 str_replace_based_edit_tool 工具名称
- 🚫 拒绝停止原因:引入新的 refusal 停止原因,用于处理模型因安全原因拒绝生成的内容
- 🧠 扩展思考:Claude 4 模型返回完整思考过程的摘要,提供扩展思考的全部智能优势
- 🔄 交错思考:支持工具使用与扩展思考交错,实现更自然的对话体验(Beta)
- ⚠️ 不再支持的功能:
- Claude 4 文本编辑工具不再支持 undo_edit 命令
- 移除了 token-efficient-tools-2025-02-19 支持(仅 Claude 3.7 可用)
- 移除了 output-128k-2025-02-19 支持(仅 Claude 3.7 可用)
- 📚 更新了完整的迁移指南和代码示例,帮助用户从 Claude 3.7 平滑迁移到 Claude 4
Codex Mini 与 Google 图像、视频更新
- 支持为编程任务而生的 codex-mini-latest,可通过 Responses api 端点或 Codex CLI 调用。
- 支持谷歌 imagen 3.0 绘图和 veo 2.0 视频生成,丰富你的创作形式。
- gemini-2.0-flash-exp 升级为正式预览版 gemini-2.0-flash-preview-image-generation
Ideogram V3 图像接口上线
新增 Ideogram AI V3 接口,Ideogram 最先进的图像生成模型。GPT Image 1 与 Gemini 原生调用支持
- 万众期待的 OpenAI 绘图接口 \gpt-image-1\ 正式上线,支持文生图、图生图。
- 支持 Gemini 原生调用,可以精准控制 Flash 2.5 的推理预算。
Jina 向量、重排与深度搜索接入
集成了 Jina AI 的三个核心接口,助你轻松构建功能强大的智能体。三个接口分别是:向量嵌入 (Embeddings)、重排序 (Rerank)和深度搜索 (DeepSearch)Codex CLI 接入支持
新增 OpenAI CodeX CLI 支持!在命令行中用自然语言编程。跨模型联网搜索 Beta 上线
通过在模型 id 后方追加 :surfing,让任何模型具备搜索能力 BetaDeepSeek 价格调整与 Qwen 模型扩容
aihubmix-DeepSeek-R1 由于微软价格上涨 7 倍因此该模型价格上涨 7 倍,推荐使用火山的 DeepSeek-R1,稳定又便宜;新增 qwen-qwq-32b 和 qwen2.5-vl-72b-instruct模型服务调整与详情页更新
- gpt-4o 概率性出现返回很慢的情况,次为厂商问题;建议暂时改用 gpt-4o-2024-11-20
- Perplexity api 暂时下线,Perplexity 官方的计费模式较为复杂,成本高于本平台的定价结构,我们调整价格后重新上线;
- 字节官方限时折扣结束恢复原价,DeepSeek-R1 价格已上调
- 新增模型详情页及参数信息
控制台结构优化与模型扩容
- 新增模型:kimi-latest(官方计费根据输入内容长度 8k,32k,128k 分 3 档计费,本站不支持该计费结构,取中 32k 档为计费标准,价格敏感介意勿用)
- 优化了网站页面结构;
- 日志页面并入用量统计页;
- 公告内容移到模型广场页,
- 设置移到头像下面;
- aihubmix-DeepSeek-R1 价格下降 50%
- 新增模型:gemini-2.0-pro-exp-02-05-search,gemini-2.0-flash-exp-search,集成了谷歌官方搜索联网功能
- 新增模型:gemini-2.0-flash、gemini-2.0-pro-exp-02-05、gemini-2.0-flash-lite-preview-02-05 新增模型:o3-mini,o1(注这两个模型后台扣费比官方贵 10% 左右,因为这两个模型帐号帐号有限)
o1 与 o3-mini 调用参数说明
- o1 模型 openai 官方不支持传入参数 stream
- o3-mini 不支持传入参数 temperature,o3-mini 新增参数 Reasoning effort;可以传入”low, medium, high” 如果不传默认为 medium
OpenAI 音频能力与多厂商模型扩容
功能:新增 openai 声音模型输入输出的功能支持,api.aihubmix.com 服务器可用,主站服务器稳定 1 周后更新支持。总体后台扣费和官方一致,暂时日志只展示文字部分 token 声音费用暂时无法展示,但不影响使用新增模型:- o3-mini,o1;(注这两个模型后台扣费比官方贵 10% 左右,因为这两个模型帐号帐号有限)
- aihubmix-DeepSeek-R1(推荐,比较稳定)
- qwen-max-0125(即 Qwen2.5-Max)、sonar-reasoning
- deepseek-ai/DeepSeek-R1-Zero和deepseek-ai/DeepSeek-R1,deepseek-r1-distill-llama-70b
- aihub-Phi-4
- Doubao-1.5-pro-256k、Doubao-1.5-pro-32k、Doubao-1.5-lite-32k、Doubao-1.5-vision-pro-32k
- sonar、sonar-pro(perplexity ai 最新发布)
- gemini-2.0-flash-thinking-exp-01-21
- deepseek-reasoner(即 DeepSeek-R1)
- MiniMax-Text-01
- codestral-latest(Mistral 推出了新的 code 模型 - Codestral 25.01)
DeepSeek、豆包与 Gemini 模型扩容
新增模型:- aihub-Phi-4
- Doubao-1.5-pro-256k、Doubao-1.5-pro-32k、Doubao-1.5-lite-32k、Doubao-1.5-vision-pro-32k
- sonar、sonar-pro(perplexity ai 最新发布)
- gemini-2.0-flash-thinking-exp-01-21
- deepseek-reasoner(即 DeepSeek-R1)
Perplexity、MiniMax 与 Codestral 接入
- 新增 Perplexity Ai API 模型;仅支持 api.aihubmix.com 预览版服务器调用,如果没问题我们会更新到主服务器 aihubmi.com; api.aihubmix.com 为预览版服务器,后续新功能先更新到这个服务器,通常稳定 1 周我们再更新到主服务器 aihubmix.com 新增模型:
- MiniMax-Text-01
- codestral-latest(Mistral 推出了新的 code 模型 - Codestral 25.01)
Gemini 联网搜索与 DeepSeek-V3 上线
- 新增 gemini-2.0-flash-exp-search,支持谷歌原生联网搜索功能;官方 gemini 2.0 flash 模型的联网需要额外传入参数才支持联网功能,aihubmix 做了集成,模型名字加上 search 参数即可使用
- 新增模型 deepseek-ai/DeepSeek-V3
2024 年
用量统计、充值记录与模型扩容
- 新增用量统计页面,新增充值记录页面
- 新增豆包系列模型:Doubao-lite-128k、Doubao-lite-32k、Doubao-lite-4k、Doubao-pro-128k、Doubao-pro-256k、Doubao-pro-32k、Doubao-pro-4k
- 新增模型:gemini-2.0-flash-thinking-exp-1219
- 新增模型:gemini-2.0-flash-exp、aihubmix-Mistral-Large-2411、aihubmix-Llama-3-3-70B-Instruct、grok-2-1212、grok-2-vision-1212
- 新增模型:gemini-exp-1206、llama-3.3-70b-versatile、learnlm-1.5-pro-experimental
Gemini、Mistral 与 Llama 模型接入
- 新增模型:gemini-2.0-flash-exp、aihubmix-Mistral-Large-2411、aihubmix-Llama-3-3-70B-Instruct
GPT-4o、Grok 与 Qwen 长上下文更新
- 近期新增模型:gpt-4o-2024-11-20,step-2-16k,grok-vision-beta,
- 千问 2.5turbo 百万上下文模型:qwen-turbo-2024-11-01
Claude 原生 SDK 与 Messages 接口支持
- 兼容 Claude 原生 sdk,v1/messages 接口已支持上线;
- Claude 原生接口的缓存和控制计算机功能还不支持(prompt caching 和 computer use)我们会在接下来的两周内继续完善。
OpenAI 提示词缓存功能上线
OpenAI 最新的缓存功能现已上线。此功能目前支持以下模型:- GPT-4o
- GPT-4o-mini
- o1-preview
- o1-mini 请注意,gpt-4o-2024-05-13 版本不在官方支持范围内。 如果请求命中缓存,您将能够在后台日志中看到相关的缓存 token 数据。 更多详细信息和使用规则,请访问 OpenAI 官方网站:OpenAI 缓存功能详情
GPT-4o 计费调整与模型扩容
- gpt-4o 模型后台计费下降价格同步官方
- 新增模型:aihubmix-Llama-3-2-90B-Vision,aihubmix-Llama-3-70B-Instruct
- 新增 Cohere 最新模型 aihubmix-command-r-08-2024,aihubmix-command-r-plus-08-2024
Whisper 模型扩容与音频计费说明
- 新增模型:whisper-large-v3 和 distil-whisper-large-v3-en
- 注意:Whisper 模型实际计费是按照输入的秒数计费的,但是目前页面价格展示有问题未来会修复,后台底层计费没有问题 whisper-1 完全同步 Openai 官方扣费
o1 系列接入与调用限制说明
- 新增模型 o1-mini 和 o1-preview;
注:最新这两个模型,要求传入参数有变,一些壳软件如果不更新默认传入的参数会报错;
- system 字段:400 报错
- tools 字段:400 报错
- 图片输入:400 报错
- json_object 输出:500 报错
- structured 输出:400 报错
- logprobs 输出:403 报错
- stream 输出:400 报错
- o1 系列:20 RPM,150,000,000 TPM,很低,随时 429 报错
- 其他:temperature, top_p and n 被固定为 1;presence_penalty 和 frequency_penalty 被固定为 0
模型扩容、Claude 调价与并发提升
- 新增模型:mattshumer/Reflection-Llama-3.1-70B;ps:据说 llama3.1-70b 最强微调版本
- claude-3 模型价格上调调整,为了维持 Claude 模型稳定供应,目前调用我们会比直接调用官方贵 10%,后续会逐步下调;
- 增加了 Openai 系列模型的并发能力,理论上基本支持无限并发;
Phi 模型扩容与调用稳定性优化
- 新增模型:Phi3medium128k、ahm-Phi-3-medium-4k、ahm-Phi-3-small-128k
- 增加了 Llama 相关模型的稳定性
- 进一步优化了 Claude 模型的兼容性
GPT-4o 与 Gemini 新版本上线
- 新增 Openai 刚刚更新 4o 版本 gpt-4o-2024-08-06,见 https://platform.openai.com/docs/guides/structured-outputs
- 新增 Google 最新模型:gemini-1.5-pro-exp-0801
在线充值、Claude 修复与域名迁移
- 增加了在线直接支付充值
- 修复了 Claude 多轮对话格式报错问题:1、messages: roles must alternate between “user” and “assistant”, but found multiple “user” roles in a row;
- 优化了 Claude 模型的使用 function 功能时 index 问题
- https://orisound.cn 备用服务器将在 9 月 7 日全面下线;目前在使用这个地址的请抽空改成主服务器 https://aihubmix.com 或者备用服务器 https://api.aihubmix.com
Mistral Large 2 接入与系统优化
- 新增支持 Mistral Large 2,模型名称:Mistral-large-2407 或者 aihubmix-Mistral-large-2407;
- 系统优化
Llama 3.1 系列上线
- 新增最新 llama-3.1 模型 llama-3.1-405b-instruct,llama-3.1-70b-versatile 和 llama-3.1-8b-instant,欢迎尝试;
GPT-4o Mini 图像输入计费修复
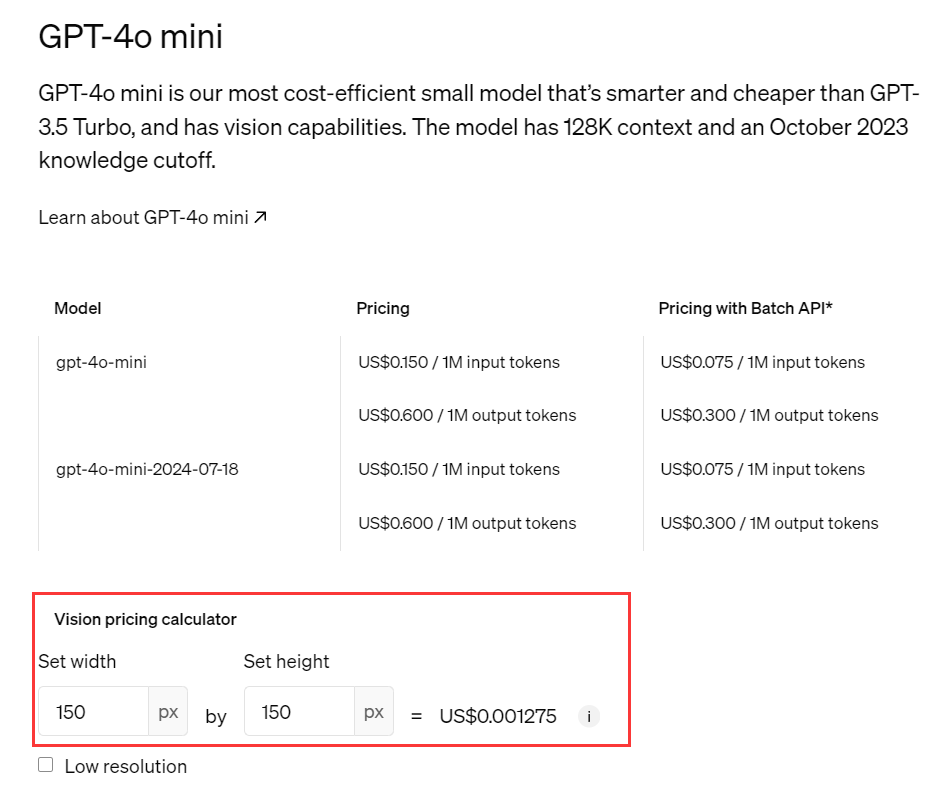
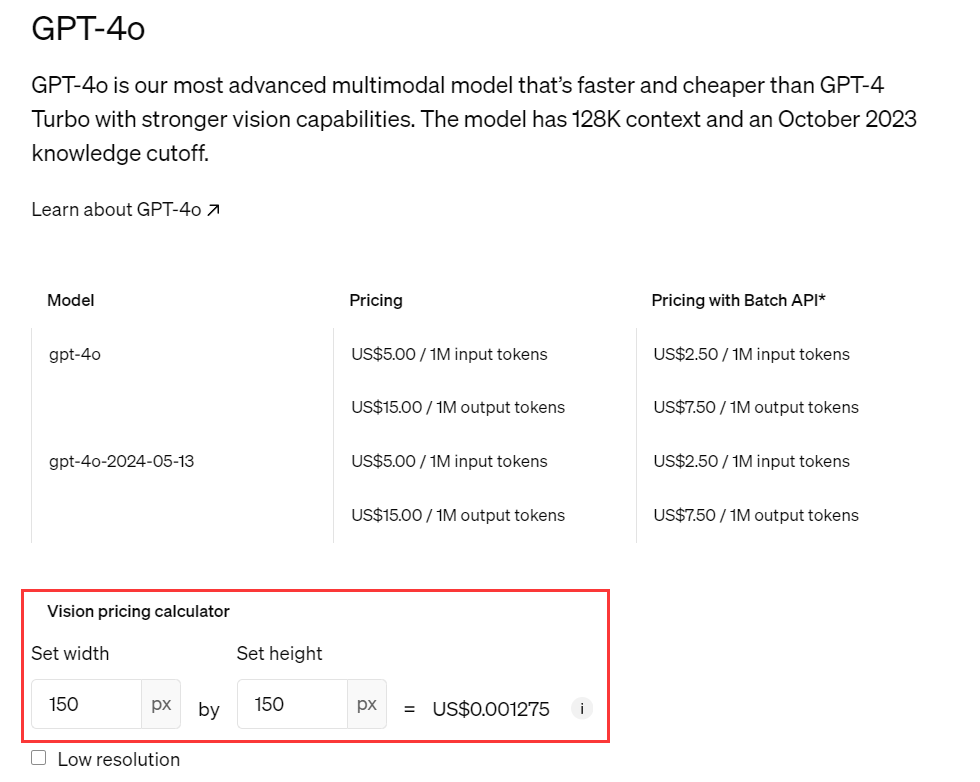
- 已修复 gpt-4o-mini 模型在价格计算方面的问题。具体情况如下:
文本输入价格:OpenAI 官方的 gpt-4o-mini 模型输入文本的价格仅为 gpt-4o 模型价格的 1/33。
图片输入价格:OpenAI 官方的 gpt-4o-mini 模型输入图片的价格与 gpt-4o 模型价格相等。 - 为了确保价格计算的准确性,我们在计算 gpt-4o-mini 模型输入图片的 token 数时,将其乘以 33 倍,以与官方价格对齐。
- 详情可见 Open AI 官方价格
客户端、工具调用与模型兼容优化
- 新版本 nextweb 增加了支持调用非 Openai 模型 调用本站非 OpenAI 模型
- 增加了阿里千问模型的后台扣费,总统调用我们的成本比调用阿里云官方贵 10% 左右
- 优化 azure openai 返回的输出更好的兼容了 Openai 接口
- 支持 Claude-3 的 tool Calling
- 增加了很多新模型,见设置/可用模型
Claude 3 系列价格下调
- 下调 Claude-3 相关模型的费用(Claude 3 Haiku、Claude 3 Sonnet、Claude 3 Opus)后台扣费和官方一致;因此当前我们网站额度零售价格,使用我们的 API 的成本相当于官网 86 折;
GPT-4o 流式 Token 计数优化
- 优化 gpt-4o 的 token 计费,tokenizer 的 cI100k_base 改为 0200k_base,之前的 gpt-4 系列用的是 cI100k_base;结果就是中文、韩文、日文的流式请求的 token 计数会比之前下降;
Qwen2 开源模型接入
- 新增阿里最新开源模型 Qinwen2
- alibaba/Qwen2-7B-Instruct、alibaba/Qwen2-57B-A14B-Instruct、alibaba/Qwen2-72B-Instruct
GPT-4o、Gemini 与 Llama 扩容
- 新增模型 gemini-1.5-flash
- 新增模型 gpt-4o
- 新增 llama3(llama3-70b-8192、llama3-8b-8192)gemini-1.5-pro、command-r、command-r-plus、欢迎调用尝试
- Claude-3 模型恢复供应;目前本站正在连接 Claude-3 部署在 aws 和 Google cloud 上的端点。
- 为了维持服务器费用及团队成本,Claude-3 模型和价格后台扣费比官方贵 10%
- 后续调用量增加的话,会逐步下调至 5% 左右,甚至更低,
- 目前并发有待测试和随着调用增加而去申请更高的并发调用。
更新时间:2026-06-22