LiteLLM の概要
LiteLLM は BerriAI によって開発されたオープンソースの 統一 AI ゲートウェイ です。市場のほぼすべての主要 LLM を呼び出すための単一の標準化されたインターフェースを提供します。リポジトリ:https://github.com/BerriAI/litellm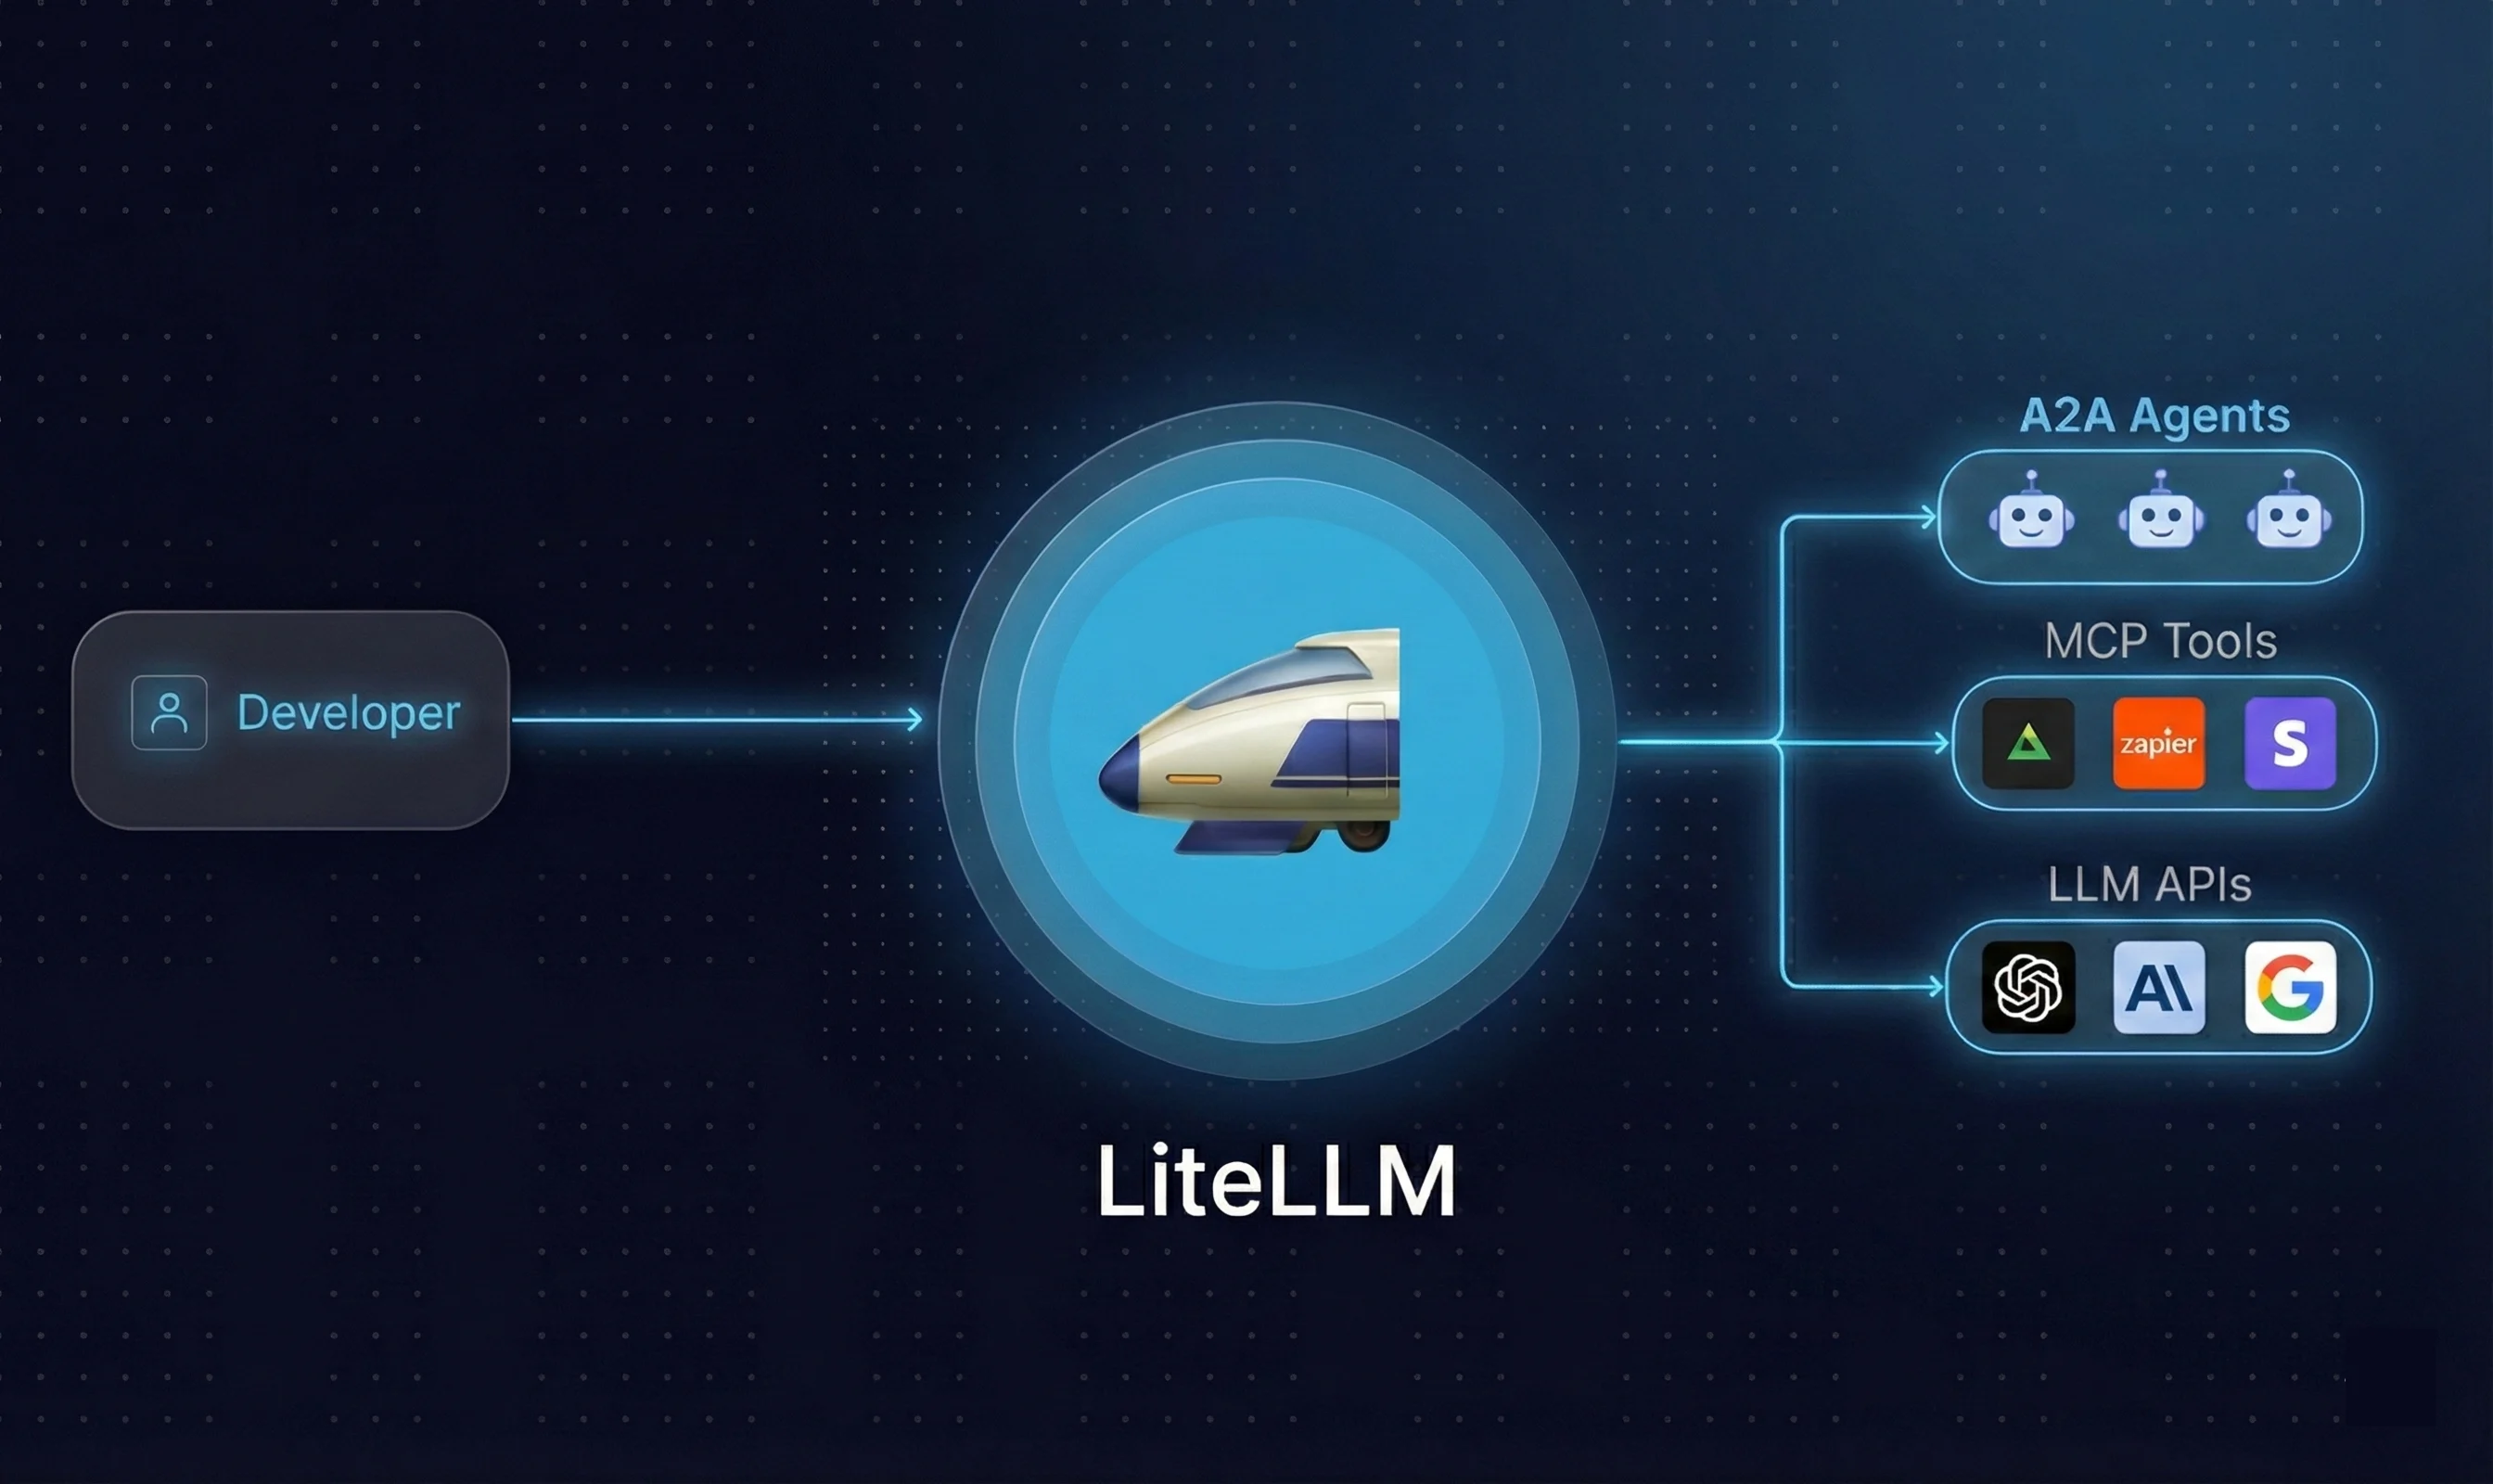
2 つの使用モード
コア機能
- 統一された OpenAI 形式:OpenAI、Anthropic、Gemini、Bedrock、Azure を含む 100+ プロバイダーをサポート
- 仮想キー管理:オリジナルを公開せずにチームの API キーを集中管理
- コストトラッキング:ユーザーまたはプロジェクトごとのトークン使用量と支出をモニタリング
- ロードバランシング:フェイルオーバーサポート付きのモデル間自動トラフィック分散
- 高パフォーマンス:1,000 RPS で P95 レイテンシ約 8ms
インストール
要件
Python 3.8+ macOS Homebrew 経由でインストール:pip
pip は通常 Python に同梱されています。利用可能か確認:LiteLLM のインストール
環境の準備ができたら:オプションの依存関係
一部のプロバイダーには追加のパッケージが必要です:Proxy Server のインストール
スタンドアロンゲートウェイをデプロイするには:Docker(オプション)
推奨:個人開発には pip install litellm を使用し、チームデプロイメントには Proxy + Docker を選択してください。
API キーの設定と初回呼び出し
AiHubMix API キーの取得
aihubmix.com ダッシュボードに移動して API キーを作成します。環境変数の設定
初回呼び出し
基本的な使い方
1. モデルの切り替え
AiHubMix はすべての主要モデルをサポートします。切り替えるにはmodel パラメータを変更するだけです:
2. ストリーミング
stream=True を追加して、トークン単位で出力を受け取ります:
3. マルチターン会話
messages リストに会話履歴を渡すと、モデルがコンテキストを記憶します:
4. 非同期呼び出し
各リクエストの完了を待たずに、複数のリクエストを並行して送信します:5. タイムアウトとリトライ
ネットワーク問題でリクエストがハングしたり失敗したりするのを防ぎます:timeoutは秒単位です。num_retriesは 2-3 に設定してください。値が大きいと応答が遅くなります。
6. トークン使用量とコスト追跡
すべてのレスポンスにはトークン使用量データが含まれます:7. ロードバランシングとフェイルオーバー
複数のモデルを設定して、トラフィックを自動的に分散したり、1 つが失敗したときにバックアップに切り替えたりします:
両方のモデルは同じ model_name を共有します。LiteLLM はそれらの間をラウンドロビンし、1 つがエラーを返した場合は自動的にフェイルオーバーします。
8. Proxy Server のデプロイ
Proxy Server はスタンドアロンゲートウェイです。チームメンバーは独自の API キーを持たずに、すべてのリクエストをそれを通してルーティングします。 インストール
ここでの api_key は任意の文字列で構いません。実際の AiHubMix キーは Proxy で管理されます。
9. 仮想キー管理
仮想キーを使用すると、異なるチームメンバーやプロジェクトに独立したキーを割り当てることができ、実際の AiHubMix キーを公開することなくアクセスと使用量を制御できます。 前提条件:PostgreSQL インスタンスを起動key フィールドが仮想キーです。例:sk-xxxxxx
仮想キーの使用
各仮想キーは個別のモデル制限、予算制限、有効期限をサポートします — 複数メンバーのチームワークフローに最適です。
実践例:マルチモデル比較
同じ質問を複数のモデルに同時に送信し、出力品質、速度、トークン使用量を比較します。 API キーの設定