LiteLLM 개요
LiteLLM은 BerriAI가 개발한 오픈 소스 통합 AI 게이트웨이입니다. 시장의 거의 모든 주요 LLM을 호출할 수 있는 단일 표준화된 인터페이스를 제공합니다. 저장소: https://github.com/BerriAI/litellm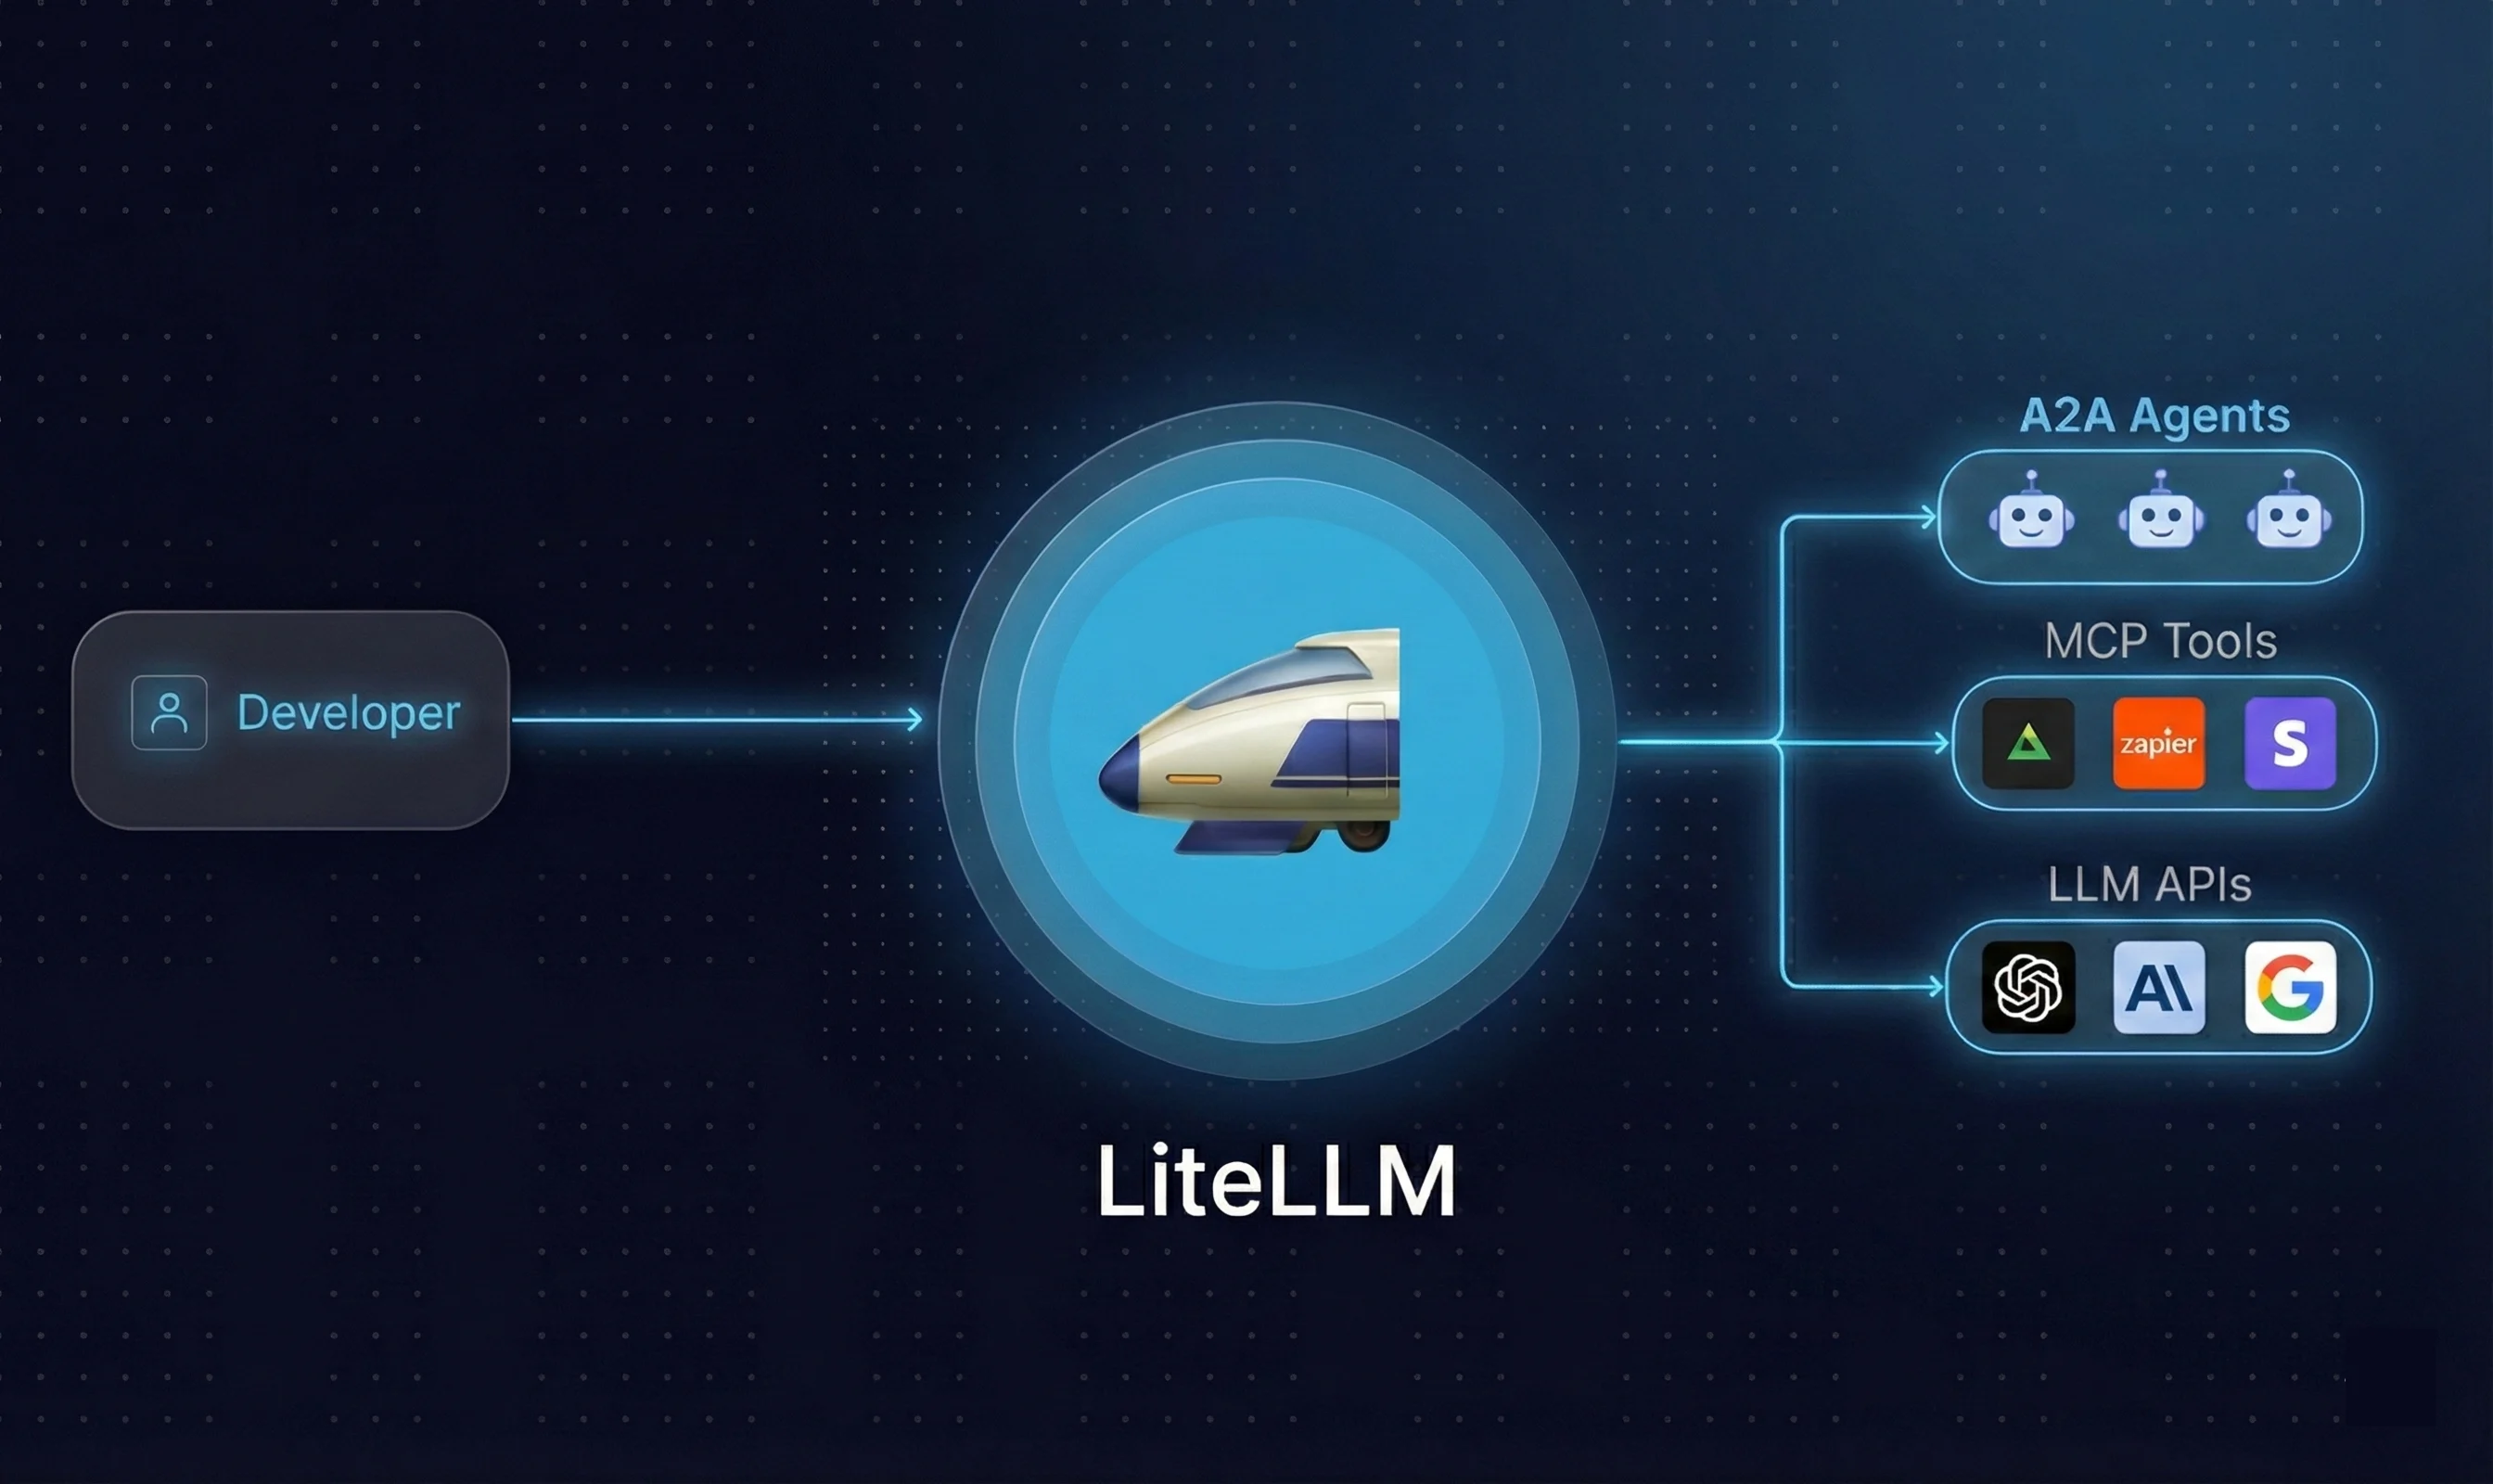
두 가지 사용 모드
핵심 기능
- 통합 OpenAI 형식: OpenAI, Anthropic, Gemini, Bedrock, Azure 등 100+ 공급자 지원
- 가상 키 관리: 원본을 노출하지 않고 팀 API 키를 중앙에서 관리
- 비용 추적: 사용자 또는 프로젝트별 토큰 사용량 및 지출 모니터링
- 로드 밸런싱: 페일오버 지원과 함께 모델 간 자동 트래픽 분산
- 고성능: 1,000 RPS에서 P95 지연 ~8ms
설치
요구 사항
Python 3.8+ macOS Homebrew를 통해 설치:pip
pip는 일반적으로 Python과 함께 번들로 제공됩니다. 사용 가능한지 확인합니다:LiteLLM 설치
환경이 준비되면:선택적 종속성
일부 공급자는 추가 패키지가 필요합니다:Proxy Server 설치
독립 실행형 게이트웨이를 배포하려면:Docker (선택 사항)
권장 사항: 개인 개발에는 pip install litellm을 사용하세요; 팀 배포에는 Proxy + Docker를 선택하세요.
API 키 구성 및 첫 호출
AiHubMix API 키 얻기
aihubmix.com 대시보드로 이동하여 API 키를 생성합니다.환경 변수 설정
첫 호출
기본 사용법
1. 모델 전환
AiHubMix는 모든 주요 모델을 지원합니다. 전환은model 파라미터를 변경하기만 하면 됩니다:
2. 스트리밍
토큰 단위로 출력을 받으려면stream=True를 추가합니다:
3. 다중 턴 대화
모델이 컨텍스트를 기억하도록messages 목록에 대화 기록을 전달합니다:
4. 비동기 호출
각 호출이 완료될 때까지 기다리지 않고 여러 요청을 동시에 보냅니다:5. 타임아웃 및 재시도
네트워크 문제로 요청이 멈추거나 실패하는 것을 방지합니다:timeout은 초 단위입니다.num_retries를 2-3으로 설정하세요; 높은 값은 응답을 느리게 합니다.
6. 토큰 사용량 및 비용 추적
모든 응답에는 토큰 사용량 데이터가 포함됩니다:7. 로드 밸런싱 및 페일오버
여러 모델을 구성하여 트래픽을 자동으로 분산하거나 하나가 실패할 때 백업으로 전환:
두 모델은 동일한 model_name을 공유합니다. LiteLLM은 그 사이에서 라운드 로빈을 수행하며 하나가 오류를 반환하면 자동으로 페일오버됩니다.
8. Proxy Server 배포
Proxy Server는 독립 실행형 게이트웨이입니다. 팀원은 자체 API 키 없이 모든 요청을 그것을 통해 라우팅합니다. 설치
여기의 api_key는 임의의 문자열이 될 수 있습니다. 실제 AiHubMix 키는 Proxy에 의해 관리됩니다.
9. 가상 키 관리
가상 키를 사용하면 다른 팀원 또는 프로젝트에 독립적인 키를 할당할 수 있으며, 실제 AiHubMix 키를 노출하지 않고 액세스 및 사용량을 제어할 수 있습니다. 전제 조건: PostgreSQL 인스턴스 시작key 필드는 가상 키입니다, 예: sk-xxxxxx.
가상 키 사용
각 가상 키는 개별 모델 제한, 예산 한도 및 만료 시간을 지원합니다 — 다중 멤버 팀 워크플로우에 이상적입니다.
실용적 예시: 다중 모델 비교
여러 모델에 동시에 동일한 질문을 보내고 출력 품질, 속도 및 토큰 사용량을 비교합니다. API Key 설정