

概要
リアルタイム音声認識は、WebSocket(クライアントとサーバー間で長時間接続を維持し、双方向にデータをプッシュできるプロトコル)で永続的な接続を確立し、連続的に入力される音声ストリームを受信しながら、文字起こししながら、返却するため、遅延に敏感な音声シーンに適しています。 ファイル転写 STT との違い:
利用可能モデル:
- gpt-live-transcribe —— ストリーミング転写モデル、多言語対応、音声入力に応じて転写テキストをリアルタイムに出力。
クイックスタート
接続エンドポイント
intent=transcription—— 必須、これが転写セッションであることを宣言します。model=gpt-live-transcribe—— 必須、モデルは接続時に URL パラメータで固定され、セッション中は変更できません(下記の制約を参照)。
認証
ハンドシェイク時に標準の HTTP ヘッダーでAPIキーを渡します:オーディオ形式の要件
現在は1種類の入力形式のみをサポートしています。送信前にオーディオを以下の形式に変換してください:- エンコード:PCM16(16ビット符号付き整数、リトルエンディアン)
- サンプリングレート:24000 Hz
- チャンネル:モノラル(mono)
audio/pcm@24000 です。この形式以外(G.711/µ-law など)を送信すると拒否され、セッションが終了します。
転写セッションは音声活動検出(turn_detection / VAD)をサポートしていません。必ず明示的に
null に設定してください。省略したり null 以外の値を渡したりすると、モデルプロバイダーは invalid_value で転写を拒否します。ゲートウェイは転送する設定に対して turn_detection を強制的に null に設定しますが、動作を明確に保つため、クライアント側でも積極的に null に設定することを推奨します。セッション設定(session.update)
接続確立後、クライアントはまず1フレームのsession.update を送信して転写パラメータを設定します。送信しない場合、ゲートウェイは認可されたモデルでデフォルト設定を注入してフォールバックしますが、明示的な設定を推奨します。
設定パラメータ
string
必須
セッションタイプ。転写シーンでは
transcription に固定されます。object
必須
入力オーディオ形式。
{ "type": "audio/pcm", "rate": 24000 } に固定されます。string
必須
転写モデル。接続 URL の
model と一致する必要があります(gpt-live-transcribe)。他のモデルを渡すと権限外とみなされ、セッションは 1008 で終了されます。string[]
想定される言語のリスト。配列形式(例:
["en", "zh"])。gpt-live-transcribe は複数形の languages を使用し、一度に複数の言語を宣言できます。言語を指定すると精度が向上し遅延が低減します。取り得る値は下記の 言語コード を参照してください。string
単数形の書き方。単一の ISO-639-1 コード(例:
"en")。languages とどちらか一方のみ、同時に渡さないでください(同時に渡すと invalid_value で拒否されます)。公式は gpt-live-transcribe に複数形の languages を推奨していますが、旧コードからの移行を容易にするため、単数形の language もゲートウェイは受け付けます。string
録音シーンを記述する自由テキストプロンプト(例:「カスタマーサポート通話」「医学用語を含む問診」)。モデルが言語域に適合するのを助けます。実測ではサーバー側が
session.updated でそのまま返し、既に有効です。string[]
リテラルなヒント語の配列。製品名、略称、固有名詞など誤りやすい語に使用します(例:
["AiHubMix", "gpt-live-transcribe"])。これはヒントであり強制的な出力ではありません。各語を個別の項目にし、<、>、改行文字を含めないようにしてください。実測では既に返され有効です。string
遅延 / 精度のレベル。選択可能な値は
minimal、low、medium、high、xhigh —— レベルが高いほど精度が上がりますが遅延も大きくなります。注意:ゲートウェイはこのフィールドを受け付けます(エラーになりません)が、実測では session.updated に返されません。有効性は公式ドキュメントに準拠し、返却による確認は取れていません。null
必須
音声活動検出。転写セッションでは必ず
null にしてください。object
オプションのノイズ低減設定。例:
{ "type": "near_field" }(近接場、マイクが話者に近い場合に適する)または { "type": "far_field" }(遠方場)。言語コード(language codes)
languages / language の値は以下の形式に従い、大文字小文字を区別し、必ず下記のサポートされた形式である必要があります。サポートされていない、または形式が誤ったコードを渡すと realtime API に拒否されます:
オーディオの送信
PCM16 オーディオを小さな分割(例:100ms ごとに1片)に切り、base64 エンコードした上でinput_audio_buffer.append イベントで継続的に送信します:
input_audio_buffer.commit を送信してその区間の終了を示し、転写の締めくくりをトリガーして completed 結果を返却させる必要があります:
転写結果の受信
サーバー側はイベントを継続的にプッシュします。主要なイベントタイプ:event
セッション作成、設定更新の確認。
event
転写の増分結果。フィールド
delta は今回新たに追加されたテキスト片です。話しながら返却され、リアルタイム表示に適しています。event
1区間の音声転写が完了。フィールド
transcript はその区間の完全なテキストです。event
エラーイベント。エラーコードと説明を含みます。
完全な例
以下に2種類の書き方を示します。いずれか一方を選んでください:- OpenAI 公式 SDK(推奨):WebSocket を手書きする必要がなく、
websocket_base_url(SDK の WebSocket ベースアドレスパラメータ)をゲートウェイに向けるだけで公式ライブラリを再利用できます。 - ネイティブ websockets:SDK をインストールせず、プロトコルに従って直接フレームを送受信します。依存が最小で、トラブルシューティングが容易です。
なぜ公式 demo はモデル名を渡さないのに、私たちは渡すのか? OpenAI の転写 intent はモデルを
session.update の transcription.model に置き、接続 URL には ?intent=transcription のみを付けます。AiHubMix ゲートウェイは異なります:モデル名は必ずハンドシェイク URL(?model=gpt-live-transcribe)に現れる必要があります —— ゲートウェイは WebSocket ハンドシェイクのその瞬間にそれを使ってモデルプロバイダーの選択、認証、額度の予約を行う必要があり、session.update はハンドシェイク完了後に届くため間に合わないからです。したがって SDK を使う場合は connect() に明示的に model を渡す必要があります(SDK がそれを URL クエリに組み込みます)。それが欠けるとゲートウェイはハンドシェイク期に 400 missing_model_parameter を返し —— connect() は直接例外をスローし、接続がそもそも確立できず、session.update のステップにまったく到達しません。セッション内の transcription.model は依然として URL と一致する必要があります。動作結果(本番実測)
以下は上記の例をaihubmix.com の本番環境(モデル gpt-live-transcribe)で実際に実行した結果です。languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" } を設定しています:
実測では
languages、prompt、keywords、noise_reduction はいずれもサーバー側が session.updated でそのまま返しており、設定が実際に有効になっている(受け付けるだけで処理しないのではない)ことを示しています。delay フィールドはゲートウェイが受け付けますが返しません。有効性は公式ドキュメントに準拠します。language(単数)と languages(複数)はどちらか一方のみ渡せます。課金説明
- 単価:
gpt-live-transcribeは $0.017 / 分 で課金されます(モデル詳細ページのリアルタイム掲載価格に準拠)。 - 転写したオーディオの長さで課金:実際に転写モデルへ転送されたオーディオの秒数を基準とし、整数秒に切り上げます。例えば 90 秒のオーディオを転写した場合、課金は
90 ÷ 60 × $0.017 = $0.0255です。 - 課金はネットワークの往復やアイドル待機の影響を受けず、実際に転写に投入されたオーディオのみを計時します。
- 使いながら精算:これは長時間接続であり、費用はセッション終了を待って一括精算するのではなく、セッションの過程で区間ごとにリアルタイムで差し引かれます。セッション確立時にまず約1分の使用量で1回額度の予約を行います(アクセス審査のためのみで、実際の課金ではありません)。セッション中は20秒ごとに予約をローリング更新し、実際の費用は実転送秒数に応じて区間ごとに差し引かれ、セッション終了後に残りの予約が解放されます。したがってアカウントの利用可能残高は少なくとも約1分の使用量を賄える必要があり、そうでなければセッションを確立できません。
- 使用量と請求 の消費明細では、各リアルタイム転写レコードの備考に「毎分単価」と「今回の実収秒数」が記載され、1件ずつの照合が容易です。
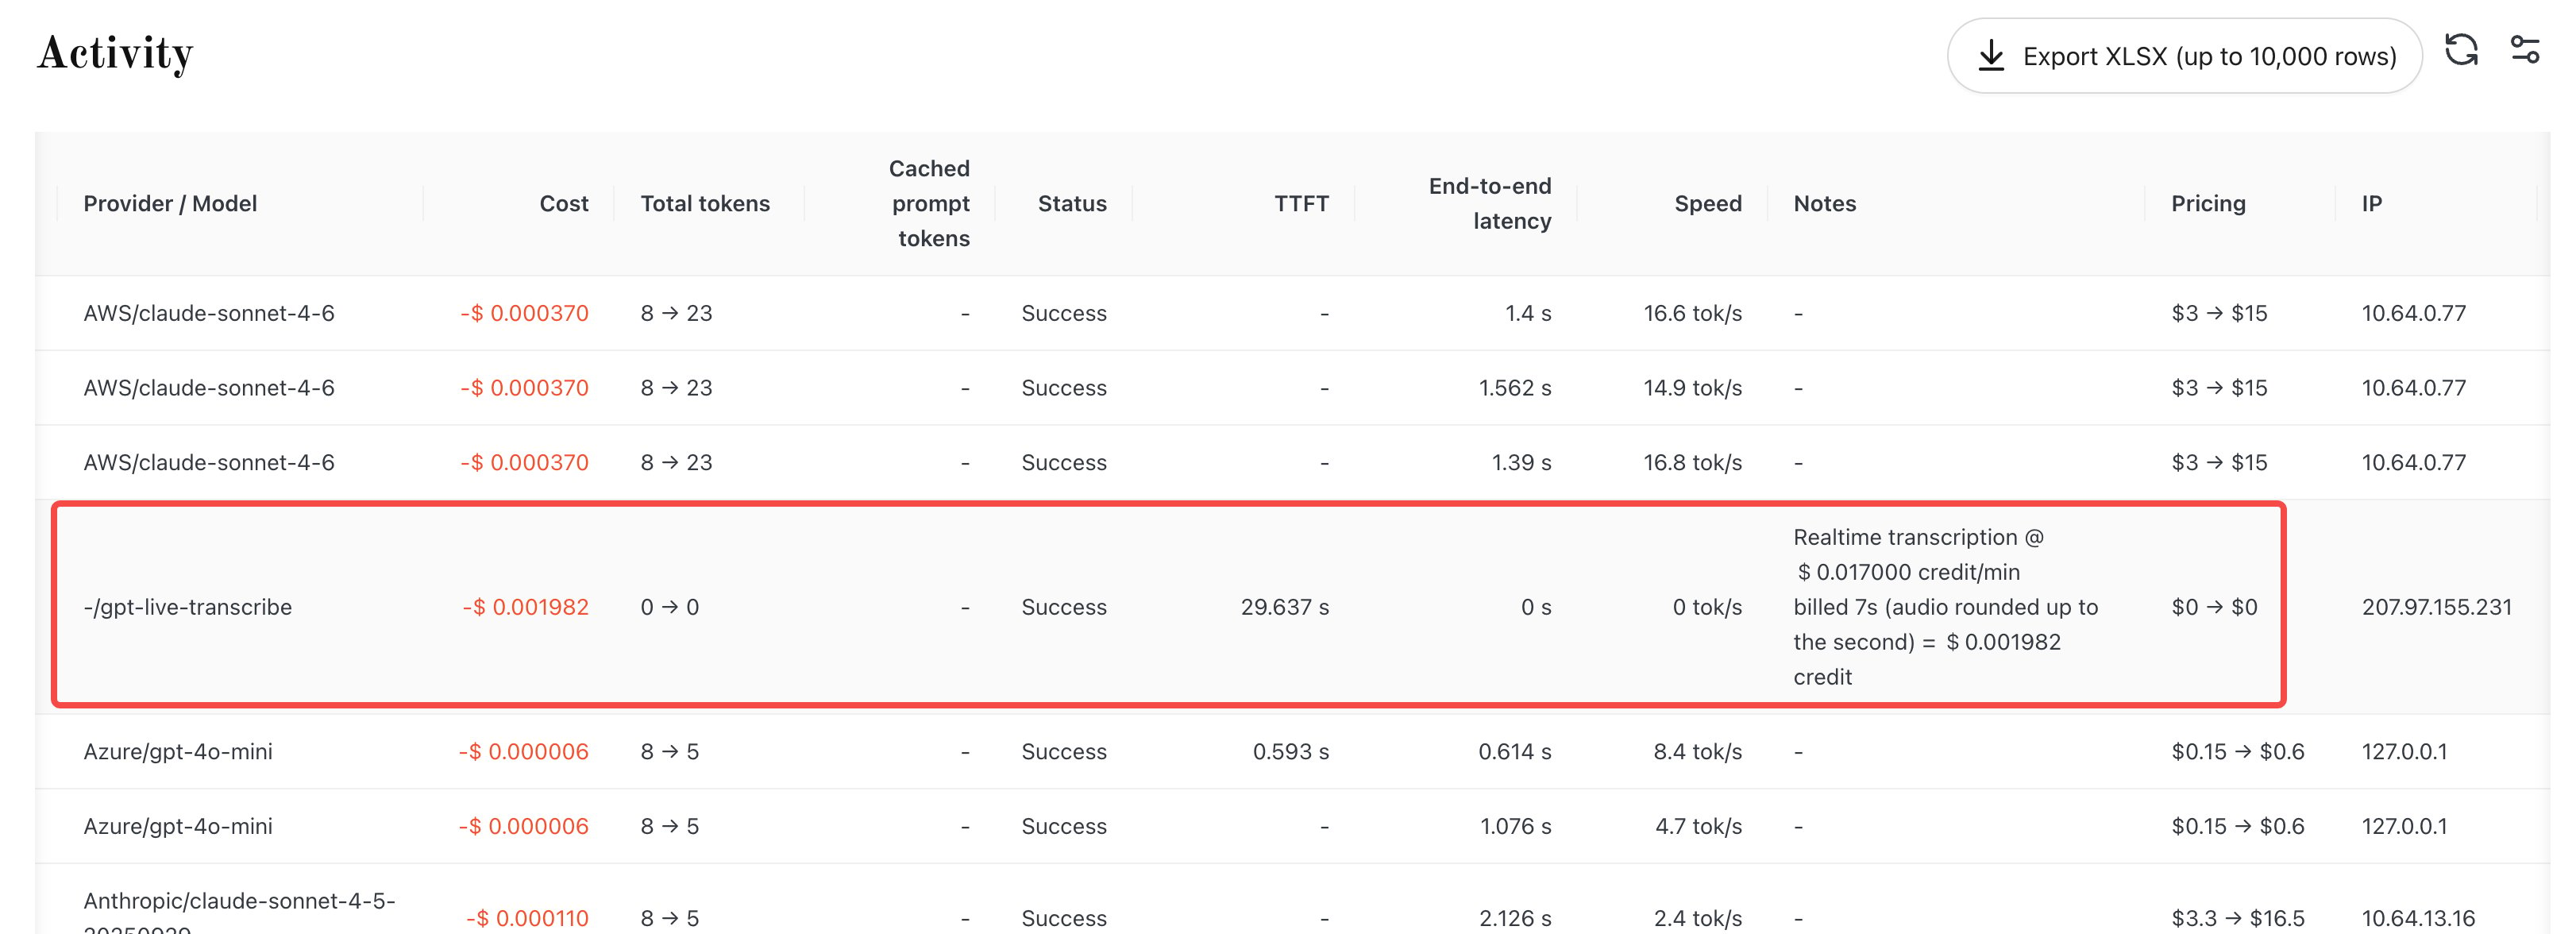
使用量と請求の Activity にある gpt-live-transcribe リアルタイム転写の課金レコード。備考には 7 秒の音声を $0.017 / 分で課金し $0.001982 と記載され、上記の形式と一致します。
制限と制約
- 単一セッションの長さ:1本の WebSocket 接続は最長 62 分で、時間になるとサーバー側が能動的に終了します。より長く必要な場合は分割して再接続してください。
- 残高不足:2つのケースに分かれます —— セッション確立時に利用可能残高が約1分の予約額度を賄えない場合、ハンドシェイクが直接拒否され(HTTP 403)、セッションは確立しません。セッション進行中に残高が枯渇した場合(20秒ごとの更新審査または区間課金後の再チェックで判明)、確立済みの接続は即座に終了されます。
- サーバーサイドのみ:ブラウザからの直接接続はサポートしません(
Originヘッダーを検証)。サーバーサイドで統合してください。 - モデルロック:モデルは接続 URL で固定され、セッション中に
session.updateでモデルを変更すると拒否されセッションが終了します。 - 形式ロック:
audio/pcm@24000モノラルのみをサポートし、他の形式は拒否されます。
よくあるエラー
最終更新日:2026-09-16