LiteLLM 概覽
LiteLLM 是由 BerriAI 開發的開源統一 AI 閘道。它提供單一標準化介面以呼叫市面上幾乎所有主要 LLM。 儲存庫:https://github.com/BerriAI/litellm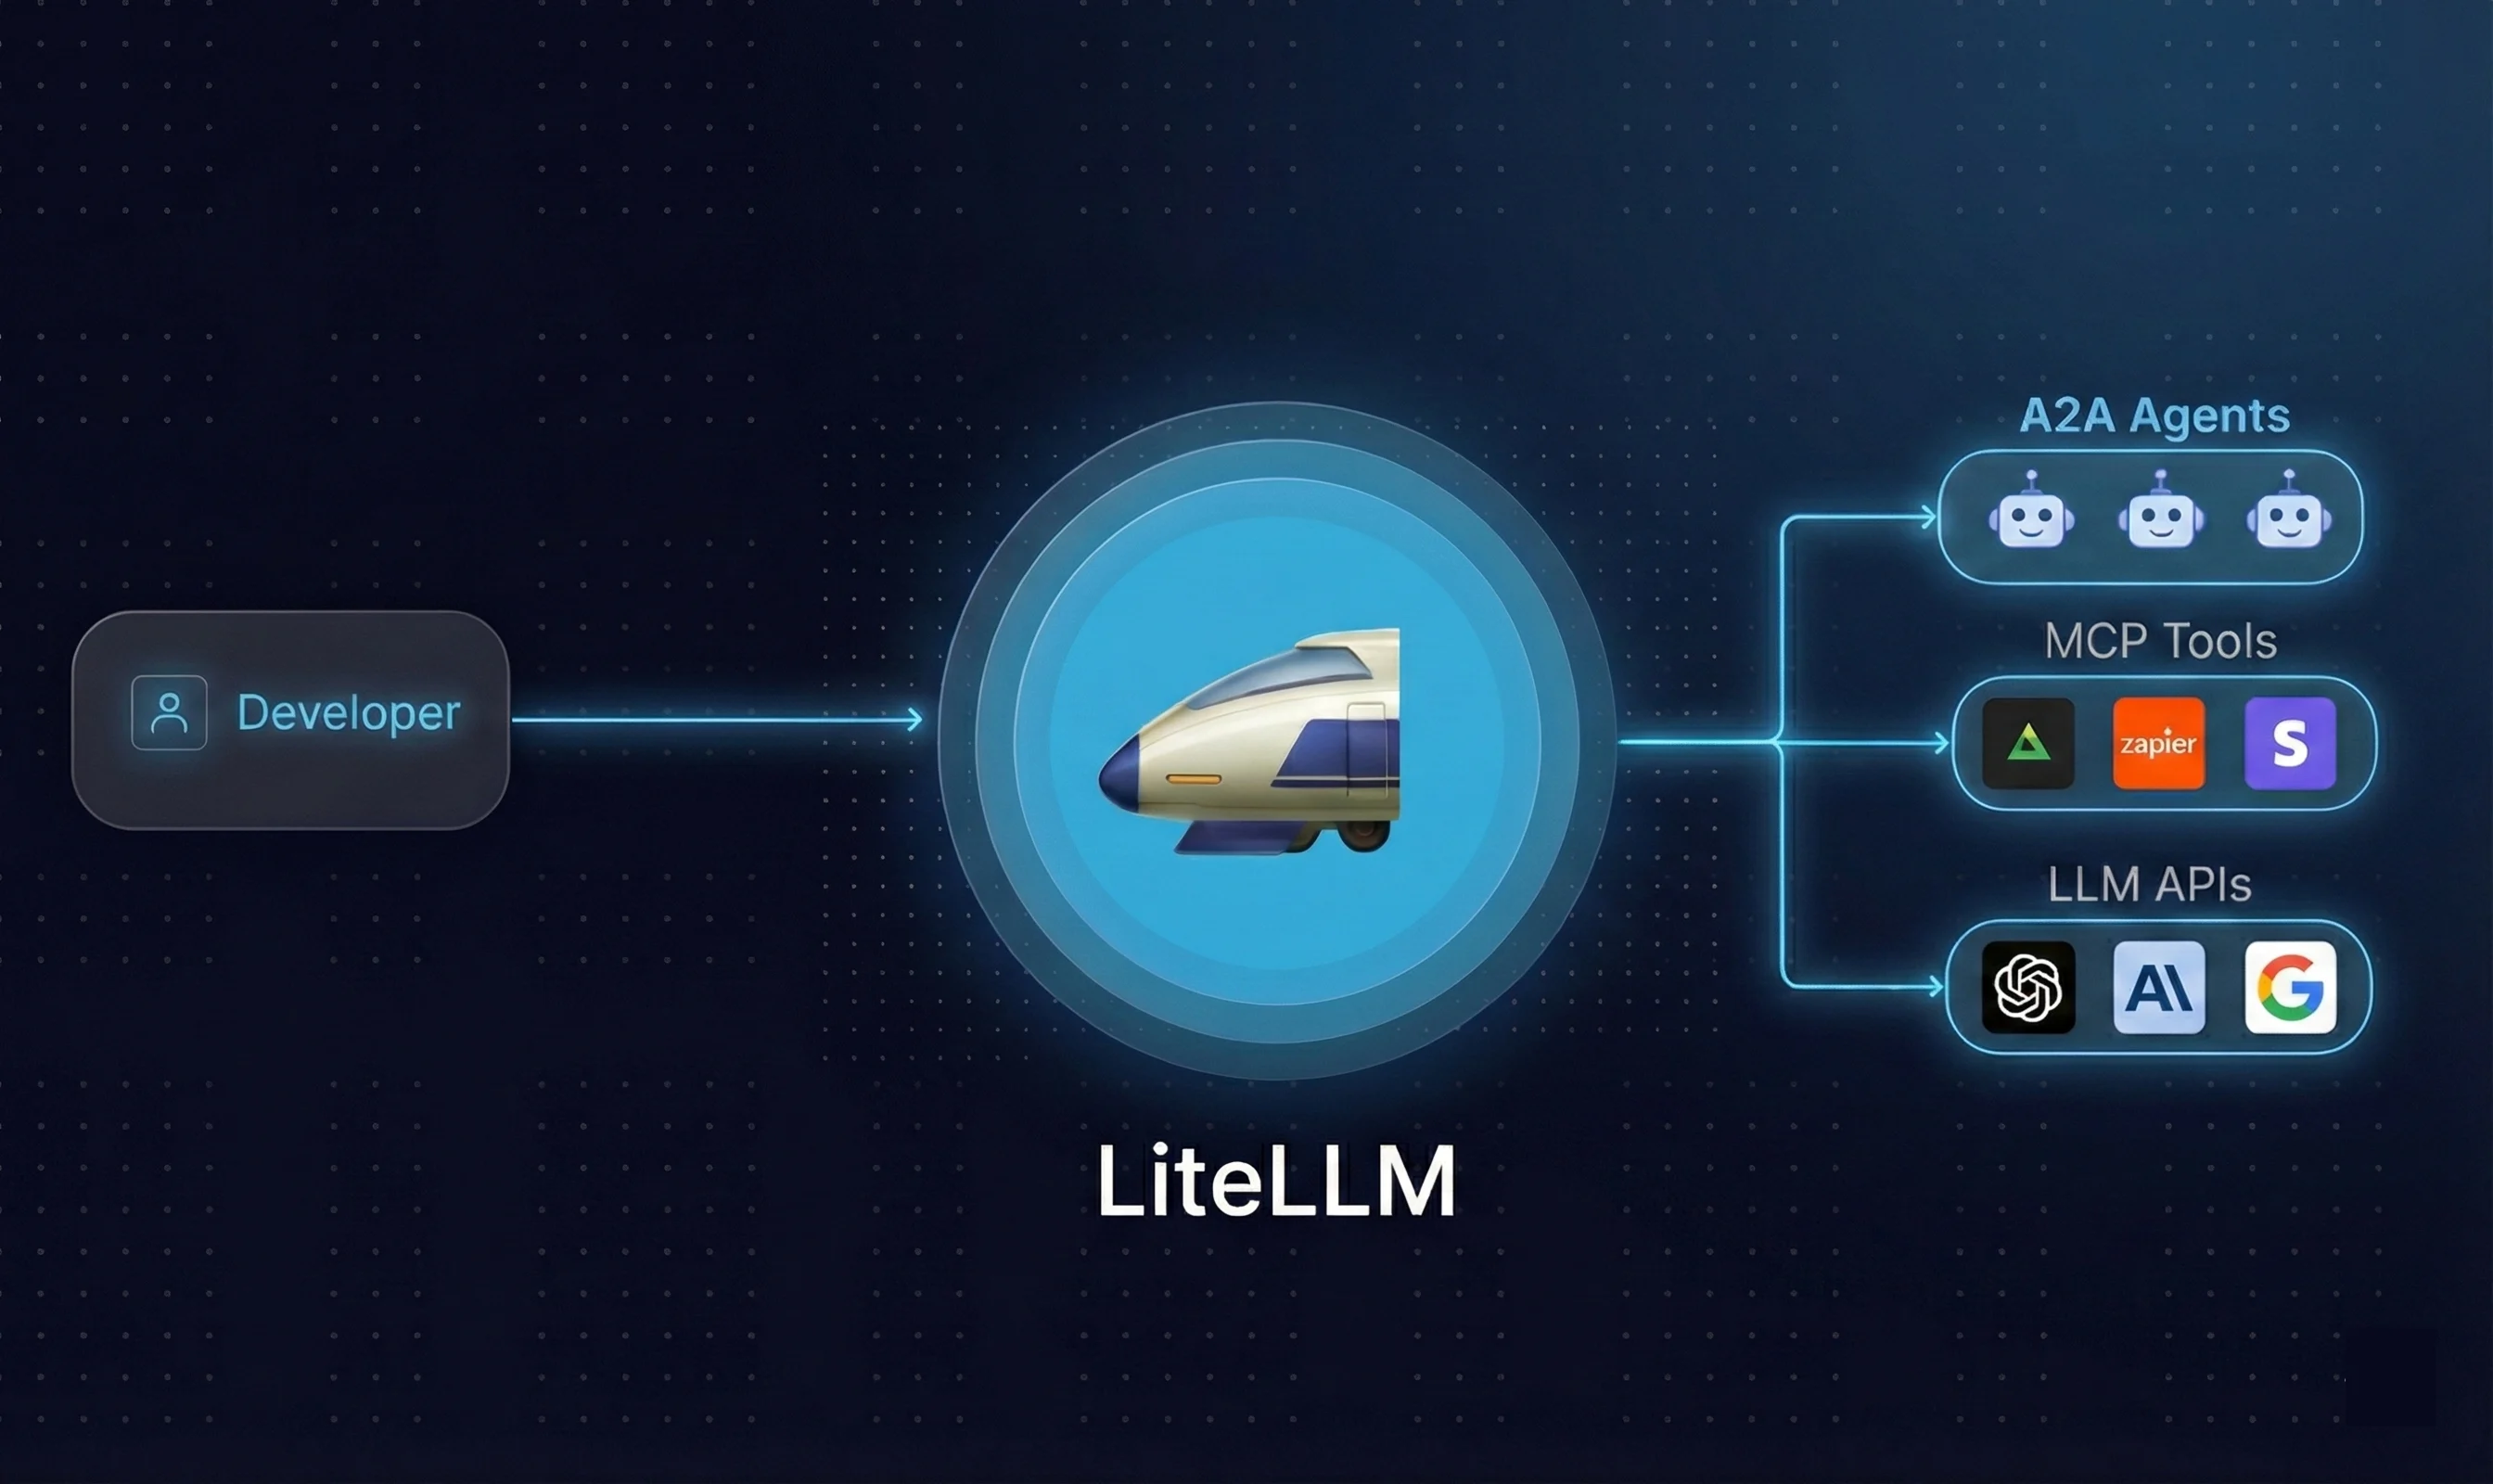
兩種使用模式
核心能力
- 統一的 OpenAI 格式:支援 OpenAI、Anthropic、Gemini、Bedrock、Azure 等 100+ 供應商
- 虛擬 key 管理:集中管理團隊 API key,不需要暴露原始 key
- 成本追蹤:依使用者或專案監控 token 用量與花費
- 負載平衡:跨模型自動分配流量,支援容錯切換
- 高效能:1,000 RPS 下 P95 延遲約 8ms
安裝
系統需求
Python 3.8+ macOS 透過 Homebrew 安裝:pip
pip 通常與 Python 一同附帶。驗證是否可用:安裝 LiteLLM
環境準備好之後:選用相依套件
某些供應商需要額外的套件:安裝 Proxy Server
如要部署獨立閘道:Docker(選用)
建議:個人開發使用 pip install litellm;團隊部署選擇 Proxy + Docker。
設定 API Key 並進行第一次呼叫
取得您的 AiHubMix API Key
前往 aihubmix.com 儀表板並建立 API key。設定環境變數
第一次呼叫
基本用法
1. 切換模型
AiHubMix 支援所有主流模型。切換只需更改model 參數:
2. 串流輸出
加上stream=True 即可逐 token 接收輸出:
3. 多輪對話
在messages 清單中傳入對話歷史,讓模型記住上下文:
4. 非同步呼叫
同時傳送多個請求而無需逐一等待:5. 逾時與重試
避免請求因網路問題而懸停或失敗:timeout以秒為單位。num_retries建議設為 2-3;過高的值會拖慢回應速度。
6. Token 使用量與成本追蹤
每次回應都包含 token 使用資料:7. 負載平衡與容錯切換
設定多個模型可自動分配流量,並在其中之一失敗時切換到備援:
兩個模型共用同一個 model_name。LiteLLM 會在它們之間輪詢,並在其中之一傳回錯誤時自動容錯切換。
8. 部署 Proxy Server
Proxy Server 是獨立的閘道。團隊成員透過它路由所有請求,而無需自己的 API key。 安裝
此處的 api_key 可以是任意字串。真實的 AiHubMix key 由 Proxy 管理。
9. 虛擬 Key 管理
虛擬 key 讓您可以為不同團隊成員或專案指派獨立的 key,在不暴露真實 AiHubMix key 的情況下控制存取與用量。 前置需求:啟動 PostgreSQL 執行個體key 欄位就是虛擬 key,例如 sk-xxxxxx。
使用虛擬 key
每個虛擬 key 都支援獨立的模型限制、預算上限與到期時間 — 非常適合多成員的團隊工作流程。
實戰範例:多模型比較
同時將相同問題傳送至多個模型,並比較輸出品質、速度與 token 用量。 設定 API Key