

介紹
即時語音轉錄透過 WebSocket(一種在用戶端與伺服器端之間保持長連線、可雙向推送資料的協定)建立持久連線,將持續輸入的音訊串流邊接收、邊轉寫、邊返回,適合對延遲敏感的語音情境。 它與檔案轉錄 STT 的區別:
可用模型:
- gpt-live-transcribe —— 串流轉錄模型,支援多語言,隨音訊輸入即時輸出轉寫文字。
快速開始
連線端點
intent=transcription—— 必填,宣告這是一條轉錄工作階段。model=gpt-live-transcribe—— 必填,模型在連線時由 URL 參數固定,工作階段中不可再更改(見下方約束)。
鑑權
握手時透過標準 HTTP 標頭傳入金鑰:音訊格式要求
目前僅支援一種輸入格式,傳送前請將音訊轉換為:- 編碼:PCM16(16 位元有號整數,小端序)
- 採樣率:24000 Hz
- 聲道:單聲道(mono)
audio/pcm@24000。傳送非該格式(如 G.711/µ-law)會被拒絕並關閉工作階段。
轉錄工作階段不支援語音活動偵測(turn_detection / VAD),必須明確設為
null。若省略或傳入非 null 值,模型推理廠商會以 invalid_value 拒絕轉錄。閘道會對轉發的配置強制把 turn_detection 設為 null,但仍建議你在用戶端主動設為 null 以保持行為清晰。工作階段配置(session.update)
連線建立後,用戶端先發送一則session.update 配置轉錄參數。若你不發送,閘道會用授權模型注入一份預設配置作為後備,但建議明確配置。
配置參數
string
必填
工作階段類型,轉錄情境固定為
transcription。object
必填
輸入音訊格式,固定為
{ "type": "audio/pcm", "rate": 24000 }。string
必填
轉錄模型。必須與連線 URL 的
model 一致(gpt-live-transcribe)。傳入其他模型視為越權,工作階段將被以 1008 關閉。string[]
預期語言清單,陣列形式(如
["en", "zh"])。gpt-live-transcribe 用複數 languages,可一次宣告多種語言;指定語言能提升準確性並降低延遲。取值字典見下方 語言代碼。string
單數寫法,單個 ISO-639-1 代碼(如
"en")。與 languages 二選一,不要同時傳入(同時傳入會被以 invalid_value 拒絕)。官方對 gpt-live-transcribe 推薦用複數 languages;單數 language 閘道也接受,便於從舊程式碼遷移。string
自由文字提示,描述錄音情境(如「客服通話」「含醫學術語的問診」),幫助模型貼合語域。實測伺服器端會在
session.updated 中原樣回顯,已生效。string[]
字面提示詞陣列,用於產品名、縮寫、專有名詞等易錯詞(如
["AiHubMix", "gpt-live-transcribe"])。它是提示而非強制輸出;每個詞單獨一項,避免包含 <、>、換行符號。實測已回顯生效。string
延遲 / 準確率檔位,可選值
minimal、low、medium、high、xhigh——檔位越高越準但延遲越大。注意:閘道接受該欄位(不報錯),但實測未在 session.updated 中回顯,生效性以官方文件為準、暫未由回顯確認。null
必填
語音活動偵測。轉錄工作階段必須為
null。object
可選的降噪配置,如
{ "type": "near_field" }(近場,適合麥克風貼近說話者)或 { "type": "far_field" }(遠場)。語言代碼(language codes)
languages / language 的取值遵循以下格式,大小寫敏感、必須是下方支援的形式,傳入不支援或格式錯誤的代碼會被 realtime API 拒絕:
傳送音訊
將 PCM16 音訊切成小片(如每 100ms 一片),base64 編碼後透過input_audio_buffer.append 事件持續傳送:
input_audio_buffer.commit 標記該段結束,觸發轉錄收尾並返回 completed 結果:
接收轉錄結果
伺服器端會持續推送事件,關鍵事件類型:event
工作階段建立、配置更新的確認。
event
轉錄增量結果,欄位
delta 是本次新增的文字片段。邊說邊返回,適合即時顯示到畫面上。event
一段語音轉錄完成,欄位
transcript 是該段的完整文字。event
錯誤事件,包含錯誤碼與說明。
完整範例
以下給出兩種寫法,任選其一:- OpenAI 官方 SDK(推薦):無需手寫 WebSocket,把
websocket_base_url(SDK 的 WebSocket 基底位址參數)指到閘道即可沿用官方函式庫。 - 原生 websockets:不安裝 SDK,直接依協定收發訊框,相依最少、便於排查。
為什麼官方 demo 不傳模型名,我們卻要傳? OpenAI 的轉錄 intent 把模型放在
session.update 的 transcription.model 裡,連線 URL 只帶 ?intent=transcription。AiHubMix 閘道不同:模型名必須出現在握手 URL(?model=gpt-live-transcribe)——因為閘道在 WebSocket 握手那一刻就要用它選擇模型推理廠商、鑑權、預留額度,而 session.update 是握手完成之後才到、來不及。所以用 SDK 時要給 connect() 明確傳入 model(SDK 會把它拼進 URL query);缺了它閘道在握手期就回 400 missing_model_parameter——connect() 直接拋出例外、連線根本建不起來,壓根進不到 session.update 那一步。工作階段內 transcription.model 仍需與 URL 一致。執行效果(線上實測)
以下為上述範例在aihubmix.com 線上環境(模型 gpt-live-transcribe)的真實執行結果。配置了 languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" }:
實測中
languages、prompt、keywords、noise_reduction 均被伺服器端在 session.updated 中原樣回顯,說明配置已實際生效並被套用。delay 欄位閘道接受但不回顯,生效性以官方文件為準;language(單數)與 languages(複數)二者只能傳其一。計費說明
- 單價:
gpt-live-transcribe按 $0.017 / 分鐘 計費(以模型詳情頁即時掛牌價為準)。 - 按轉錄的音訊時長計費:以實際轉發到轉錄模型的音訊秒數為準,無條件進位到整秒。例如轉錄 90 秒音訊,計費
90 ÷ 60 × $0.017 = $0.0255。 - 計費不受網路往返或閒置等待影響,只對真正送入轉錄的音訊計時。
- 邊用邊結算:這是一條長連線,費用在工作階段過程中分段即時扣除,工作階段結束時不再一次性結算。建立工作階段時會先按約 1 分鐘用量做一次額度預留(僅作准入校驗,不會真實扣費);工作階段中每 20 秒滾動續期一次預留,實際費用按真實轉發秒數分段扣除,工作階段結束後釋放剩餘預留。因此帳戶可用餘額至少要夠約 1 分鐘的用量,工作階段才能建立。
- 在 用量與帳單 的消費明細裡,每條即時轉錄記錄的備註會標註「每分鐘單價」與「本次實收秒數」,方便逐筆核對。
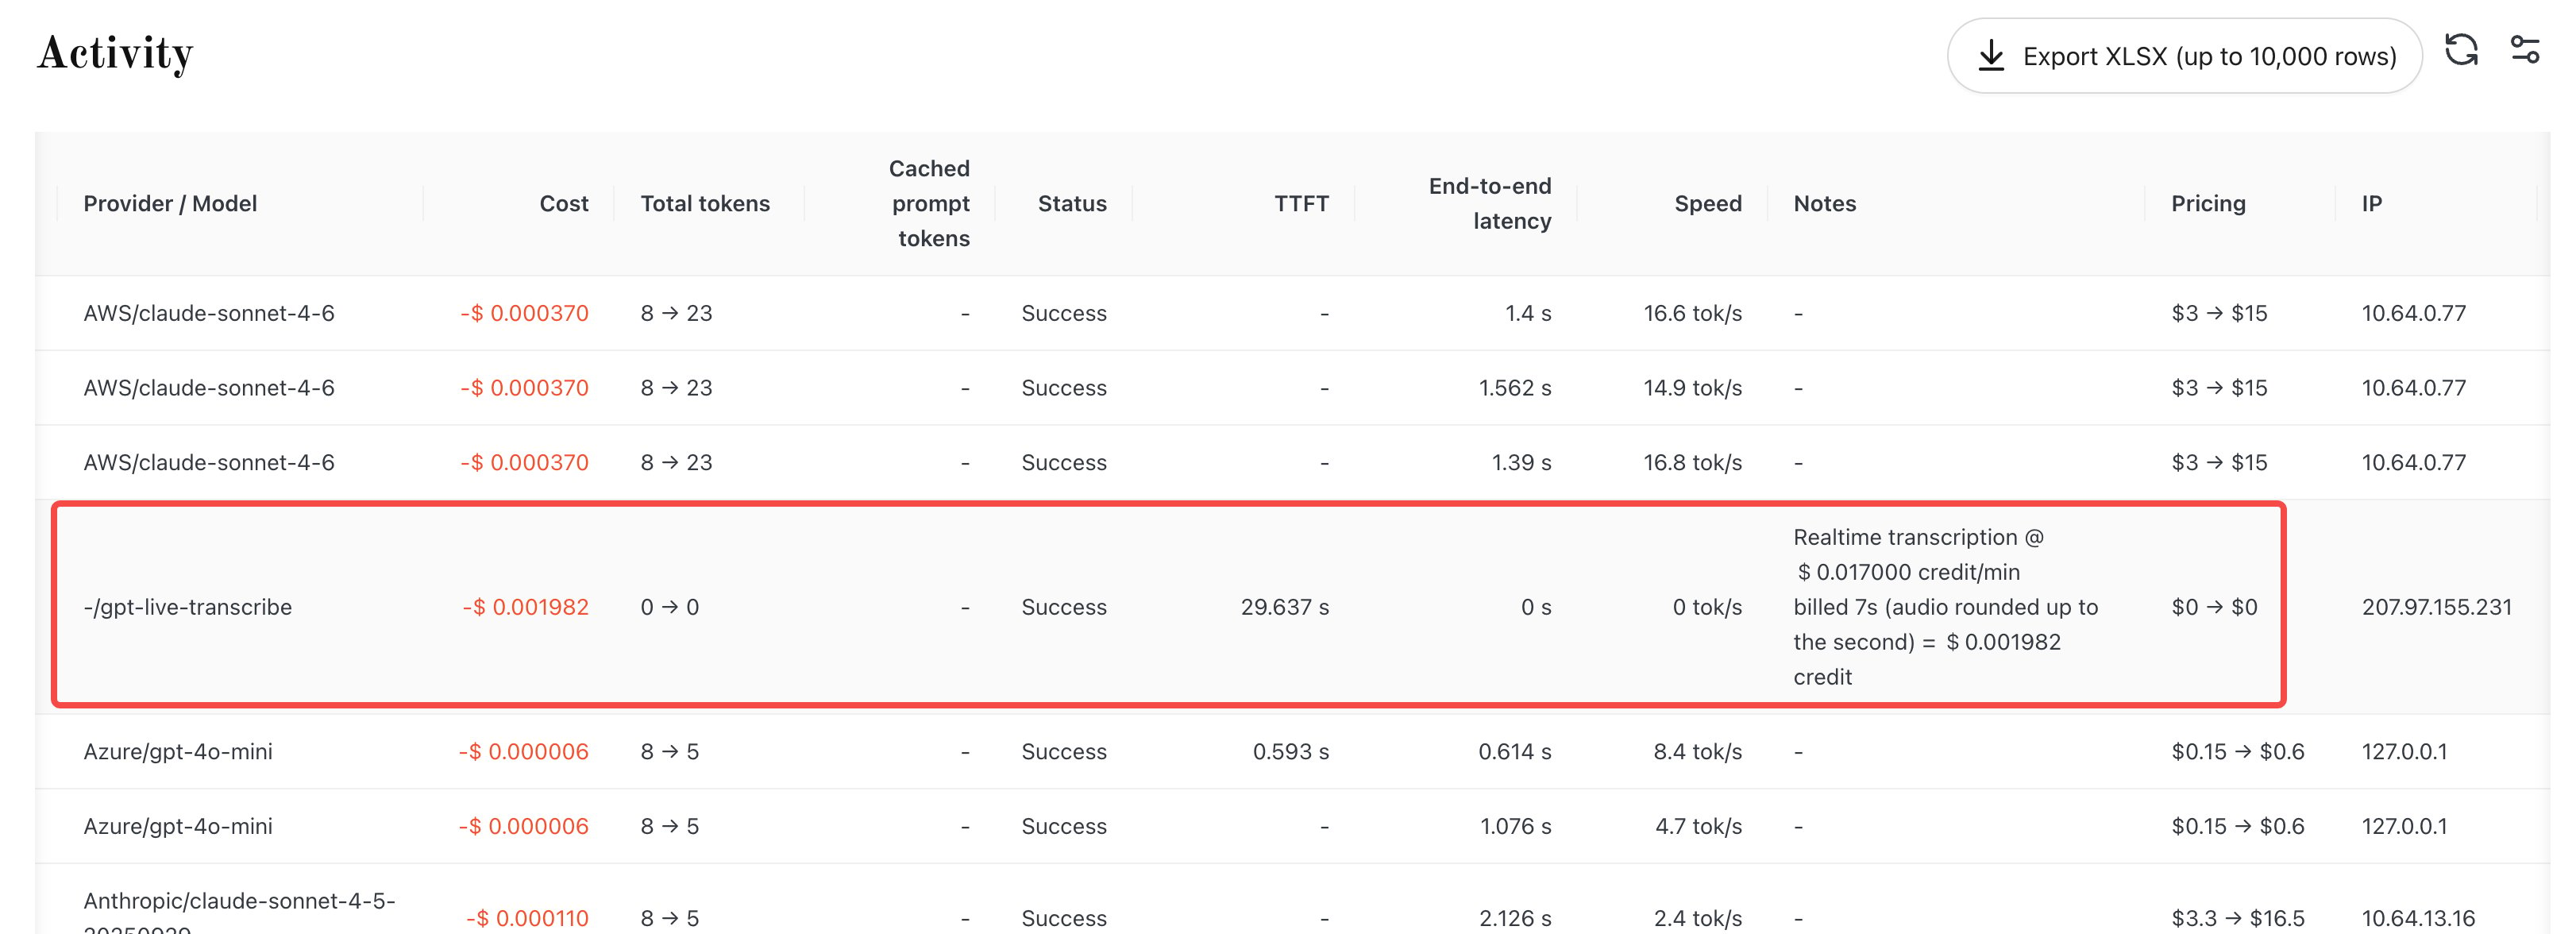
用量與帳單 Activity 中的一條 gpt-live-transcribe 即時轉錄計費記錄,備註標註按 7 秒音訊 × $0.017 / 分鐘計費,實收 $0.001982,與上文口徑一致。
限制與約束
- 單一工作階段時長:一條 WebSocket 連線最長 62 分鐘,到時伺服器端主動關閉;需要更長請分段重新連線。
- 餘額不足:分兩種情況——建立工作階段時可用餘額不足以涵蓋約 1 分鐘的預留額度,握手直接被拒(HTTP 403),工作階段不會建立;工作階段進行中若餘額耗盡(每 20 秒的續期校驗或分段扣費後複查發現),已建立的連線會被立即關閉。
- 僅伺服器端:不支援瀏覽器直接連線(校驗
Origin標頭),請在伺服器端整合。 - 模型鎖定:模型在連線 URL 固定,工作階段中透過
session.update變更模型會被拒絕並關閉工作階段。 - 格式鎖定:僅支援
audio/pcm@24000單聲道,其他格式會被拒絕。
常見錯誤
最後更新:2026-09-16