

소개
실시간 음성 전사는 WebSocket(클라이언트와 서버 사이에 장시간 연결을 유지하며 양방향으로 데이터를 푸시할 수 있는 프로토콜)으로 지속 연결을 맺어, 계속 입력되는 오디오 스트림을 받으면서 전사하고 반환하므로 지연에 민감한 음성 시나리오에 적합합니다. 파일 전사 STT와의 차이점:
사용 가능한 모델:
- gpt-live-transcribe —— 스트리밍 전사 모델, 다국어 지원, 오디오 입력에 맞춰 전사 텍스트를 실시간 출력.
빠른 시작
연결 엔드포인트
intent=transcription—— 필수, 이 연결이 전사 세션임을 선언합니다.model=gpt-live-transcribe—— 필수, 모델은 연결 시 URL 파라미터로 고정되며 세션 중에는 변경할 수 없습니다(아래 제약 참조).
인증
핸드셰이크 시 표준 HTTP 헤더로 API 키를 전달합니다:오디오 형식 요구사항
현재 한 가지 입력 형식만 지원하므로, 전송 전에 오디오를 다음 형식으로 변환하십시오:- 인코딩: PCM16(16비트 부호 있는 정수, 리틀 엔디언)
- 샘플링 레이트: 24000 Hz
- 채널: 모노(mono)
audio/pcm@24000입니다. 해당 형식이 아닌 오디오(예: G.711/µ-law)를 전송하면 거부되고 세션이 종료됩니다.
전사 세션은 음성 활동 감지(turn_detection / VAD)를 지원하지 않으므로, 반드시 명시적으로
null로 설정해야 합니다. 생략하거나 null이 아닌 값을 전달하면 모델 프로바이더가 invalid_value로 전사를 거부합니다. 게이트웨이는 전달되는 설정에서 turn_detection을 강제로 null로 지정하지만, 동작을 명확히 유지하기 위해 클라이언트에서도 능동적으로 null로 설정할 것을 권장합니다.세션 설정(session.update)
연결이 수립되면 클라이언트가 먼저session.update 프레임 하나를 보내 전사 파라미터를 설정합니다. 보내지 않으면 게이트웨이가 인가된 모델로 기본 설정을 주입하여 대비하지만, 명시적으로 설정하는 것을 권장합니다.
설정 파라미터
string
필수
세션 유형, 전사 시나리오에서는
transcription으로 고정됩니다.object
필수
입력 오디오 형식,
{ "type": "audio/pcm", "rate": 24000 }으로 고정됩니다.string
필수
전사 모델. 연결 URL의
model과 일치해야 합니다(gpt-live-transcribe). 다른 모델을 전달하면 권한 초과로 간주되어 세션이 1008로 종료됩니다.string[]
예상 언어 목록, 배열 형식(예:
["en", "zh"]). gpt-live-transcribe는 복수형 languages를 사용하여 한 번에 여러 언어를 선언할 수 있으며, 언어를 지정하면 정확도가 향상되고 지연이 줄어듭니다. 값 사전은 아래 언어 코드를 참조하십시오.string
단수형 표기, 단일 ISO-639-1 코드(예:
"en"). languages와 둘 중 하나만 전달하며, 동시에 전달하지 마십시오(동시 전달 시 invalid_value로 거부됩니다). 공식에서는 gpt-live-transcribe에 복수형 languages 사용을 권장하며, 단수형 language도 게이트웨이가 수용하므로 기존 코드에서 마이그레이션하기 편합니다.string
녹음 시나리오(예: 「고객 상담 통화」, 「의학 용어가 포함된 진료」)를 설명하는 자유 텍스트 프롬프트로, 모델이 언어역(register)에 맞도록 돕습니다. 실측 결과 서버가
session.updated에서 그대로 에코백하며 이미 적용됩니다.string[]
제품명, 약어, 고유명사 등 오류가 나기 쉬운 단어를 위한 리터럴 힌트 배열(예:
["AiHubMix", "gpt-live-transcribe"]). 이는 힌트이며 강제 출력이 아닙니다. 각 단어를 개별 항목으로 두고, <, >, 줄바꿈 문자를 포함하지 않도록 하십시오. 실측 결과 에코백되어 적용됩니다.string
지연 / 정확도 등급, 선택 가능한 값은
minimal, low, medium, high, xhigh으로, 등급이 높을수록 더 정확하지만 지연이 커집니다. 주의: 게이트웨이는 이 필드를 수용하지만(오류를 내지 않음), 실측 결과 session.updated에서 에코백되지 않으므로 적용 여부는 공식 문서를 기준으로 하며 에코백으로는 아직 확인되지 않았습니다.null
필수
음성 활동 감지. 전사 세션에서는 반드시
null이어야 합니다.object
선택적 노이즈 제거 설정, 예:
{ "type": "near_field" }(근거리, 마이크가 화자에 가까운 경우에 적합) 또는 { "type": "far_field" }(원거리).언어 코드(language codes)
languages / language의 값은 다음 형식을 따르며, 대소문자를 구분하고 반드시 아래 지원 형식이어야 합니다. 지원되지 않거나 형식이 잘못된 코드를 전달하면 realtime API가 거부합니다:
오디오 전송
PCM16 오디오를 작은 청크(예: 100ms마다 하나)로 나누고, base64로 인코딩한 뒤input_audio_buffer.append 이벤트로 지속 전송합니다:
input_audio_buffer.commit 프레임을 하나 보내 해당 세그먼트의 종료를 표시해야 하며, 이로써 전사 마무리가 트리거되어 completed 결과가 반환됩니다:
전사 결과 수신
서버는 이벤트를 지속적으로 푸시합니다. 주요 이벤트 유형:event
세션 생성, 설정 업데이트의 확인.
event
전사 증분 결과,
delta 필드는 이번에 새로 추가된 텍스트 조각입니다. 말하면서 반환되므로 실시간 화면 표시에 적합합니다.event
한 세그먼트의 음성 전사가 완료됨,
transcript 필드는 해당 세그먼트의 완전한 텍스트입니다.event
오류 이벤트, 오류 코드와 설명을 포함합니다.
완전한 예제
아래 두 가지 방식 중 하나를 선택하십시오:- OpenAI 공식 SDK(권장): WebSocket을 직접 작성할 필요 없이
websocket_base_url(SDK의 WebSocket 기본 주소 파라미터)을 게이트웨이로 지정하면 공식 라이브러리를 재사용할 수 있습니다. - 네이티브 websockets: SDK를 설치하지 않고 프로토콜에 따라 직접 프레임을 주고받으며, 의존성이 최소이고 문제 해결에 편리합니다.
왜 공식 데모는 모델명을 전달하지 않는데 우리는 전달해야 하는가? OpenAI의 전사 intent는 모델을
session.update의 transcription.model에 두고, 연결 URL에는 ?intent=transcription만 붙입니다. AiHubMix 게이트웨이는 다릅니다. 모델명이 반드시 핸드셰이크 URL(?model=gpt-live-transcribe)에 나타나야 합니다. 게이트웨이가 WebSocket 핸드셰이크 시점에 그것으로 모델 프로바이더 선택, 인증, 할당량 예약을 해야 하는데, session.update는 핸드셰이크 완료 후에 도착하여 늦기 때문입니다. 그래서 SDK 사용 시 connect()에 model을 명시적으로 전달해야 합니다(SDK가 이를 URL 쿼리에 이어 붙입니다). 이것이 빠지면 게이트웨이는 핸드셰이크 단계에서 400 missing_model_parameter를 반환하며, connect()가 곧바로 예외를 던져 연결 자체가 수립되지 않으므로 session.update 단계에는 도달하지도 못합니다. 세션 내 transcription.model은 여전히 URL과 일치해야 합니다.실행 결과(온라인 실측)
아래는 위 예제를aihubmix.com 온라인 환경(모델 gpt-live-transcribe)에서 실제로 실행한 결과입니다. languages: ["en", "zh"] + prompt + keywords + delay: "low" + noise_reduction: { "type": "near_field" }를 설정했습니다:
실측에서
languages, prompt, keywords, noise_reduction은 모두 서버가 session.updated에서 그대로 에코백했으며, 이는 설정이 실제로 적용되었음을 의미합니다(수용만 하고 처리하지 않는 것이 아님). delay 필드는 게이트웨이가 수용하지만 에코백하지 않으므로 적용 여부는 공식 문서를 기준으로 합니다. language(단수)와 languages(복수)는 둘 중 하나만 전달할 수 있습니다.요금 안내
- 단가:
gpt-live-transcribe는 분당 $0.017로 과금됩니다(모델 상세 페이지의 실시간 게시 가격 기준). - 전사한 오디오 길이에 따라 과금됩니다: 실제로 전사 모델에 전달된 오디오의 초 단위를 기준으로 하며, 정수 초로 올림합니다. 예를 들어 90초 오디오를 전사하면
90 ÷ 60 × $0.017 = $0.0255가 과금됩니다. - 과금은 네트워크 왕복이나 유휴 대기의 영향을 받지 않고, 실제로 전사에 투입된 오디오에 대해서만 시간을 계산합니다.
- 사용하면서 정산: 이것은 장시간 연결이므로, 비용은 세션 종료 후 한 번에 정산되지 않고 세션 진행 중 세그먼트 단위로 실시간 차감됩니다. 세션을 수립할 때 먼저 약 1분 사용량으로 한 번 할당량 예약을 합니다(진입 검증 용도일 뿐 실제 차감이 아님). 세션 중에는 20초마다 예약을 롤링 갱신하고, 실제 비용은 실제 전달된 초 단위에 따라 세그먼트 단위로 차감하며, 세션 종료 후 남은 예약을 해제합니다. 따라서 계정의 사용 가능한 잔액이 최소 약 1분 사용량을 감당할 수 있어야 세션이 수립됩니다.
- 사용량 및 청구의 소비 내역에서, 각 실시간 전사 기록의 비고에 「분당 단가」와 「이번에 실제 과금된 초 단위」가 표기되어 항목별로 대조하기 편합니다.
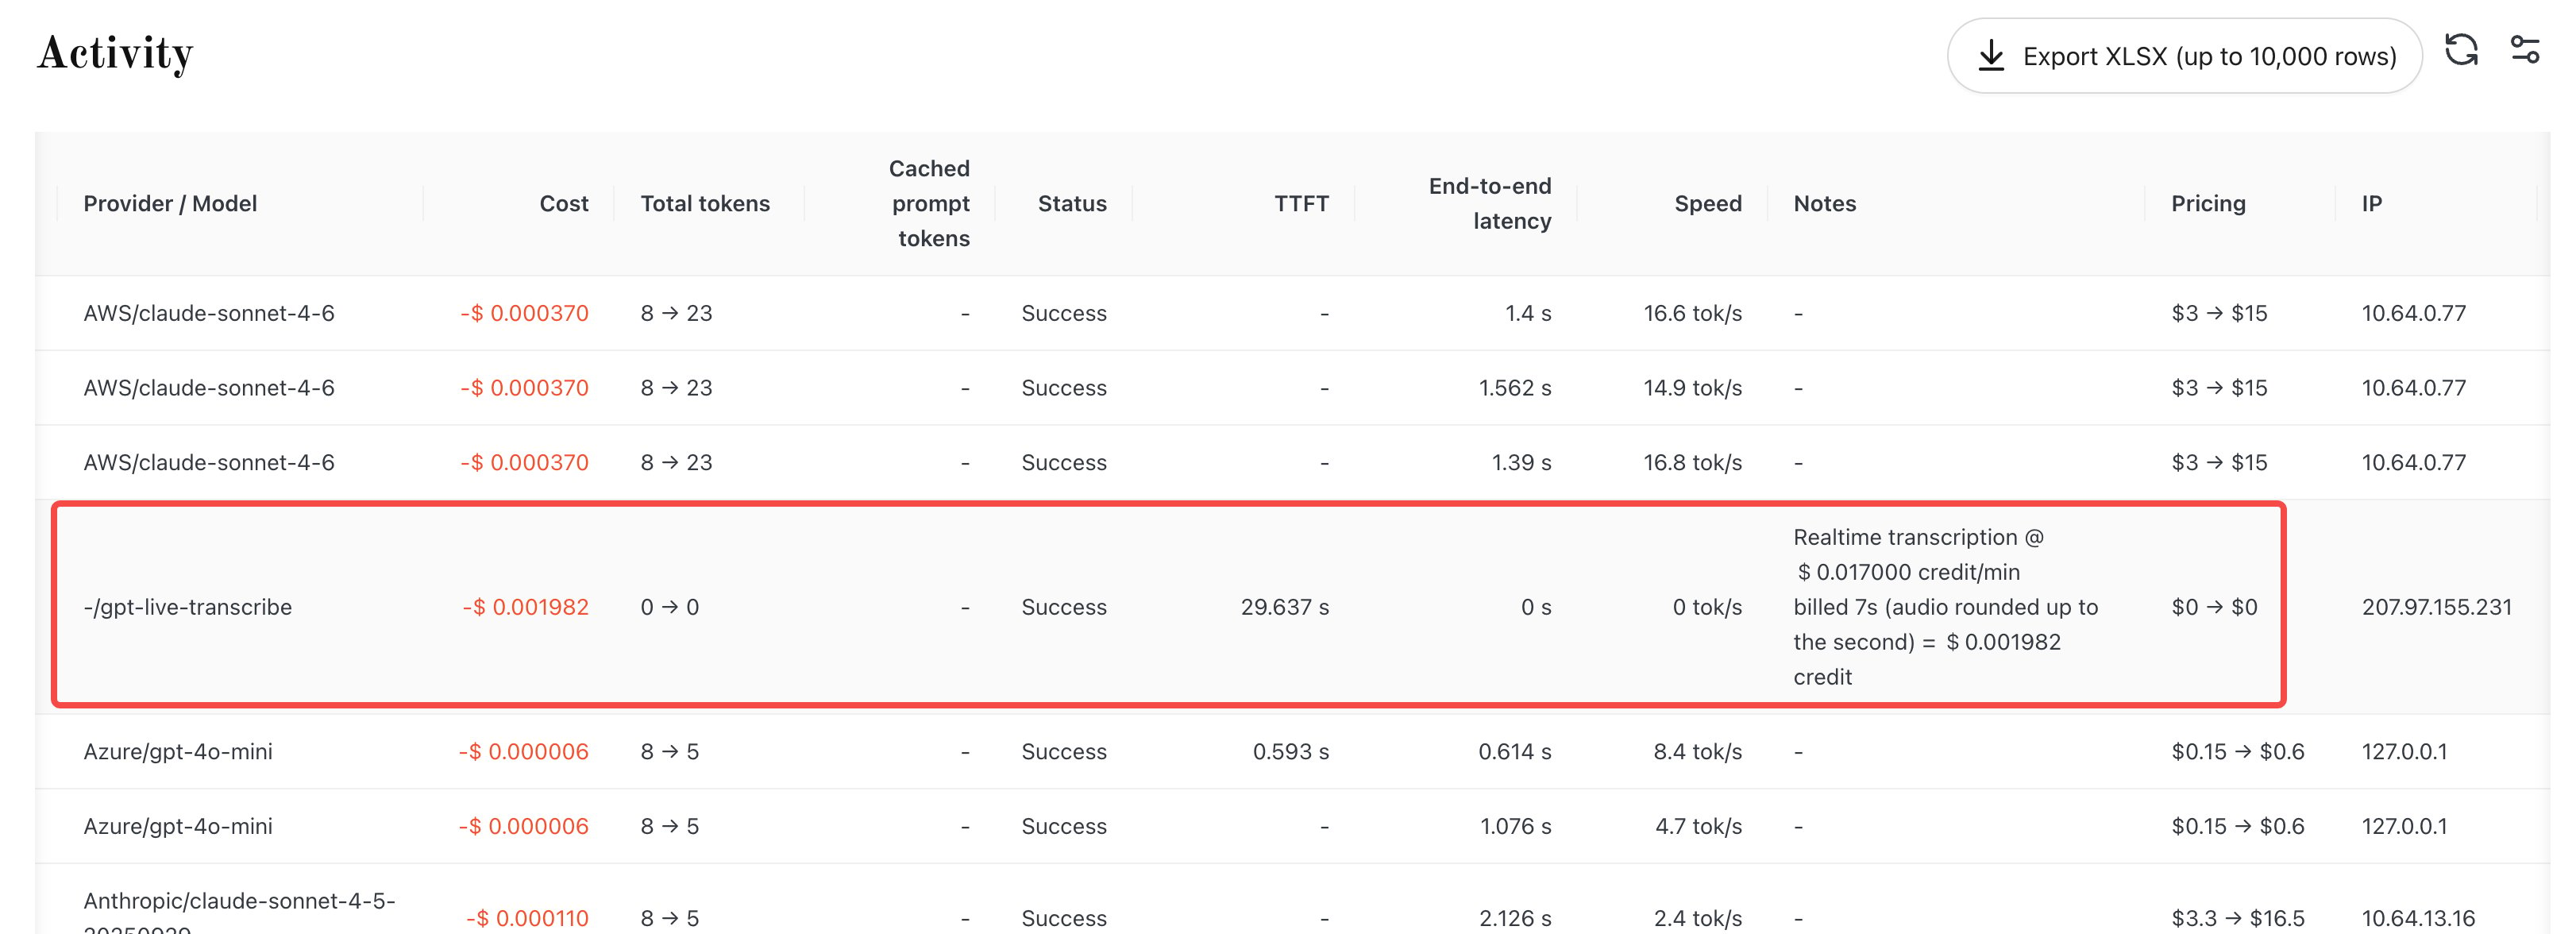
사용량 및 청구 Activity 화면의 gpt-live-transcribe 실시간 전사 과금 기록. 비고에는 7초 오디오를 $0.017 / 분으로 과금해 $0.001982로 표기되며 위 형식과 일치합니다.
제한 및 제약
- 단일 세션 길이: 하나의 WebSocket 연결은 최대 62분이며, 시간이 되면 서버가 능동적으로 종료합니다. 더 길게 필요하면 세그먼트로 나누어 재연결하십시오.
- 잔액 부족: 두 가지 경우로 나뉩니다. 세션 수립 시 사용 가능한 잔액이 약 1분 예약 할당량을 감당하지 못하면 핸드셰이크가 곧바로 거부됩니다(HTTP 403). 세션은 수립되지 않습니다. 세션 진행 중 잔액이 소진되면(20초마다의 갱신 검증 또는 세그먼트 차감 후 재확인에서 발견) 이미 수립된 연결이 즉시 종료됩니다.
- 서버 측 전용: 브라우저 직접 연결을 지원하지 않으며(
Origin헤더 검증), 서버 측에서 통합하십시오. - 모델 고정: 모델은 연결 URL에서 고정되며, 세션 중
session.update로 모델을 변경하면 거부되고 세션이 종료됩니다. - 형식 고정:
audio/pcm@24000모노만 지원하며, 다른 형식은 거부됩니다.
자주 발생하는 오류
마지막 업데이트: 2026-09-16