> ## Documentation Index
> Fetch the complete documentation index at: https://docs.aihubmix.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 即時語音轉錄
> 透過 WebSocket 建立持久連線,邊說邊出字,實現低延遲的串流語音轉文字
## 介紹
即時語音轉錄透過 WebSocket(一種在用戶端與伺服器端之間保持長連線、可雙向推送資料的協定)建立持久連線,將持續輸入的音訊串流**邊接收、邊轉寫、邊返回**,適合對延遲敏感的語音情境。
它與檔案轉錄 [STT](/zh-Hant/api/STT) 的區別:
| 維度 | 檔案轉錄(STT) | 即時轉錄(本頁) |
| -- | --------------- | ------------------ |
| 協定 | HTTP,一次請求返回完整結果 | WebSocket,持續推送增量結果 |
| 輸入 | 完整音訊檔案(≤25MB) | 連續音訊串流(PCM 分片) |
| 延遲 | 等整段處理完 | 說話過程中即返回文字 |
| 適用 | 錄音轉寫、字幕生成 | 會議即時字幕、語音助理、直播聽寫 |
**可用模型:**
* **gpt-live-transcribe** —— 串流轉錄模型,支援多語言,隨音訊輸入即時輸出轉寫文字。
**本 API 面向伺服器端整合,瀏覽器無法直接連線。** 基於安全考量,閘道會校驗並拒絕帶 `Origin` 標頭的連線、拒絕 `openai-insecure-api-key` 子協定,金鑰只接受標準 `Authorization` 標頭。瀏覽器發起的 WebSocket 會自動附帶 `Origin` 標頭,因此會被拒絕。若需在前端做即時轉錄,請在你自己的伺服器端建立到閘道的連線,再把結果轉發給前端。
## 快速開始
### 連線端點
```text theme={null}
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe
```
* `intent=transcription` —— **必填**,宣告這是一條轉錄工作階段。
* `model=gpt-live-transcribe` —— **必填**,模型在連線時由 URL 參數固定,工作階段中不可再更改(見下方約束)。
### 鑑權
握手時透過標準 HTTP 標頭傳入金鑰:
```text theme={null}
Authorization: Bearer $AIHUBMIX_API_KEY
```
### 音訊格式要求
目前僅支援一種輸入格式,傳送前請將音訊轉換為:
* **編碼**:PCM16(16 位元有號整數,小端序)
* **採樣率**:24000 Hz
* **聲道**:單聲道(mono)
即 `audio/pcm@24000`。傳送非該格式(如 G.711/µ-law)會被拒絕並關閉工作階段。
**轉錄工作階段不支援語音活動偵測(turn\_detection / VAD)**,必須明確設為 `null`。若省略或傳入非 `null` 值,模型推理廠商會以 `invalid_value` 拒絕轉錄。閘道會對轉發的配置強制把 `turn_detection` 設為 `null`,但仍建議你在用戶端主動設為 `null` 以保持行為清晰。
## 工作階段配置(session.update)
連線建立後,用戶端先發送一則 `session.update` 配置轉錄參數。若你不發送,閘道會用授權模型注入一份預設配置作為後備,但建議明確配置。
```json theme={null}
{
"type": "session.update",
"session": {
"type": "transcription",
"audio": {
"input": {
"format": { "type": "audio/pcm", "rate": 24000 },
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"delay": "low"
},
"turn_detection": null,
"noise_reduction": { "type": "near_field" }
}
}
}
}
```
### 配置參數
工作階段類型,轉錄情境固定為 `transcription`。
輸入音訊格式,固定為 `{ "type": "audio/pcm", "rate": 24000 }`。
轉錄模型。必須與連線 URL 的 `model` 一致(`gpt-live-transcribe`)。傳入其他模型視為越權,工作階段將被以 `1008` 關閉。
預期語言清單,陣列形式(如 `["en", "zh"]`)。`gpt-live-transcribe` 用**複數** `languages`,可一次宣告多種語言;指定語言能提升準確性並降低延遲。取值字典見下方 [語言代碼](#語言代碼language-codes)。
單數寫法,單個 ISO-639-1 代碼(如 `"en"`)。與 `languages` **二選一,不要同時傳入**(同時傳入會被以 `invalid_value` 拒絕)。官方對 `gpt-live-transcribe` 推薦用複數 `languages`;單數 `language` 閘道也接受,便於從舊程式碼遷移。
自由文字提示,描述錄音情境(如「客服通話」「含醫學術語的問診」),幫助模型貼合語域。實測伺服器端會在 `session.updated` 中原樣回顯,已生效。
字面提示詞陣列,用於產品名、縮寫、專有名詞等易錯詞(如 `["AiHubMix", "gpt-live-transcribe"]`)。它是**提示**而非強制輸出;每個詞單獨一項,避免包含 `<`、`>`、換行符號。實測已回顯生效。
延遲 / 準確率檔位,可選值 `minimal`、`low`、`medium`、`high`、`xhigh`——檔位越高越準但延遲越大。**注意**:閘道接受該欄位(不報錯),但實測未在 `session.updated` 中回顯,生效性以官方文件為準、暫未由回顯確認。
語音活動偵測。轉錄工作階段必須為 `null`。
可選的降噪配置,如 `{ "type": "near_field" }`(近場,適合麥克風貼近說話者)或 `{ "type": "far_field" }`(遠場)。
### 語言代碼(language codes)
`languages` / `language` 的取值遵循以下格式,**大小寫敏感、必須是下方支援的形式**,傳入不支援或格式錯誤的代碼會被 realtime API 拒絕:
| 類別 | 範例 | 說明 |
| ---------------- | ------------------------ | --------------------------- |
| ISO 639-1(兩位) | `en`、`zh`、`es`、`fr`、`ja` | 最常用,一門語言一個兩位碼 |
| 部分 ISO 639-3(三位) | `eng`、`spa`、`yue`、`cmn` | 用於區分方言,如 `yue`=粵語、`cmn`=普通話 |
| 地區化中文 | `zh-cn`、`zh-tw`、`zh-hk` | 語言 + 地區,細分簡繁與港台用詞 |
用 `languages` 複數時,把最可能出現的語言排在前面。多語混說情境(如中英夾雜)可寫 `["zh", "en"]`;單一語言直接寫 `["en"]` 即可,比不指定更準更快。
## 傳送音訊
將 PCM16 音訊切成小片(如每 100ms 一片),base64 編碼後透過 `input_audio_buffer.append` 事件持續傳送:
```json theme={null}
{
"type": "input_audio_buffer.append",
"audio": ""
}
```
由於轉錄工作階段不啟用 VAD(語音活動偵測),伺服器端不會自動判斷一段話何時結束。傳送完一段音訊後,需**手動**發一則 `input_audio_buffer.commit` 標記該段結束,觸發轉錄收尾並返回 `completed` 結果:
```json theme={null}
{ "type": "input_audio_buffer.commit" }
```
## 接收轉錄結果
伺服器端會持續推送事件,關鍵事件類型:
工作階段建立、配置更新的確認。
轉錄**增量**結果,欄位 `delta` 是本次新增的文字片段。邊說邊返回,適合即時顯示到畫面上。
一段語音轉錄**完成**,欄位 `transcript` 是該段的完整文字。
錯誤事件,包含錯誤碼與說明。
## 完整範例
以下給出兩種寫法,任選其一:
* **OpenAI 官方 SDK(推薦)**:無需手寫 WebSocket,把 `websocket_base_url`(SDK 的 WebSocket 基底位址參數)指到閘道即可沿用官方函式庫。
* **原生 websockets**:不安裝 SDK,直接依協定收發訊框,相依最少、便於排查。
**為什麼官方 demo 不傳模型名,我們卻要傳?** OpenAI 的轉錄 intent 把模型放在 `session.update` 的 `transcription.model` 裡,連線 URL 只帶 `?intent=transcription`。AiHubMix 閘道不同:模型名**必須**出現在握手 URL(`?model=gpt-live-transcribe`)——因為閘道在 WebSocket 握手那一刻就要用它**選擇模型推理廠商、鑑權、預留額度**,而 `session.update` 是握手完成之後才到、來不及。所以用 SDK 時要給 `connect()` 明確傳入 `model`(SDK 會把它拼進 URL query);缺了它閘道在**握手期就回 `400 missing_model_parameter`**——`connect()` 直接拋出例外、連線根本建不起來,壓根進不到 `session.update` 那一步。工作階段內 `transcription.model` 仍需與 URL 一致。
```python Python (OpenAI SDK) theme={null}
# 相依套件: pip install "openai[realtime]"
import asyncio
import base64
from openai import AsyncOpenAI
# 沿用官方 SDK 只需三處調整:
# 1) websocket_base_url 指向 AiHubMix 閘道(而非 OpenAI 預設位址)
# 2) connect() 明確傳入 model —— 見上方 Note,閘道握手必需
# 3) extra_query 帶上 intent=transcription
client = AsyncOpenAI(
api_key="sk-***", # 替換為你的 AiHubMix API 金鑰
websocket_base_url="wss://aihubmix.com/v1",
)
async def main():
async with client.realtime.connect(
model="gpt-live-transcribe", # 必傳: 寫進握手 URL,閘道據此選路+計費
extra_query={"intent": "transcription"},
) as conn:
# 1) 配置轉錄工作階段
await conn.session.update(session={
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
})
# 2) 讀取本地 PCM16 / 24kHz / 單聲道 裸音訊,分塊傳送
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = 採樣率 × 2位元組 ÷ 10
for i in range(0, len(pcm), chunk):
await conn.input_audio_buffer.append(
audio=base64.b64encode(pcm[i:i + chunk]).decode()
)
await asyncio.sleep(0.1) # 模擬即時節奏
# 無 VAD,音訊傳送完後手動 commit 觸發轉錄收尾
await conn.input_audio_buffer.commit()
asyncio.create_task(send_audio())
# 3) 接收轉錄結果
async for evt in conn:
etype = getattr(evt, "type", "")
if etype.endswith("transcription.delta"):
print(getattr(evt, "delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[完成]", getattr(evt, "transcript", ""))
break # 拿到完整結果即可退出
elif etype == "error":
print("\n[错误]", evt.to_dict())
break
asyncio.run(main())
```
```python Python (websockets) theme={null}
import asyncio
import base64
import json
import websockets
API_KEY = "sk-***" # 替換為你的 AiHubMix API 金鑰
URL = (
"wss://aihubmix.com/v1/realtime"
"?intent=transcription&model=gpt-live-transcribe"
)
async def main():
# websockets >= 13 用 additional_headers;舊版本用 extra_headers
async with websockets.connect(
URL, additional_headers={"Authorization": f"Bearer {API_KEY}"}
) as ws:
# 1) 配置轉錄工作階段
await ws.send(json.dumps({
"type": "session.update",
"session": {
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {"model": "gpt-live-transcribe", "language": "en"},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
},
}))
# 2) 讀取本地 PCM16 / 24kHz / 單聲道 裸音訊,分塊傳送
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = 採樣率 × 2位元組 ÷ 10
for i in range(0, len(pcm), chunk):
await ws.send(json.dumps({
"type": "input_audio_buffer.append",
"audio": base64.b64encode(pcm[i:i + chunk]).decode(),
}))
await asyncio.sleep(0.1) # 模擬即時節奏
# 無 VAD,音訊傳送完後手動 commit 觸發轉錄收尾
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
asyncio.create_task(send_audio())
# 3) 接收轉錄結果
async for msg in ws:
evt = json.loads(msg)
etype = evt.get("type", "")
if etype.endswith("transcription.delta"):
print(evt.get("delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[完成]", evt.get("transcript", ""))
break # 拿到完整結果即可退出
elif etype == "error":
print("\n[错误]", evt.get("error"))
break
asyncio.run(main())
```
```bash 連線測試 (wscat) theme={null}
# 用 wscat 快速驗證連通性與鑑權(需先 npm i -g wscat)
wscat -c "wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe" \
-H "Authorization: Bearer $AIHUBMIX_API_KEY"
# 連線成功後,貼上一則 session.update 即可開始(音訊需自行 base64 後用 input_audio_buffer.append 傳送)
```
把任意音訊轉成本 API 要求的裸 PCM 格式,可用 ffmpeg:
```bash theme={null}
ffmpeg -i input.mp3 -f s16le -acodec pcm_s16le -ac 1 -ar 24000 audio_pcm16_24k.raw
```
## 執行效果(線上實測)
以下為上述範例在 `aihubmix.com` 線上環境(模型 `gpt-live-transcribe`)的真實執行結果。配置了 `languages: ["en", "zh"]` + `prompt` + `keywords` + `delay: "low"` + `noise_reduction: { "type": "near_field" }`:
```text theme={null}
# 1) 伺服器端回顯確認(session.updated)—— languages / prompt / keywords / noise_reduction 均原樣回顯
session.updated session.audio.input.transcription = {
"model": "gpt-live-transcribe",
"language": null,
"languages": ["en", "zh"],
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"prompt": "Product demo recording, contains the brand name AiHubMix."
}
noise_reduction = { "type": "near_field" } turn_detection = null
# 注意:請求裡傳的 delay 欄位未出現在回顯中
# 2) 音訊(PCM16 / 24kHz / 單聲道)分塊傳送並 commit 後,轉錄逐字增量返回(delta),末尾給出完整文字(completed)
Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
[完成] Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
```
實測中 `languages`、`prompt`、`keywords`、`noise_reduction` 均被伺服器端在 `session.updated` 中原樣回顯,說明配置已實際生效並被套用。`delay` 欄位閘道接受但不回顯,生效性以官方文件為準;`language`(單數)與 `languages`(複數)二者只能傳其一。
## 計費說明
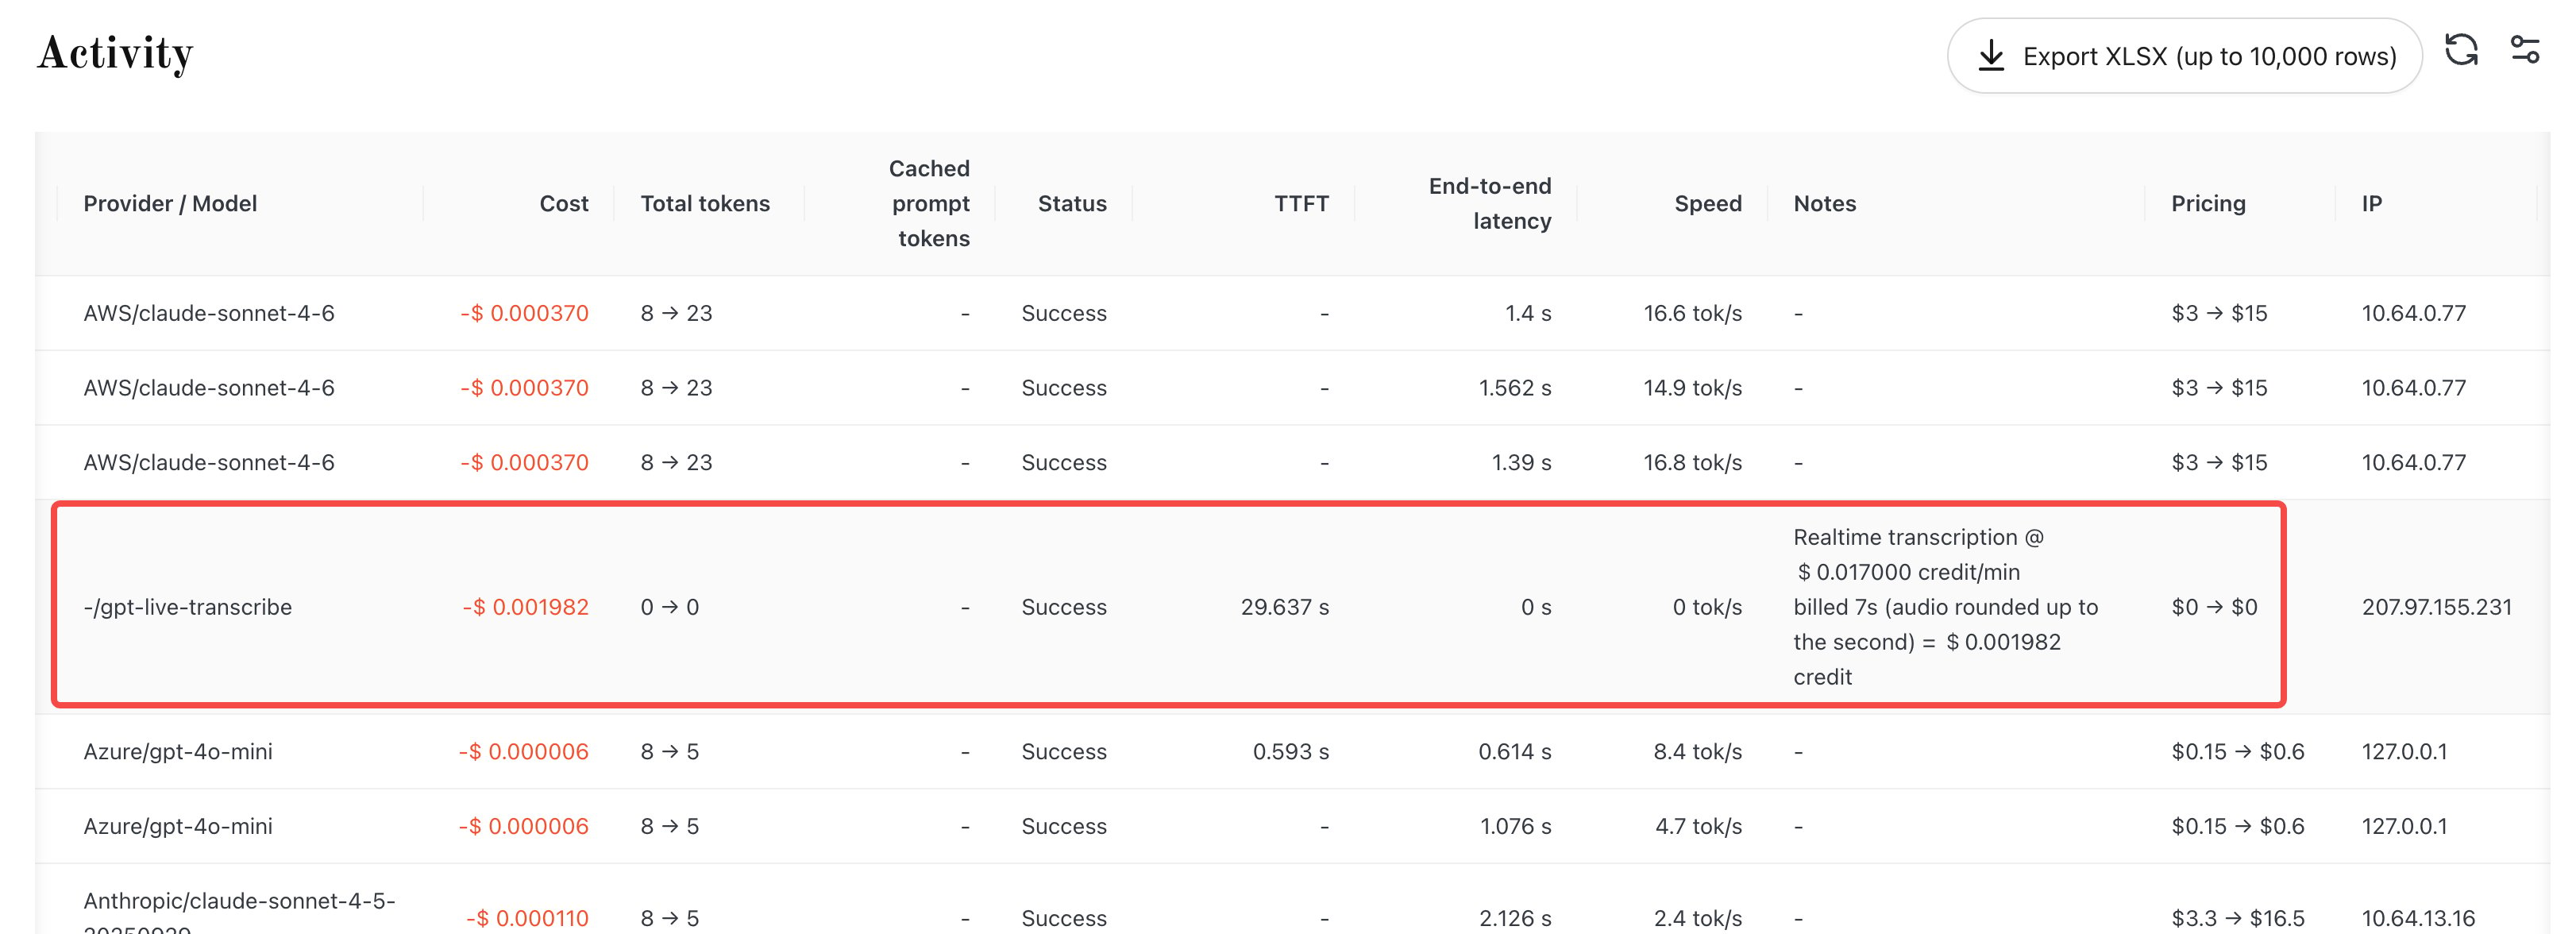
* **單價**:`gpt-live-transcribe` 按 **\$0.017 / 分鐘** 計費(以[模型詳情頁](https://aihubmix.com/model/gpt-live-transcribe)即時掛牌價為準)。
* 按**轉錄的音訊時長**計費:以實際轉發到轉錄模型的音訊秒數為準,無條件進位到整秒。例如轉錄 90 秒音訊,計費 `90 ÷ 60 × $0.017 = $0.0255`。
* 計費不受網路往返或閒置等待影響,只對真正送入轉錄的音訊計時。
* **邊用邊結算**:這是一條長連線,費用**在工作階段過程中分段即時扣除**,工作階段結束時不再一次性結算。建立工作階段時會先按約 1 分鐘用量做一次**額度預留**(僅作准入校驗,不會真實扣費);工作階段中每 20 秒滾動續期一次預留,實際費用按真實轉發秒數分段扣除,工作階段結束後釋放剩餘預留。**因此帳戶可用餘額至少要夠約 1 分鐘的用量,工作階段才能建立。**
* 在 [用量與帳單](https://aihubmix.com) 的消費明細裡,每條即時轉錄記錄的**備註**會標註「每分鐘單價」與「本次實收秒數」,方便逐筆核對。
 ## 限制與約束
1. **單一工作階段時長**:一條 WebSocket 連線最長 **62 分鐘**,到時伺服器端主動關閉;需要更長請分段重新連線。
2. **餘額不足**:分兩種情況——**建立工作階段時**可用餘額不足以涵蓋約 1 分鐘的預留額度,握手直接被拒(HTTP 403),工作階段不會建立;**工作階段進行中**若餘額耗盡(每 20 秒的續期校驗或分段扣費後複查發現),已建立的連線會被立即關閉。
3. **僅伺服器端**:不支援瀏覽器直接連線(校驗 `Origin` 標頭),請在伺服器端整合。
4. **模型鎖定**:模型在連線 URL 固定,工作階段中透過 `session.update` 變更模型會被拒絕並關閉工作階段。
5. **格式鎖定**:僅支援 `audio/pcm@24000` 單聲道,其他格式會被拒絕。
## 常見錯誤
| 情境 | 關閉碼 / 狀態 | 說明 |
| ------------------------ | ---------------------------------- | --------------------- |
| 服務未開啟 | HTTP 403 `realtime_disabled` | 即時轉錄未對該環境開放 |
| 攜帶 `Origin` 標頭 / 瀏覽器直接連線 | 握手被拒 | 改用伺服器端連線 |
| 工作階段中變更模型 | `1008` `model_override_forbidden` | 模型只能在連線 URL 指定 |
| 音訊格式非 PCM | `1008` `audio_format_unsupported` | 轉成 `audio/pcm@24000` |
| 建立連線時餘額不足 | HTTP 403 `insufficient_user_quota` | 餘額不足以預留約 1 分鐘用量,儲值後重試 |
| 工作階段中餘額耗盡 | 連線被關閉 | 儲值後重新連線 |
***
最後更新:2026-09-16