> ## Documentation Index
> Fetch the complete documentation index at: https://docs.aihubmix.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Transcrição de voz em tempo real
> Estabeleça uma conexão persistente via WebSocket e obtenha o texto enquanto se fala, para uma transcrição de voz em streaming com baixa latência
## Introdução
A transcrição de voz em tempo real estabelece uma conexão persistente via WebSocket (um protocolo que mantém uma conexão de longa duração entre cliente e servidor, permitindo enviar dados nos dois sentidos) e processa o fluxo de áudio contínuo **recebendo, transcrevendo e retornando ao mesmo tempo**, sendo adequada para cenários de voz sensíveis à latência.
Diferenças em relação à transcrição de arquivos [STT](/pt/api/STT):
| Dimensão | Transcrição de arquivos (STT) | Transcrição em tempo real (esta página) |
| --------- | ------------------------------------------------- | ---------------------------------------------------------------------- |
| Protocolo | HTTP, uma requisição retorna o resultado completo | WebSocket, envia resultados incrementais continuamente |
| Entrada | Arquivo de áudio completo (≤25MB) | Fluxo de áudio contínuo (fragmentos PCM) |
| Latência | Espera o processamento do trecho inteiro | Retorna o texto durante a fala |
| Uso | Transcrição de gravações, geração de legendas | Legendas de reuniões em tempo real, assistentes de voz, ditado ao vivo |
**Modelos disponíveis:**
* **gpt-live-transcribe**: modelo de transcrição em streaming, suporta múltiplos idiomas e produz o texto transcrito em tempo real conforme o áudio é recebido.
**Esta interface é destinada à integração no lado do servidor; o navegador não pode se conectar diretamente.** Por motivos de segurança, o gateway valida e rejeita conexões que trazem o cabeçalho `Origin`, rejeita o subprotocolo `openai-insecure-api-key` e aceita a chave apenas pelo cabeçalho padrão `Authorization`. WebSockets iniciados pelo navegador anexam automaticamente o cabeçalho `Origin`, portanto são rejeitados. Se você precisa fazer transcrição em tempo real no frontend, estabeleça a conexão com o gateway a partir do seu próprio servidor e depois encaminhe os resultados para o frontend.
## Início rápido
### Endpoint de conexão
```text theme={null}
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe
```
* `intent=transcription`: **obrigatório**, declara que esta é uma sessão de transcrição.
* `model=gpt-live-transcribe`: **obrigatório**, o modelo é fixado pelo parâmetro de URL no momento da conexão e não pode ser alterado durante a sessão (veja as restrições abaixo).
### Autenticação
No handshake, informe a chave por meio do cabeçalho HTTP padrão:
```text theme={null}
Authorization: Bearer $AIHUBMIX_API_KEY
```
### Requisitos de formato de áudio
Atualmente há suporte a apenas um formato de entrada; antes de enviar, converta o áudio para:
* **Codificação**: PCM16 (inteiro de 16 bits com sinal, little-endian)
* **Taxa de amostragem**: 24000 Hz
* **Canais**: mono
Ou seja, `audio/pcm@24000`. Enviar em outro formato (como G.711/µ-law) resulta em rejeição e no fechamento da sessão.
**A sessão de transcrição não suporta detecção de atividade de voz (turn\_detection / VAD)**, que deve ser definida explicitamente como `null`. Se você omitir ou passar um valor diferente de `null`, o provedor de modelos rejeita a transcrição com `invalid_value`. O gateway força `turn_detection` para `null` na configuração encaminhada, mas ainda é recomendável defini-la como `null` no cliente para manter o comportamento claro.
## Configuração da sessão (session.update)
Depois de estabelecida a conexão, o cliente envia primeiro um frame `session.update` para configurar os parâmetros de transcrição. Se você não enviar, o gateway injeta uma configuração padrão de contingência com o modelo autorizado, mas recomenda-se configurar explicitamente.
```json theme={null}
{
"type": "session.update",
"session": {
"type": "transcription",
"audio": {
"input": {
"format": { "type": "audio/pcm", "rate": 24000 },
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"delay": "low"
},
"turn_detection": null,
"noise_reduction": { "type": "near_field" }
}
}
}
}
```
### Parâmetros de configuração
Tipo de sessão; no cenário de transcrição é fixo em `transcription`.
Formato do áudio de entrada, fixo em `{ "type": "audio/pcm", "rate": 24000 }`.
Modelo de transcrição. Deve ser igual ao `model` da URL de conexão (`gpt-live-transcribe`). Passar outro modelo é considerado acesso não autorizado e a sessão será fechada com `1008`.
Lista de idiomas esperados, em forma de array (como `["en", "zh"]`). O `gpt-live-transcribe` usa `languages` no **plural**, permitindo declarar vários idiomas de uma vez; especificar o idioma melhora a precisão e reduz a latência. O dicionário de valores está em [Códigos de idioma](#códigos-de-idioma-language-codes) abaixo.
Forma no singular, um único código ISO-639-1 (como `"en"`). Use `languages` ou `language`, **um dos dois, não passe ambos ao mesmo tempo** (passar os dois resulta em rejeição com `invalid_value`). A recomendação oficial para o `gpt-live-transcribe` é usar `languages` no plural; o gateway também aceita `language` no singular, o que facilita a migração de código antigo.
Prompt de texto livre que descreve o cenário da gravação (como "atendimento ao cliente" ou "consulta com termos médicos"), ajudando o modelo a se ajustar ao registro de linguagem. Em testes reais, o servidor devolve o valor sem alterações em `session.updated`, confirmando que já está em vigor.
Array de termos literais de dica, usado para nomes de produtos, siglas, nomes próprios e outras palavras propensas a erro (como `["AiHubMix", "gpt-live-transcribe"]`). É uma **dica**, não uma saída obrigatória; coloque cada termo como um item separado e evite incluir `<`, `>` ou quebras de linha. Em testes reais, o valor é devolvido e já está em vigor.
Nível de latência / precisão, com valores possíveis `minimal`, `low`, `medium`, `high`, `xhigh`: quanto maior o nível, mais preciso, porém com maior latência. **Atenção**: o gateway aceita este campo (sem erro), mas em testes reais ele não é devolvido em `session.updated`; a efetividade segue a documentação oficial e ainda não foi confirmada pelo retorno.
Detecção de atividade de voz. Na sessão de transcrição deve ser `null`.
Configuração opcional de redução de ruído, como `{ "type": "near_field" }` (campo próximo, adequado quando o microfone está perto de quem fala) ou `{ "type": "far_field" }` (campo distante).
### Códigos de idioma (language codes)
Os valores de `languages` / `language` seguem os formatos abaixo, **diferenciam maiúsculas de minúsculas e devem estar em uma das formas suportadas**; passar um código não suportado ou com formato incorreto faz a realtime API rejeitá-lo:
| Categoria | Exemplo | Descrição |
| --------------------------------- | ---------------------------- | ------------------------------------------------------------------------------------------------- |
| ISO 639-1 (dois dígitos) | `en`, `zh`, `es`, `fr`, `ja` | O mais comum, um código de dois dígitos por idioma |
| Parte do ISO 639-3 (três dígitos) | `eng`, `spa`, `yue`, `cmn` | Usado para distinguir dialetos, como `yue`=cantonês, `cmn`=mandarim |
| Chinês regionalizado | `zh-cn`, `zh-tw`, `zh-hk` | Idioma + região, diferencia chinês simplificado/tradicional e o vocabulário de Hong Kong e Taiwan |
Ao usar `languages` no plural, coloque primeiro os idiomas com maior probabilidade de ocorrer. Em cenários de mistura de idiomas (como chinês e inglês juntos), escreva `["zh", "en"]`; para um único idioma, basta escrever `["en"]`, o que é mais preciso e mais rápido do que não especificar.
## Enviar áudio
Divida o áudio PCM16 em pequenos fragmentos (por exemplo, um a cada 100ms), codifique em base64 e envie continuamente pelo evento `input_audio_buffer.append`:
```json theme={null}
{
"type": "input_audio_buffer.append",
"audio": ""
}
```
Como a sessão de transcrição não habilita o VAD (detecção de atividade de voz), o servidor não determina automaticamente quando um trecho de fala termina. Depois de enviar um trecho de áudio, envie **manualmente** um frame `input_audio_buffer.commit` para marcar o fim desse trecho, o que aciona a finalização da transcrição e retorna o resultado `completed`:
```json theme={null}
{ "type": "input_audio_buffer.commit" }
```
## Receber os resultados da transcrição
O servidor envia eventos continuamente; os principais tipos de evento são:
Confirmação da criação da sessão e da atualização da configuração.
Resultado **incremental** da transcrição; o campo `delta` é o novo trecho de texto adicionado nesta rodada. Retorna durante a fala, adequado para exibir na tela em tempo real.
A transcrição de um trecho de fala foi **concluída**; o campo `transcript` é o texto completo desse trecho.
Evento de erro, contendo o código de erro e a descrição.
## Exemplo completo
A seguir, duas abordagens; escolha uma delas:
* **SDK oficial da OpenAI (recomendado)**: não é preciso escrever o WebSocket manualmente, basta apontar `websocket_base_url` (o parâmetro de base URL do WebSocket do SDK) para o gateway e reutilizar a biblioteca oficial.
* **websockets nativo**: sem instalar o SDK, envie e receba frames diretamente conforme o protocolo, com o mínimo de dependências e mais fácil de depurar.
**Por que o demo oficial não passa o nome do modelo, mas nós precisamos?** O intent de transcrição da OpenAI coloca o modelo em `transcription.model` dentro do `session.update`, e a URL de conexão traz apenas `?intent=transcription`. O gateway da AiHubMix é diferente: o nome do modelo **precisa** aparecer na URL do handshake (`?model=gpt-live-transcribe`), porque o gateway usa esse valor já no momento do handshake do WebSocket para **selecionar o provedor de modelos, autenticar e reservar a cota**, enquanto o `session.update` só chega depois do handshake concluído, tarde demais. Por isso, ao usar o SDK, passe `model` explicitamente para `connect()` (o SDK o insere na query da URL); sem ele, o gateway retorna **`400 missing_model_parameter` ainda na fase do handshake**: `connect()` lança uma exceção diretamente, a conexão nem sequer é estabelecida e não se chega à etapa de `session.update`. Dentro da sessão, `transcription.model` ainda precisa coincidir com a URL.
```python Python (SDK da OpenAI) theme={null}
# Dependência: pip install "openai[realtime]"
import asyncio
import base64
from openai import AsyncOpenAI
# Reutilizar o SDK oficial requer apenas três adaptações:
# 1) websocket_base_url apontando para o gateway da AiHubMix (em vez do endereço padrão da OpenAI)
# 2) connect() passando model explicitamente: veja a Note acima, obrigatório no handshake do gateway
# 3) extra_query trazendo intent=transcription
client = AsyncOpenAI(
api_key="sk-***", # substitua pela sua chave de API da AiHubMix
websocket_base_url="wss://aihubmix.com/v1",
)
async def main():
async with client.realtime.connect(
model="gpt-live-transcribe", # obrigatório: entra na URL do handshake, o gateway usa para roteamento + cobrança
extra_query={"intent": "transcription"},
) as conn:
# 1) Configurar a sessão de transcrição
await conn.session.update(session={
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
})
# 2) Ler o áudio local PCM16 / 24kHz / mono cru e enviar em fragmentos
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = taxa de amostragem × 2 bytes ÷ 10
for i in range(0, len(pcm), chunk):
await conn.input_audio_buffer.append(
audio=base64.b64encode(pcm[i:i + chunk]).decode()
)
await asyncio.sleep(0.1) # simula o ritmo em tempo real
# Sem VAD, faça commit manual após enviar todo o áudio para acionar a finalização da transcrição
await conn.input_audio_buffer.commit()
asyncio.create_task(send_audio())
# 3) Receber os resultados da transcrição
async for evt in conn:
etype = getattr(evt, "type", "")
if etype.endswith("transcription.delta"):
print(getattr(evt, "delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[concluído]", getattr(evt, "transcript", ""))
break # pode sair ao obter o resultado completo
elif etype == "error":
print("\n[erro]", evt.to_dict())
break
asyncio.run(main())
```
```python Python (websockets) theme={null}
import asyncio
import base64
import json
import websockets
API_KEY = "sk-***" # substitua pela sua chave de API da AiHubMix
URL = (
"wss://aihubmix.com/v1/realtime"
"?intent=transcription&model=gpt-live-transcribe"
)
async def main():
# websockets >= 13 usa additional_headers; versões antigas usam extra_headers
async with websockets.connect(
URL, additional_headers={"Authorization": f"Bearer {API_KEY}"}
) as ws:
# 1) Configurar a sessão de transcrição
await ws.send(json.dumps({
"type": "session.update",
"session": {
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {"model": "gpt-live-transcribe", "language": "en"},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
},
}))
# 2) Ler o áudio local PCM16 / 24kHz / mono cru e enviar em fragmentos
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = taxa de amostragem × 2 bytes ÷ 10
for i in range(0, len(pcm), chunk):
await ws.send(json.dumps({
"type": "input_audio_buffer.append",
"audio": base64.b64encode(pcm[i:i + chunk]).decode(),
}))
await asyncio.sleep(0.1) # simula o ritmo em tempo real
# Sem VAD, faça commit manual após enviar todo o áudio para acionar a finalização da transcrição
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
asyncio.create_task(send_audio())
# 3) Receber os resultados da transcrição
async for msg in ws:
evt = json.loads(msg)
etype = evt.get("type", "")
if etype.endswith("transcription.delta"):
print(evt.get("delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[concluído]", evt.get("transcript", ""))
break # pode sair ao obter o resultado completo
elif etype == "error":
print("\n[erro]", evt.get("error"))
break
asyncio.run(main())
```
```bash Teste de conexão (wscat) theme={null}
# Use wscat para validar rapidamente a conectividade e a autenticação (instale antes com npm i -g wscat)
wscat -c "wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe" \
-H "Authorization: Bearer $AIHUBMIX_API_KEY"
# Após conectar, cole um frame session.update para começar (o áudio precisa ser codificado em base64 e enviado com input_audio_buffer.append)
```
Para converter qualquer áudio no formato PCM cru exigido por esta interface, use ffmpeg:
```bash theme={null}
ffmpeg -i input.mp3 -f s16le -acodec pcm_s16le -ac 1 -ar 24000 audio_pcm16_24k.raw
```
## Resultado de execução (teste real em produção)
A seguir está o resultado real do exemplo acima no ambiente de produção `aihubmix.com` (modelo `gpt-live-transcribe`). Foram configurados `languages: ["en", "zh"]` + `prompt` + `keywords` + `delay: "low"` + `noise_reduction: { "type": "near_field" }`:
```text theme={null}
# 1) Confirmação devolvida pelo servidor (session.updated): languages / prompt / keywords / noise_reduction são todos devolvidos sem alteração
session.updated session.audio.input.transcription = {
"model": "gpt-live-transcribe",
"language": null,
"languages": ["en", "zh"],
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"prompt": "Product demo recording, contains the brand name AiHubMix."
}
noise_reduction = { "type": "near_field" } turn_detection = null
# Atenção: o campo delay enviado no pedido não aparece na resposta devolvida
# 2) Depois de o áudio (PCM16 / 24kHz / mono) ser enviado em blocos e feito o commit, a transcrição retorna incrementalmente palavra a palavra (delta) e o texto completo é dado no final (completed)
Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
[concluído] Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
```
Em testes reais, `languages`, `prompt`, `keywords` e `noise_reduction` são todos devolvidos pelo servidor sem alteração em `session.updated`, o que indica que a configuração está de fato em vigor (e não apenas aceita sem processamento). O campo `delay` é aceito pelo gateway, mas não é devolvido; sua efetividade segue a documentação oficial. Entre `language` (singular) e `languages` (plural), só é possível passar um dos dois.
## Detalhes de cobrança
* **Preço unitário**: o `gpt-live-transcribe` é cobrado a **\$0.017 / minuto** (prevalece o preço anunciado em tempo real na [página de detalhes do modelo](https://aihubmix.com/model/gpt-live-transcribe)).
* Cobrança pela **duração do áudio transcrito**: baseia-se nos segundos de áudio efetivamente encaminhados ao modelo de transcrição, arredondados para cima ao segundo inteiro. Por exemplo, transcrever 90 segundos de áudio custa `90 ÷ 60 × $0.017 = $0.0255`.
* A cobrança não é afetada pela ida e volta na rede nem pela espera ociosa, contando apenas o áudio realmente enviado para transcrição.
* **Liquidação contínua durante o uso**: esta é uma conexão de longa duração, e o custo não é liquidado de uma só vez ao fim da sessão, mas descontado em tempo real, por segmentos, ao longo da sessão. Ao estabelecer a sessão, é feita uma **reserva de cota** com base em cerca de 1 minuto de uso (apenas como validação de admissão, não é um débito real); durante a sessão, a reserva é renovada de forma rolante a cada 20 segundos, o custo real é descontado por segmentos conforme os segundos realmente encaminhados, e a reserva restante é liberada ao fim da sessão. **Portanto, o saldo disponível da conta precisa cobrir pelo menos cerca de 1 minuto de uso para que a sessão possa ser estabelecida.**
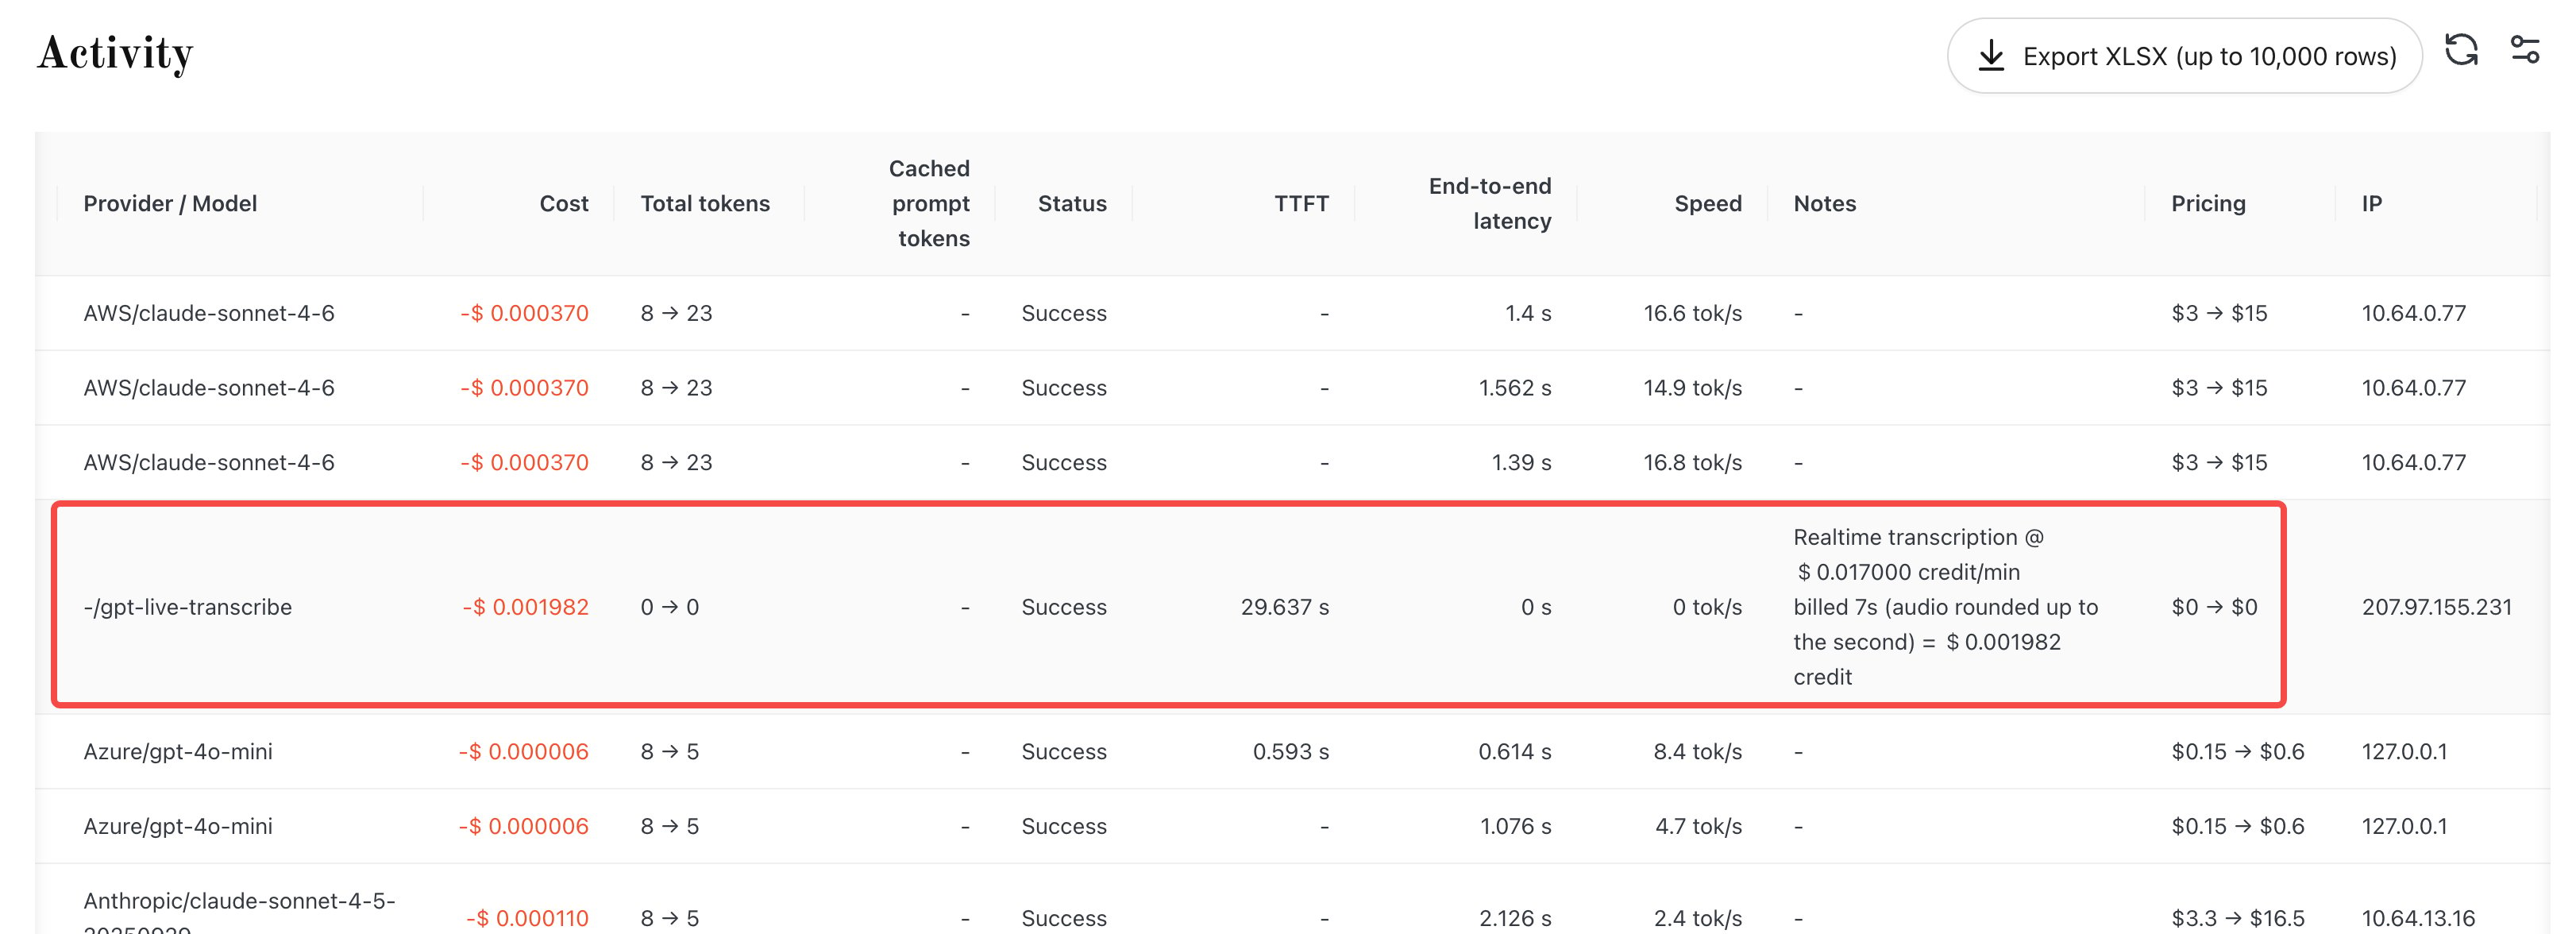
* No detalhamento de consumo em [Uso e faturamento](https://aihubmix.com), a **observação** de cada registro de transcrição em tempo real indica o "preço por minuto" e os "segundos efetivamente cobrados nesta ocasião", facilitando a conferência item a item.
 ## Limites e restrições
1. **Duração de uma sessão**: uma conexão WebSocket dura no máximo **62 minutos**; ao atingir esse limite, o servidor a fecha ativamente; se você precisar de mais tempo, reconecte por segmentos.
2. **Saldo insuficiente**: há dois casos. **Ao estabelecer a sessão**, se o saldo disponível não cobrir a reserva de cerca de 1 minuto, o handshake é rejeitado diretamente (HTTP 403) e a sessão não é estabelecida; **durante a sessão**, se o saldo se esgotar (detectado na validação de renovação a cada 20 segundos ou na reverificação após o débito por segmento), a conexão já estabelecida é fechada imediatamente.
3. **Apenas no lado do servidor**: não há suporte a conexão direta do navegador (o cabeçalho `Origin` é validado); faça a integração no servidor.
4. **Modelo travado**: o modelo é fixado na URL de conexão; tentar alterá-lo durante a sessão via `session.update` é rejeitado e a sessão é fechada.
5. **Formato travado**: há suporte apenas a `audio/pcm@24000` mono; outros formatos são rejeitados.
## Erros comuns
| Cenário | Código de fechamento / status | Descrição |
| ------------------------------------------------------- | ---------------------------------- | ------------------------------------------------------------------------------------- |
| Serviço não habilitado | HTTP 403 `realtime_disabled` | A transcrição em tempo real não está liberada para este ambiente |
| Traz o cabeçalho `Origin` / conexão direta do navegador | Handshake rejeitado | Passe a usar a conexão pelo servidor |
| Alterar o modelo durante a sessão | `1008` `model_override_forbidden` | O modelo só pode ser especificado na URL de conexão |
| Formato de áudio não é PCM | `1008` `audio_format_unsupported` | Converta para `audio/pcm@24000` |
| Saldo insuficiente ao conectar | HTTP 403 `insufficient_user_quota` | O saldo não cobre a reserva de cerca de 1 minuto de uso; recarregue e tente novamente |
| Saldo esgotado durante a sessão | Conexão fechada | Recarregue e reconecte |
***
Última atualização: 2026-09-16