> ## Documentation Index
> Fetch the complete documentation index at: https://docs.aihubmix.com/llms.txt
> Use this file to discover all available pages before exploring further.
# リアルタイム音声認識
> WebSocketで永続的な接続を確立し、話しながらテキストを出力、低遅延のストリーミング音声テキスト変換を実現
## 概要
リアルタイム音声認識は、WebSocket(クライアントとサーバー間で長時間接続を維持し、双方向にデータをプッシュできるプロトコル)で永続的な接続を確立し、連続的に入力される音声ストリームを**受信しながら、文字起こししながら、返却する**ため、遅延に敏感な音声シーンに適しています。
ファイル転写 [STT](/jp/api/STT) との違い:
| 観点 | ファイル転写(STT) | リアルタイム転写(本ページ) |
| ----- | ---------------------- | -------------------------------- |
| プロトコル | HTTP、1回のリクエストで完全な結果を返却 | WebSocket、増分結果を継続的にプッシュ |
| 入力 | 完全なオーディオファイル(≤25MB) | 連続音声ストリーム(PCM分割) |
| 遅延 | 全体の処理完了を待つ | 発話中にテキストを返却 |
| 用途 | 録音転写、字幕生成 | 会議のリアルタイム字幕、音声アシスタント、ライブ配信の文字起こし |
**利用可能モデル:**
* **gpt-live-transcribe** —— ストリーミング転写モデル、多言語対応、音声入力に応じて転写テキストをリアルタイムに出力。
**本APIはサーバーサイド統合向けであり、ブラウザから直接接続することはできません。** セキュリティ上の理由から、ゲートウェイは `Origin` ヘッダー付きの接続を検証して拒否し、`openai-insecure-api-key` サブプロトコルを拒否します。APIキーは標準の `Authorization` ヘッダーのみを受け付けます。ブラウザから発起される WebSocket は自動的に `Origin` ヘッダーを付加するため、拒否されます。フロントエンドでリアルタイム転写を行う必要がある場合は、自身のサーバーサイドでゲートウェイへの接続を確立し、結果をフロントエンドに転送してください。
## クイックスタート
### 接続エンドポイント
```text theme={null}
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe
```
* `intent=transcription` —— **必須**、これが転写セッションであることを宣言します。
* `model=gpt-live-transcribe` —— **必須**、モデルは接続時に URL パラメータで固定され、セッション中は変更できません(下記の制約を参照)。
### 認証
ハンドシェイク時に標準の HTTP ヘッダーでAPIキーを渡します:
```text theme={null}
Authorization: Bearer $AIHUBMIX_API_KEY
```
### オーディオ形式の要件
現在は1種類の入力形式のみをサポートしています。送信前にオーディオを以下の形式に変換してください:
* **エンコード**:PCM16(16ビット符号付き整数、リトルエンディアン)
* **サンプリングレート**:24000 Hz
* **チャンネル**:モノラル(mono)
すなわち `audio/pcm@24000` です。この形式以外(G.711/µ-law など)を送信すると拒否され、セッションが終了します。
**転写セッションは音声活動検出(turn\_detection / VAD)をサポートしていません**。必ず明示的に `null` に設定してください。省略したり `null` 以外の値を渡したりすると、モデルプロバイダーは `invalid_value` で転写を拒否します。ゲートウェイは転送する設定に対して `turn_detection` を強制的に `null` に設定しますが、動作を明確に保つため、クライアント側でも積極的に `null` に設定することを推奨します。
## セッション設定(session.update)
接続確立後、クライアントはまず1フレームの `session.update` を送信して転写パラメータを設定します。送信しない場合、ゲートウェイは認可されたモデルでデフォルト設定を注入してフォールバックしますが、明示的な設定を推奨します。
```json theme={null}
{
"type": "session.update",
"session": {
"type": "transcription",
"audio": {
"input": {
"format": { "type": "audio/pcm", "rate": 24000 },
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会議録音、製品名と英語略称を含む",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"delay": "low"
},
"turn_detection": null,
"noise_reduction": { "type": "near_field" }
}
}
}
}
```
### 設定パラメータ
セッションタイプ。転写シーンでは `transcription` に固定されます。
入力オーディオ形式。`{ "type": "audio/pcm", "rate": 24000 }` に固定されます。
転写モデル。接続 URL の `model` と一致する必要があります(`gpt-live-transcribe`)。他のモデルを渡すと権限外とみなされ、セッションは `1008` で終了されます。
想定される言語のリスト。配列形式(例:`["en", "zh"]`)。`gpt-live-transcribe` は**複数形**の `languages` を使用し、一度に複数の言語を宣言できます。言語を指定すると精度が向上し遅延が低減します。取り得る値は下記の [言語コード](#言語コードlanguage-codes) を参照してください。
単数形の書き方。単一の ISO-639-1 コード(例:`"en"`)。`languages` と**どちらか一方のみ、同時に渡さないでください**(同時に渡すと `invalid_value` で拒否されます)。公式は `gpt-live-transcribe` に複数形の `languages` を推奨していますが、旧コードからの移行を容易にするため、単数形の `language` もゲートウェイは受け付けます。
録音シーンを記述する自由テキストプロンプト(例:「カスタマーサポート通話」「医学用語を含む問診」)。モデルが言語域に適合するのを助けます。実測ではサーバー側が `session.updated` でそのまま返し、既に有効です。
リテラルなヒント語の配列。製品名、略称、固有名詞など誤りやすい語に使用します(例:`["AiHubMix", "gpt-live-transcribe"]`)。これは**ヒント**であり強制的な出力ではありません。各語を個別の項目にし、`<`、`>`、改行文字を含めないようにしてください。実測では既に返され有効です。
遅延 / 精度のレベル。選択可能な値は `minimal`、`low`、`medium`、`high`、`xhigh` —— レベルが高いほど精度が上がりますが遅延も大きくなります。**注意**:ゲートウェイはこのフィールドを受け付けます(エラーになりません)が、実測では `session.updated` に返されません。有効性は公式ドキュメントに準拠し、返却による確認は取れていません。
音声活動検出。転写セッションでは必ず `null` にしてください。
オプションのノイズ低減設定。例:`{ "type": "near_field" }`(近接場、マイクが話者に近い場合に適する)または `{ "type": "far_field" }`(遠方場)。
### 言語コード(language codes)
`languages` / `language` の値は以下の形式に従い、**大文字小文字を区別し、必ず下記のサポートされた形式である必要があります**。サポートされていない、または形式が誤ったコードを渡すと realtime API に拒否されます:
| カテゴリ | 例 | 説明 |
| ----------------- | ------------------------ | -------------------------------- |
| ISO 639-1(2桁) | `en`、`zh`、`es`、`fr`、`ja` | 最も一般的、1言語につき1つの2桁コード |
| 一部の ISO 639-3(3桁) | `eng`、`spa`、`yue`、`cmn` | 方言の区別に使用、例:`yue`=広東語、`cmn`=標準中国語 |
| 地域化中国語 | `zh-cn`、`zh-tw`、`zh-hk` | 言語 + 地域、簡体繁体や香港台湾の用語を細分化 |
複数形の `languages` を使う場合、最も出現する可能性が高い言語を先頭に並べてください。複数言語が混在するシーン(中国語と英語の混在など)では `["zh", "en"]` と書けます。単一言語なら `["en"]` と直接書くだけで、指定しない場合より精度が高く速くなります。
## オーディオの送信
PCM16 オーディオを小さな分割(例:100ms ごとに1片)に切り、base64 エンコードした上で `input_audio_buffer.append` イベントで継続的に送信します:
```json theme={null}
{
"type": "input_audio_buffer.append",
"audio": ""
}
```
転写セッションは VAD(音声活動検出)を有効にしないため、サーバー側は発話がいつ終わったかを自動判定しません。1区間のオーディオを送信し終えたら、**手動**で1フレームの `input_audio_buffer.commit` を送信してその区間の終了を示し、転写の締めくくりをトリガーして `completed` 結果を返却させる必要があります:
```json theme={null}
{ "type": "input_audio_buffer.commit" }
```
## 転写結果の受信
サーバー側はイベントを継続的にプッシュします。主要なイベントタイプ:
セッション作成、設定更新の確認。
転写の**増分**結果。フィールド `delta` は今回新たに追加されたテキスト片です。話しながら返却され、リアルタイム表示に適しています。
1区間の音声転写が**完了**。フィールド `transcript` はその区間の完全なテキストです。
エラーイベント。エラーコードと説明を含みます。
## 完全な例
以下に2種類の書き方を示します。いずれか一方を選んでください:
* **OpenAI 公式 SDK(推奨)**:WebSocket を手書きする必要がなく、`websocket_base_url`(SDK の WebSocket ベースアドレスパラメータ)をゲートウェイに向けるだけで公式ライブラリを再利用できます。
* **ネイティブ websockets**:SDK をインストールせず、プロトコルに従って直接フレームを送受信します。依存が最小で、トラブルシューティングが容易です。
**なぜ公式 demo はモデル名を渡さないのに、私たちは渡すのか?** OpenAI の転写 intent はモデルを `session.update` の `transcription.model` に置き、接続 URL には `?intent=transcription` のみを付けます。AiHubMix ゲートウェイは異なります:モデル名は**必ず**ハンドシェイク URL(`?model=gpt-live-transcribe`)に現れる必要があります —— ゲートウェイは WebSocket ハンドシェイクのその瞬間にそれを使って**モデルプロバイダーの選択、認証、額度の予約**を行う必要があり、`session.update` はハンドシェイク完了後に届くため間に合わないからです。したがって SDK を使う場合は `connect()` に明示的に `model` を渡す必要があります(SDK がそれを URL クエリに組み込みます)。それが欠けるとゲートウェイは**ハンドシェイク期に `400 missing_model_parameter` を返し** —— `connect()` は直接例外をスローし、接続がそもそも確立できず、`session.update` のステップにまったく到達しません。セッション内の `transcription.model` は依然として URL と一致する必要があります。
```python Python (OpenAI SDK) theme={null}
# 依存: pip install "openai[realtime]"
import asyncio
import base64
from openai import AsyncOpenAI
# 公式 SDK を再利用するには 3 箇所の適応だけで済む:
# 1) websocket_base_url を AiHubMix ゲートウェイに向ける(OpenAI のデフォルトアドレスではなく)
# 2) connect() に model を明示的に渡す —— 上記 Note を参照、ゲートウェイのハンドシェイクに必須
# 3) extra_query に intent=transcription を付ける
client = AsyncOpenAI(
api_key="sk-***", # あなたの AiHubMix API キーに置き換え
websocket_base_url="wss://aihubmix.com/v1",
)
async def main():
async with client.realtime.connect(
model="gpt-live-transcribe", # 必須: ハンドシェイク URL に入り、ゲートウェイはこれに基づいてルート選択+課金
extra_query={"intent": "transcription"},
) as conn:
# 1) 転写セッションを設定
await conn.session.update(session={
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会議録音、製品名と英語略称を含む",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
})
# 2) ローカルの PCM16 / 24kHz / モノラル 生オーディオを読み込み、分割送信
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = サンプリングレート × 2バイト ÷ 10
for i in range(0, len(pcm), chunk):
await conn.input_audio_buffer.append(
audio=base64.b64encode(pcm[i:i + chunk]).decode()
)
await asyncio.sleep(0.1) # リアルタイムのペースを模倣
# VAD なし、オーディオ送信後に手動 commit で転写の締めくくりをトリガー
await conn.input_audio_buffer.commit()
asyncio.create_task(send_audio())
# 3) 転写結果を受信
async for evt in conn:
etype = getattr(evt, "type", "")
if etype.endswith("transcription.delta"):
print(getattr(evt, "delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[完了]", getattr(evt, "transcript", ""))
break # 完全な結果を取得したら終了してよい
elif etype == "error":
print("\n[エラー]", evt.to_dict())
break
asyncio.run(main())
```
```python Python (websockets) theme={null}
import asyncio
import base64
import json
import websockets
API_KEY = "sk-***" # あなたの AiHubMix API キーに置き換え
URL = (
"wss://aihubmix.com/v1/realtime"
"?intent=transcription&model=gpt-live-transcribe"
)
async def main():
# websockets >= 13 は additional_headers を使用;旧バージョンは extra_headers を使用
async with websockets.connect(
URL, additional_headers={"Authorization": f"Bearer {API_KEY}"}
) as ws:
# 1) 転写セッションを設定
await ws.send(json.dumps({
"type": "session.update",
"session": {
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {"model": "gpt-live-transcribe", "language": "en"},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
},
}))
# 2) ローカルの PCM16 / 24kHz / モノラル 生オーディオを読み込み、分割送信
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = サンプリングレート × 2バイト ÷ 10
for i in range(0, len(pcm), chunk):
await ws.send(json.dumps({
"type": "input_audio_buffer.append",
"audio": base64.b64encode(pcm[i:i + chunk]).decode(),
}))
await asyncio.sleep(0.1) # リアルタイムのペースを模倣
# VAD なし、オーディオ送信後に手動 commit で転写の締めくくりをトリガー
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
asyncio.create_task(send_audio())
# 3) 転写結果を受信
async for msg in ws:
evt = json.loads(msg)
etype = evt.get("type", "")
if etype.endswith("transcription.delta"):
print(evt.get("delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[完了]", evt.get("transcript", ""))
break # 完全な結果を取得したら終了してよい
elif etype == "error":
print("\n[エラー]", evt.get("error"))
break
asyncio.run(main())
```
```bash 接続テスト (wscat) theme={null}
# wscat で接続性と認証を素早く検証(先に npm i -g wscat が必要)
wscat -c "wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe" \
-H "Authorization: Bearer $AIHUBMIX_API_KEY"
# 接続成功後、session.update を1フレーム貼り付ければ開始できる(オーディオは自分で base64 化し input_audio_buffer.append で送信)
```
任意のオーディオを本APIが要求する生 PCM 形式に変換するには、ffmpeg を使えます:
```bash theme={null}
ffmpeg -i input.mp3 -f s16le -acodec pcm_s16le -ac 1 -ar 24000 audio_pcm16_24k.raw
```
## 動作結果(本番実測)
以下は上記の例を `aihubmix.com` の本番環境(モデル `gpt-live-transcribe`)で実際に実行した結果です。`languages: ["en", "zh"]` + `prompt` + `keywords` + `delay: "low"` + `noise_reduction: { "type": "near_field" }` を設定しています:
```text theme={null}
# 1) サーバー側の返却確認(session.updated)—— languages / prompt / keywords / noise_reduction はいずれもそのまま返される
session.updated session.audio.input.transcription = {
"model": "gpt-live-transcribe",
"language": null,
"languages": ["en", "zh"],
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"prompt": "Product demo recording, contains the brand name AiHubMix."
}
noise_reduction = { "type": "near_field" } turn_detection = null
# 注意:リクエストで渡した delay フィールドは返却に現れない
# 2) オーディオ(PCM16 / 24kHz / モノラル)を分割送信して commit した後、転写結果が1文字ずつ増分で返り(delta)、末尾に完全なテキストが返る(completed)
Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
[完了] Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
```
実測では `languages`、`prompt`、`keywords`、`noise_reduction` はいずれもサーバー側が `session.updated` でそのまま返しており、設定が実際に有効になっている(受け付けるだけで処理しないのではない)ことを示しています。`delay` フィールドはゲートウェイが受け付けますが返しません。有効性は公式ドキュメントに準拠します。`language`(単数)と `languages`(複数)はどちらか一方のみ渡せます。
## 課金説明
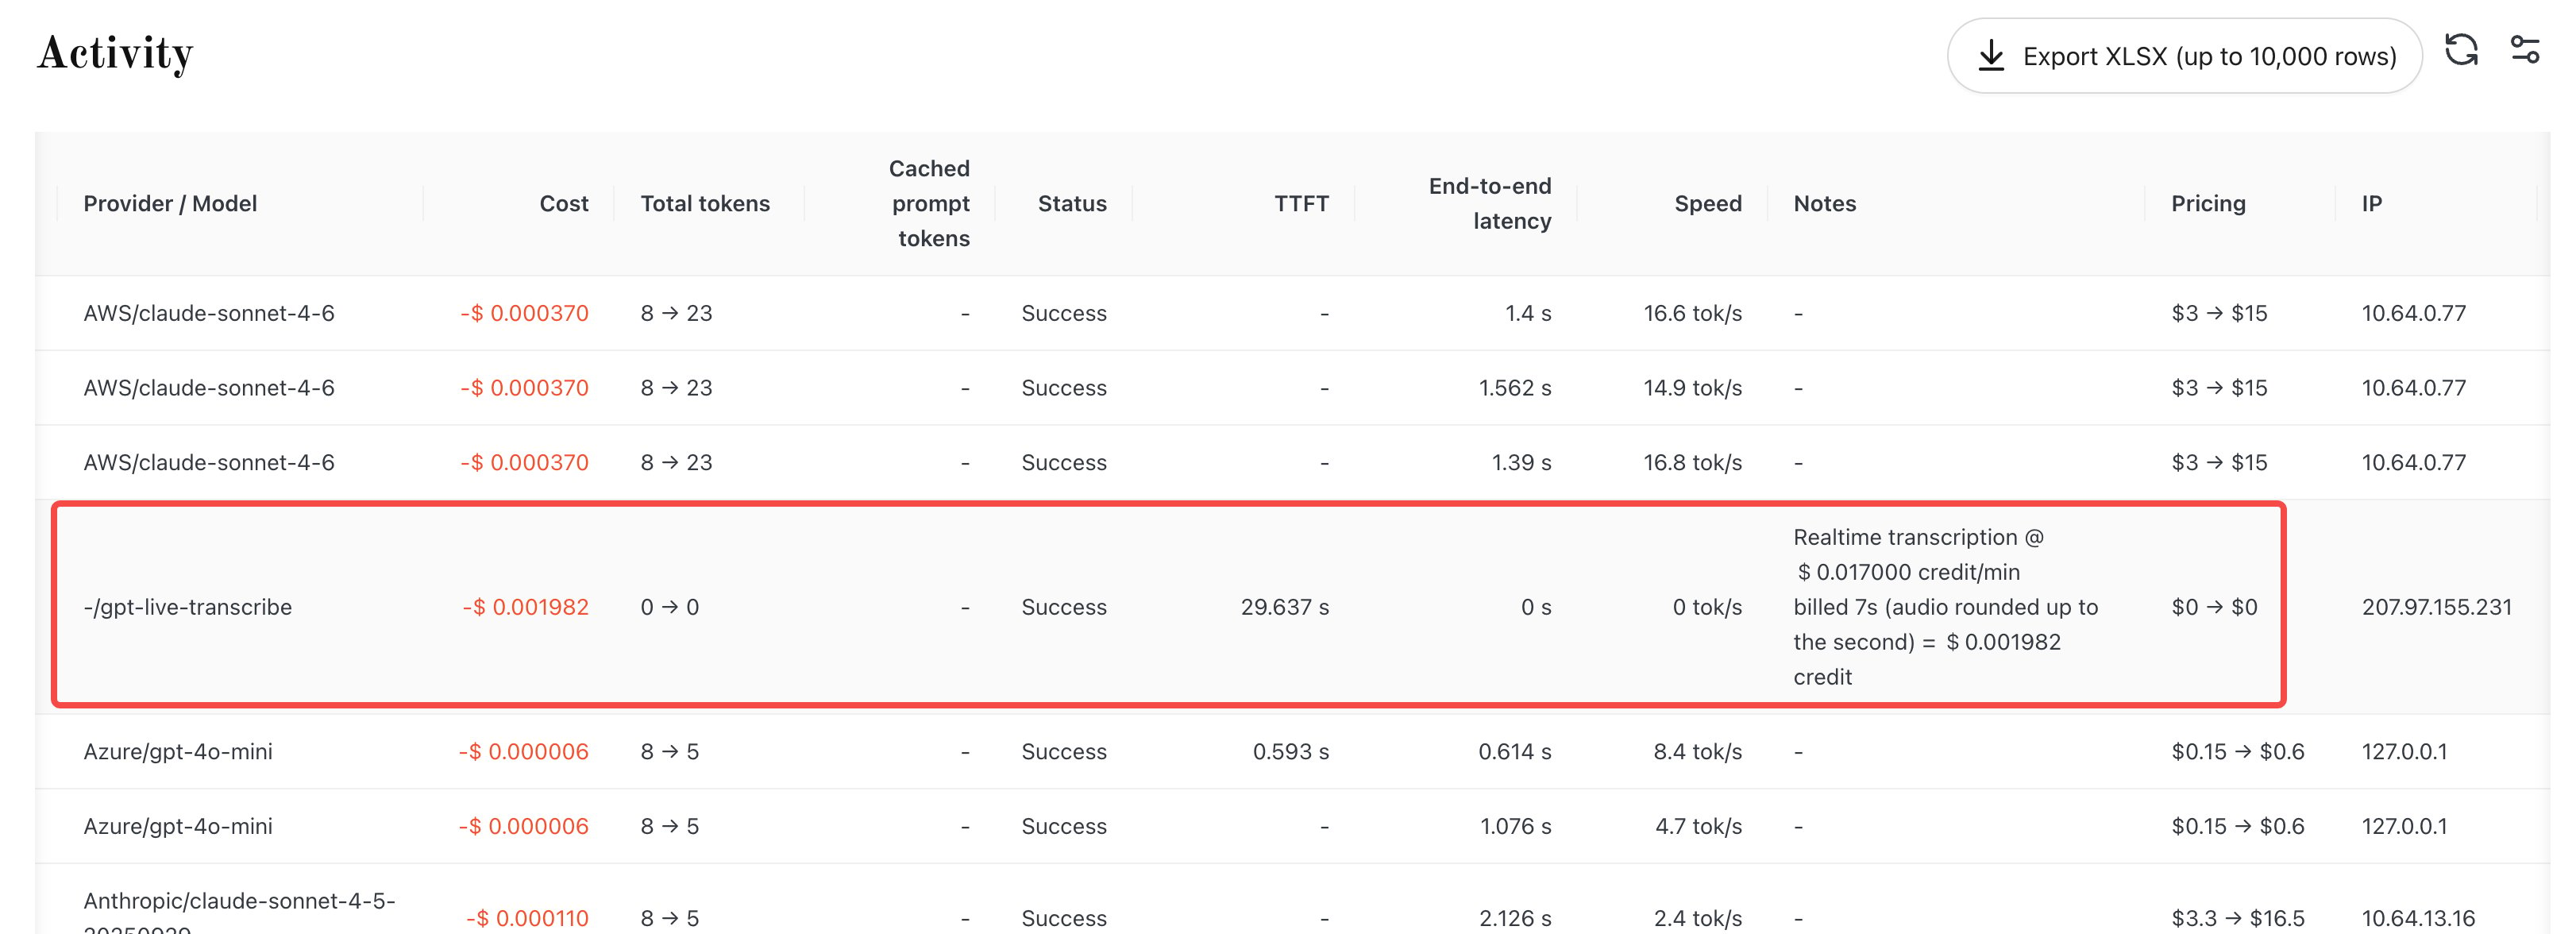
* **単価**:`gpt-live-transcribe` は **\$0.017 / 分** で課金されます([モデル詳細ページ](https://aihubmix.com/model/gpt-live-transcribe)のリアルタイム掲載価格に準拠)。
* **転写したオーディオの長さ**で課金:実際に転写モデルへ転送されたオーディオの秒数を基準とし、整数秒に切り上げます。例えば 90 秒のオーディオを転写した場合、課金は `90 ÷ 60 × $0.017 = $0.0255` です。
* 課金はネットワークの往復やアイドル待機の影響を受けず、実際に転写に投入されたオーディオのみを計時します。
* **使いながら精算**:これは長時間接続であり、費用はセッション終了を待って一括精算するのではなく、**セッションの過程で区間ごとにリアルタイムで差し引かれます**。セッション確立時にまず約1分の使用量で1回**額度の予約**を行います(アクセス審査のためのみで、実際の課金ではありません)。セッション中は20秒ごとに予約をローリング更新し、実際の費用は実転送秒数に応じて区間ごとに差し引かれ、セッション終了後に残りの予約が解放されます。**したがってアカウントの利用可能残高は少なくとも約1分の使用量を賄える必要があり、そうでなければセッションを確立できません。**
* [使用量と請求](https://aihubmix.com) の消費明細では、各リアルタイム転写レコードの**備考**に「毎分単価」と「今回の実収秒数」が記載され、1件ずつの照合が容易です。
 ## 制限と制約
1. **単一セッションの長さ**:1本の WebSocket 接続は最長 **62 分**で、時間になるとサーバー側が能動的に終了します。より長く必要な場合は分割して再接続してください。
2. **残高不足**:2つのケースに分かれます —— **セッション確立時**に利用可能残高が約1分の予約額度を賄えない場合、ハンドシェイクが直接拒否され(HTTP 403)、セッションは確立しません。**セッション進行中**に残高が枯渇した場合(20秒ごとの更新審査または区間課金後の再チェックで判明)、確立済みの接続は即座に終了されます。
3. **サーバーサイドのみ**:ブラウザからの直接接続はサポートしません(`Origin` ヘッダーを検証)。サーバーサイドで統合してください。
4. **モデルロック**:モデルは接続 URL で固定され、セッション中に `session.update` でモデルを変更すると拒否されセッションが終了します。
5. **形式ロック**:`audio/pcm@24000` モノラルのみをサポートし、他の形式は拒否されます。
## よくあるエラー
| シーン | 終了コード / ステータス | 説明 |
| -------------------------- | ---------------------------------- | ----------------------------- |
| サービス未開放 | HTTP 403 `realtime_disabled` | リアルタイム転写がその環境に開放されていない |
| `Origin` ヘッダー付き / ブラウザ直接接続 | ハンドシェイク拒否 | サーバーサイド接続に切り替える |
| セッション中のモデル変更 | `1008` `model_override_forbidden` | モデルは接続 URL でのみ指定可能 |
| オーディオ形式が PCM でない | `1008` `audio_format_unsupported` | `audio/pcm@24000` に変換する |
| 接続確立時の残高不足 | HTTP 403 `insufficient_user_quota` | 残高が約1分の使用量を予約するのに不足、チャージ後に再試行 |
| セッション中の残高枯渇 | 接続終了 | チャージ後に再接続 |
***
最終更新日:2026-09-16