> ## Documentation Index
> Fetch the complete documentation index at: https://docs.aihubmix.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Transcription vocale en temps réel
> Établissez une connexion persistante via WebSocket pour transcrire au fil de la parole et obtenir une conversion audio-texte en flux à faible latence
## Introduction
La transcription vocale en temps réel établit une connexion persistante via WebSocket (un protocole qui maintient une connexion longue entre le client et le serveur et permet de pousser des données dans les deux sens). Le flux audio entrant est **reçu, transcrit et renvoyé en continu**, ce qui convient aux cas d'usage vocaux sensibles à la latence.
Sa différence avec la transcription de fichier [STT](/fr/api/STT) :
| Dimension | Transcription de fichier (STT) | Transcription en temps réel (cette page) |
| --------- | ---------------------------------------------------------- | --------------------------------------------------------------------------- |
| Protocole | HTTP, une requête renvoie le résultat complet | WebSocket, pousse en continu des résultats incrémentaux |
| Entrée | Fichier audio complet (≤25 Mo) | Flux audio continu (fragments PCM) |
| Latence | Attente du traitement du segment entier | Le texte est renvoyé pendant que l'utilisateur parle |
| Usages | Transcription d'enregistrements, génération de sous-titres | Sous-titres en direct pour réunions, assistants vocaux, dictée en streaming |
**Modèles disponibles :**
* **gpt-live-transcribe** : modèle de transcription en flux, prend en charge plusieurs langues et produit le texte transcrit en temps réel au fil de l'audio entrant.
**Cette API vise l'intégration côté serveur ; un navigateur ne peut pas s'y connecter directement.** Pour des raisons de sécurité, la passerelle vérifie et rejette les connexions portant un en-tête `Origin`, refuse le sous-protocole `openai-insecure-api-key`, et n'accepte la clé que via l'en-tête standard `Authorization`. Une connexion WebSocket lancée par un navigateur ajoute automatiquement un en-tête `Origin` et sera donc rejetée. Pour faire de la transcription en temps réel côté frontend, établissez la connexion vers la passerelle depuis votre propre serveur, puis transférez les résultats au frontend.
## Démarrage rapide
### Endpoint de connexion
```text theme={null}
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe
```
* `intent=transcription` : **obligatoire**, déclare qu'il s'agit d'une session de transcription.
* `model=gpt-live-transcribe` : **obligatoire**, le modèle est fixé au moment de la connexion par le paramètre d'URL et ne peut plus être modifié pendant la session (voir les contraintes ci-dessous).
### Authentification
Lors de la poignée de main, transmettez la clé via l'en-tête HTTP standard :
```text theme={null}
Authorization: Bearer $AIHUBMIX_API_KEY
```
### Exigences sur le format audio
Un seul format d'entrée est actuellement pris en charge ; convertissez votre audio avant l'envoi :
* **Encodage** : PCM16 (entier signé 16 bits, petit-boutiste)
* **Fréquence d'échantillonnage** : 24000 Hz
* **Canal** : mono
Soit `audio/pcm@24000`. Envoyer un autre format (par exemple G.711/µ-law) entraîne un rejet et la fermeture de la session.
**Les sessions de transcription ne prennent pas en charge la détection d'activité vocale (turn\_detection / VAD)** ; elle doit être explicitement fixée à `null`. Si elle est omise ou définie à une valeur autre que `null`, le fournisseur de modèles rejette la transcription avec `invalid_value`. La passerelle force `turn_detection` à `null` dans la configuration transférée, mais il reste recommandé de le définir vous-même à `null` côté client pour garder un comportement clair.
## Configuration de session (session.update)
Une fois la connexion établie, le client envoie d'abord une trame `session.update` pour configurer les paramètres de transcription. Si vous n'envoyez rien, la passerelle injecte une configuration par défaut de secours avec le modèle autorisé, mais la configuration explicite est recommandée.
```json theme={null}
{
"type": "session.update",
"session": {
"type": "transcription",
"audio": {
"input": {
"format": { "type": "audio/pcm", "rate": 24000 },
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"delay": "low"
},
"turn_detection": null,
"noise_reduction": { "type": "near_field" }
}
}
}
}
```
### Paramètres de configuration
Type de session ; fixé à `transcription` pour un cas de transcription.
Format audio d'entrée, fixé à `{ "type": "audio/pcm", "rate": 24000 }`.
Modèle de transcription. Il doit être identique au `model` de l'URL de connexion (`gpt-live-transcribe`). Passer un autre modèle est considéré comme un dépassement de droits et la session sera fermée avec le code `1008`.
Liste des langues attendues, sous forme de tableau (par exemple `["en", "zh"]`). `gpt-live-transcribe` utilise le **pluriel** `languages`, ce qui permet de déclarer plusieurs langues à la fois ; préciser la langue améliore la précision et réduit la latence. Le dictionnaire des valeurs figure dans [Codes de langue](#codes-de-langue-language-codes) ci-dessous.
Écriture au singulier, un seul code ISO-639-1 (par exemple `"en"`). À utiliser en **alternative** à `languages`, sans les passer tous les deux (les passer ensemble provoque un rejet avec `invalid_value`). L'officiel recommande le pluriel `languages` pour `gpt-live-transcribe` ; la passerelle accepte aussi le singulier `language`, ce qui facilite la migration depuis d'anciens codes.
Prompt en texte libre décrivant le contexte de l'enregistrement (par exemple « appel du service client » ou « consultation médicale avec termes spécialisés »), pour aider le modèle à coller au registre. En conditions réelles, le serveur le renvoie tel quel dans `session.updated` : il est bien pris en compte.
Tableau de mots-indices littéraux, pour les noms de produit, sigles, noms propres et autres mots sujets à erreur (par exemple `["AiHubMix", "gpt-live-transcribe"]`). Il s'agit d'un **indice** et non d'une sortie imposée ; mettez chaque mot dans un élément distinct et évitez d'y inclure `<`, `>` ou des retours à la ligne. En conditions réelles, il est renvoyé et pris en compte.
Palier latence / précision ; valeurs possibles `minimal`, `low`, `medium`, `high`, `xhigh`. Plus le palier est élevé, plus la précision augmente mais plus la latence croît. **Attention** : la passerelle accepte ce champ (sans erreur), mais en conditions réelles il n'est pas renvoyé dans `session.updated` ; sa prise en compte s'appuie sur la documentation officielle et n'est pas encore confirmée par le renvoi.
Détection d'activité vocale. Elle doit être `null` pour une session de transcription.
Configuration facultative de réduction de bruit, par exemple `{ "type": "near_field" }` (champ proche, adapté quand le micro est près du locuteur) ou `{ "type": "far_field" }` (champ lointain).
### Codes de langue (language codes)
Les valeurs de `languages` / `language` suivent les formats ci-dessous, **sensibles à la casse et limités aux formes prises en charge** ; un code non pris en charge ou mal formé est rejeté par l'API realtime :
| Catégorie | Exemple | Description |
| ---------------------------------- | ---------------------------- | -------------------------------------------------------------------------------------------------- |
| ISO 639-1 (deux lettres) | `en`, `zh`, `es`, `fr`, `ja` | Le plus courant, un code à deux lettres par langue |
| Certains ISO 639-3 (trois lettres) | `eng`, `spa`, `yue`, `cmn` | Pour distinguer les variantes, par exemple `yue`=cantonais, `cmn`=mandarin |
| Chinois régionalisé | `zh-cn`, `zh-tw`, `zh-hk` | Langue + région, distingue le chinois simplifié/traditionnel et le vocabulaire de Hong Kong/Taïwan |
Avec le pluriel `languages`, placez la langue la plus probable en premier. Pour un mélange de langues (par exemple chinois-anglais), écrivez `["zh", "en"]` ; pour une langue unique, écrivez simplement `["en"]`, ce qui est plus précis et plus rapide que de ne rien préciser.
## Envoi de l'audio
Découpez l'audio PCM16 en petits fragments (par exemple un fragment toutes les 100 ms), encodez-les en base64, puis envoyez-les en continu via l'événement `input_audio_buffer.append` :
```json theme={null}
{
"type": "input_audio_buffer.append",
"audio": ""
}
```
Comme la session de transcription n'active pas la VAD (détection d'activité vocale), le serveur ne détermine pas automatiquement la fin d'un énoncé. Après avoir envoyé un segment audio, envoyez **manuellement** une trame `input_audio_buffer.commit` pour marquer la fin de ce segment, ce qui déclenche la finalisation de la transcription et renvoie le résultat `completed` :
```json theme={null}
{ "type": "input_audio_buffer.commit" }
```
## Réception des résultats de transcription
Le serveur pousse des événements en continu ; principaux types d'événements :
Confirmation de la création de session et de la mise à jour de configuration.
Résultat de transcription **incrémental** ; le champ `delta` est le fragment de texte nouvellement ajouté. Renvoyé au fil de la parole, adapté à l'affichage en temps réel.
Transcription d'un segment vocal **terminée** ; le champ `transcript` est le texte complet de ce segment.
Événement d'erreur, contenant le code d'erreur et l'explication.
## Exemple complet
Voici deux façons de procéder, au choix :
* **SDK officiel OpenAI (recommandé)** : pas besoin d'écrire de WebSocket à la main, il suffit de pointer `websocket_base_url` (le paramètre d'adresse de base WebSocket du SDK) vers la passerelle pour réutiliser la bibliothèque officielle.
* **websockets natif** : sans SDK, échangez directement les trames selon le protocole, avec un minimum de dépendances et un diagnostic facilité.
**Pourquoi la démo officielle ne passe-t-elle pas le nom de modèle, alors que nous le devons ?** L'intent de transcription d'OpenAI place le modèle dans `transcription.model` de `session.update`, et l'URL de connexion ne porte que `?intent=transcription`. La passerelle AiHubMix diffère : le nom du modèle **doit** figurer dans l'URL de poignée de main (`?model=gpt-live-transcribe`), car la passerelle en a besoin dès l'instant de la poignée de main WebSocket pour **choisir le fournisseur de modèles, authentifier et réserver le quota**, alors que `session.update` n'arrive qu'après la poignée de main, trop tard. Avec le SDK, passez donc explicitement `model` à `connect()` (le SDK l'ajoutera à la query de l'URL) ; sans lui, la passerelle renvoie **dès la poignée de main un `400 missing_model_parameter`** : `connect()` lève directement une exception, la connexion ne s'établit pas du tout et l'on n'atteint jamais l'étape `session.update`. Dans la session, `transcription.model` doit toujours être identique à celui de l'URL.
```python Python (SDK OpenAI) theme={null}
# Dépendance : pip install "openai[realtime]"
import asyncio
import base64
from openai import AsyncOpenAI
# Réutiliser le SDK officiel ne nécessite que trois adaptations :
# 1) websocket_base_url pointe vers la passerelle AiHubMix (et non l'adresse OpenAI par défaut)
# 2) connect() passe explicitement model : voir la Note ci-dessus, requis à la poignée de main de la passerelle
# 3) extra_query porte intent=transcription
client = AsyncOpenAI(
api_key="sk-***", # Remplacez par votre clé API AiHubMix
websocket_base_url="wss://aihubmix.com/v1",
)
async def main():
async with client.realtime.connect(
model="gpt-live-transcribe", # obligatoire : entre dans l'URL de poignée de main, base du routage et de la facturation par la passerelle
extra_query={"intent": "transcription"},
) as conn:
# 1) Configurer la session de transcription
await conn.session.update(session={
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
})
# 2) Lire l'audio brut local PCM16 / 24 kHz / mono, envoyer par blocs
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100 ms = fréquence d'échantillonnage × 2 octets ÷ 10
for i in range(0, len(pcm), chunk):
await conn.input_audio_buffer.append(
audio=base64.b64encode(pcm[i:i + chunk]).decode()
)
await asyncio.sleep(0.1) # simule le rythme temps réel
# Sans VAD, commit manuel après l'envoi de l'audio pour déclencher la finalisation
await conn.input_audio_buffer.commit()
asyncio.create_task(send_audio())
# 3) Recevoir les résultats de transcription
async for evt in conn:
etype = getattr(evt, "type", "")
if etype.endswith("transcription.delta"):
print(getattr(evt, "delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[terminé]", getattr(evt, "transcript", ""))
break # on peut sortir dès le résultat complet obtenu
elif etype == "error":
print("\n[erreur]", evt.to_dict())
break
asyncio.run(main())
```
```python Python (websockets) theme={null}
import asyncio
import base64
import json
import websockets
API_KEY = "sk-***" # Remplacez par votre clé API AiHubMix
URL = (
"wss://aihubmix.com/v1/realtime"
"?intent=transcription&model=gpt-live-transcribe"
)
async def main():
# websockets >= 13 utilise additional_headers ; les versions antérieures utilisent extra_headers
async with websockets.connect(
URL, additional_headers={"Authorization": f"Bearer {API_KEY}"}
) as ws:
# 1) Configurer la session de transcription
await ws.send(json.dumps({
"type": "session.update",
"session": {
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {"model": "gpt-live-transcribe", "language": "en"},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
},
}))
# 2) Lire l'audio brut local PCM16 / 24 kHz / mono, envoyer par blocs
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100 ms = fréquence d'échantillonnage × 2 octets ÷ 10
for i in range(0, len(pcm), chunk):
await ws.send(json.dumps({
"type": "input_audio_buffer.append",
"audio": base64.b64encode(pcm[i:i + chunk]).decode(),
}))
await asyncio.sleep(0.1) # simule le rythme temps réel
# Sans VAD, commit manuel après l'envoi de l'audio pour déclencher la finalisation
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
asyncio.create_task(send_audio())
# 3) Recevoir les résultats de transcription
async for msg in ws:
evt = json.loads(msg)
etype = evt.get("type", "")
if etype.endswith("transcription.delta"):
print(evt.get("delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[terminé]", evt.get("transcript", ""))
break # on peut sortir dès le résultat complet obtenu
elif etype == "error":
print("\n[erreur]", evt.get("error"))
break
asyncio.run(main())
```
```bash Test de connexion (wscat) theme={null}
# Utilisez wscat pour vérifier rapidement la connectivité et l'authentification (installez d'abord : npm i -g wscat)
wscat -c "wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe" \
-H "Authorization: Bearer $AIHUBMIX_API_KEY"
# Une fois connecté, collez une trame session.update pour démarrer (l'audio doit être encodé en base64 puis envoyé via input_audio_buffer.append)
```
Pour convertir n'importe quel audio dans le format PCM brut requis par cette API, utilisez ffmpeg :
```bash theme={null}
ffmpeg -i input.mp3 -f s16le -acodec pcm_s16le -ac 1 -ar 24000 audio_pcm16_24k.raw
```
## Résultat d'exécution (test réel en production)
Voici le résultat réel de l'exemple ci-dessus exécuté sur l'environnement de production `aihubmix.com` (modèle `gpt-live-transcribe`). La configuration comportait `languages: ["en", "zh"]` + `prompt` + `keywords` + `delay: "low"` + `noise_reduction: { "type": "near_field" }` :
```text theme={null}
# 1) Confirmation renvoyée par le serveur (session.updated) : languages / prompt / keywords / noise_reduction sont tous renvoyés tels quels
session.updated session.audio.input.transcription = {
"model": "gpt-live-transcribe",
"language": null,
"languages": ["en", "zh"],
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"prompt": "Product demo recording, contains the brand name AiHubMix."
}
noise_reduction = { "type": "near_field" } turn_detection = null
# Remarque : le champ delay envoyé dans la requête n'apparaît pas dans le renvoi
# 2) Une fois l'audio (PCM16 / 24kHz / mono) envoyé par segments puis validé par commit, la transcription revient mot à mot en incrémental (delta), le texte complet est fourni à la fin (completed)
Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
[terminé] Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
```
En conditions réelles, `languages`, `prompt`, `keywords` et `noise_reduction` sont tous renvoyés tels quels par le serveur dans `session.updated`, ce qui indique que la configuration est effectivement prise en compte (et pas seulement acceptée sans traitement). Le champ `delay` est accepté par la passerelle mais n'est pas renvoyé ; sa prise en compte s'appuie sur la documentation officielle. `language` (singulier) et `languages` (pluriel) ne peuvent être passés que l'un ou l'autre.
## Facturation
* **Tarif unitaire** : `gpt-live-transcribe` est facturé à **\$0.017 / minute** (le prix affiché en temps réel sur la [page de détail du modèle](https://aihubmix.com/model/gpt-live-transcribe) fait foi).
* Facturation selon la **durée audio transcrite** : basée sur le nombre de secondes d'audio réellement transféré au modèle de transcription, arrondi à la seconde supérieure. Par exemple, transcrire 90 secondes d'audio coûte `90 ÷ 60 × $0.017 = $0.0255`.
* La facturation n'est pas affectée par les aller-retours réseau ni les attentes inactives ; seul l'audio réellement soumis à la transcription est chronométré.
* **Règlement au fil de l'eau** : il s'agit d'une connexion longue ; les frais ne sont pas réglés en une seule fois à la fin de la session, mais **déduits en temps réel par segments pendant la session**. À l'établissement de la session, une **réservation de quota** est effectuée pour environ 1 minute d'usage (simple contrôle d'admission, pas une déduction réelle) ; pendant la session, la réservation est renouvelée par roulement toutes les 20 secondes, les frais réels sont déduits par segments selon les secondes réellement transférées, et la réservation restante est libérée à la fin de la session. **Le solde disponible du compte doit donc couvrir au moins environ 1 minute d'usage pour que la session puisse s'établir.**
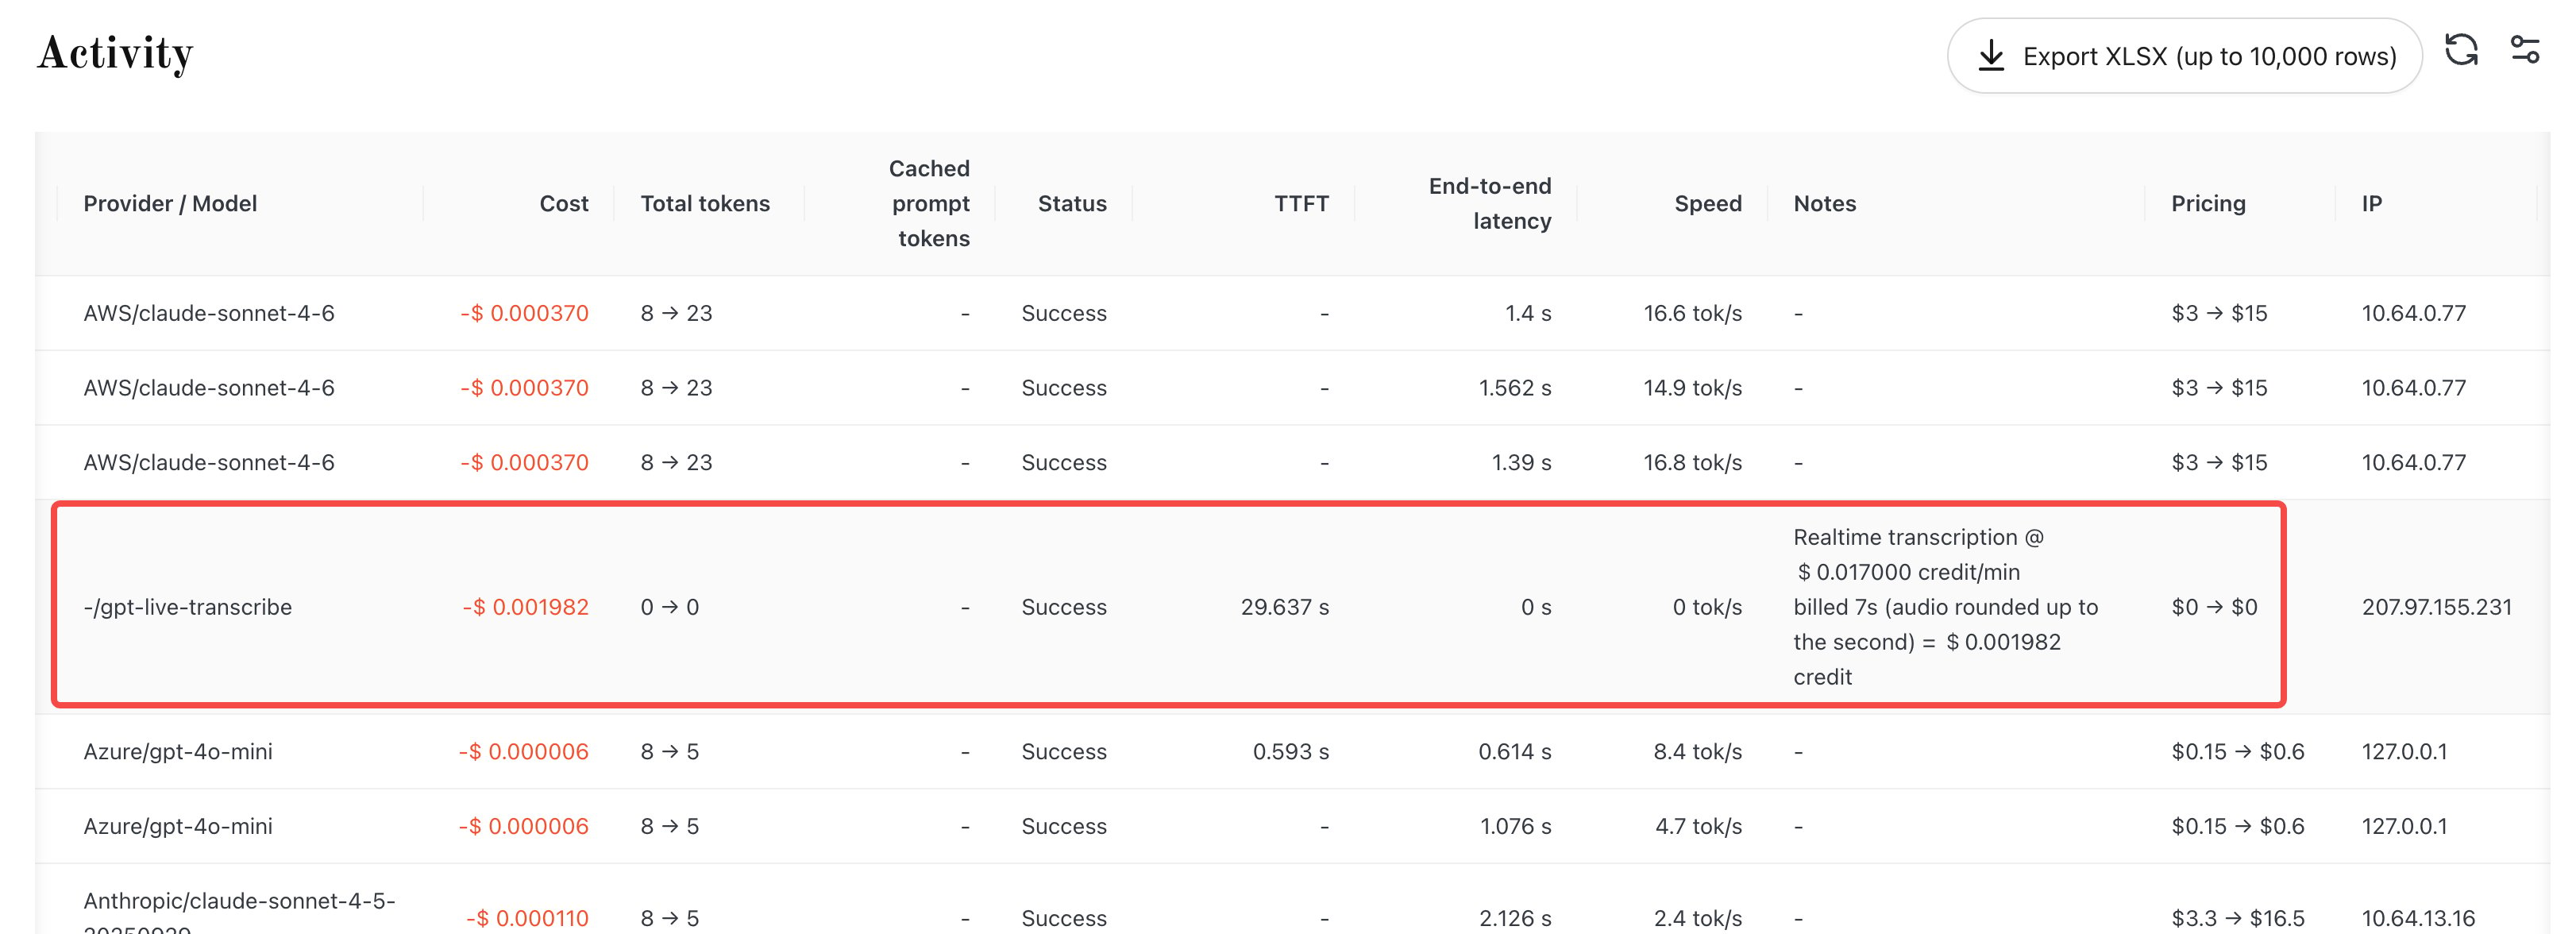
* Dans le détail des dépenses de [Usage et facturation](https://aihubmix.com), la **remarque** de chaque enregistrement de transcription en temps réel indique le « tarif à la minute » et « le nombre de secondes réellement facturées », pour faciliter la vérification enregistrement par enregistrement.
 ## Limites et contraintes
1. **Durée d'une session** : une connexion WebSocket dure au maximum **62 minutes** ; à échéance, le serveur ferme la connexion. Pour une durée supérieure, reconnectez-vous par segments.
2. **Solde insuffisant** : deux cas de figure. **À l'établissement de la session**, si le solde disponible ne couvre pas la réservation d'environ 1 minute, la poignée de main est directement refusée (HTTP 403) et la session ne s'établit pas ; **pendant la session**, si le solde est épuisé (détecté lors du contrôle de renouvellement toutes les 20 secondes ou de la revérification après une déduction segmentée), la connexion déjà établie est immédiatement fermée.
3. **Côté serveur uniquement** : la connexion directe depuis le navigateur n'est pas prise en charge (l'en-tête `Origin` est vérifié) ; intégrez côté serveur.
4. **Verrouillage du modèle** : le modèle est fixé dans l'URL de connexion ; le changer pendant la session via `session.update` est refusé et ferme la session.
5. **Verrouillage du format** : seul `audio/pcm@24000` mono est pris en charge ; les autres formats sont refusés.
## Erreurs fréquentes
| Cas | Code de fermeture / statut | Description |
| ------------------------------------------------------- | ---------------------------------- | -------------------------------------------------------------------------------------------- |
| Service non activé | HTTP 403 `realtime_disabled` | La transcription en temps réel n'est pas ouverte pour cet environnement |
| En-tête `Origin` présent / connexion directe navigateur | Poignée de main refusée | Passez par une connexion côté serveur |
| Changement de modèle en session | `1008` `model_override_forbidden` | Le modèle ne peut être indiqué que dans l'URL de connexion |
| Format audio non PCM | `1008` `audio_format_unsupported` | Convertissez en `audio/pcm@24000` |
| Solde insuffisant à la connexion | HTTP 403 `insufficient_user_quota` | Le solde ne suffit pas à réserver environ 1 minute d'usage ; réapprovisionnez puis réessayez |
| Solde épuisé en session | Connexion fermée | Réapprovisionnez puis reconnectez-vous |
***
Dernière mise à jour : 2026-09-16