> ## Documentation Index
> Fetch the complete documentation index at: https://docs.aihubmix.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Transcripción de voz en tiempo real
> Establece una conexión persistente mediante WebSocket para obtener texto mientras hablas, logrando conversión de voz a texto por streaming con baja latencia
## Introducción
La transcripción de voz en tiempo real establece una conexión persistente mediante WebSocket (un protocolo que mantiene una conexión de larga duración entre el cliente y el servidor y permite enviar datos de forma bidireccional). Recibe, transcribe y devuelve el flujo de audio de entrada de forma continua, lo que resulta adecuado para escenarios de voz sensibles a la latencia.
Su diferencia con la transcripción de archivos [STT](/es/api/STT):
| Dimensión | Transcripción de archivos (STT) | Transcripción en tiempo real (esta página) |
| --------- | ----------------------------------------------------------- | ------------------------------------------------------------------------- |
| Protocolo | HTTP, una sola solicitud que devuelve el resultado completo | WebSocket, envío continuo de resultados incrementales |
| Entrada | Archivo de audio completo (≤25MB) | Flujo de audio continuo (fragmentos PCM) |
| Latencia | Espera a que se procese todo el segmento | Devuelve texto mientras se habla |
| Uso | Transcripción de grabaciones, generación de subtítulos | Subtítulos de reuniones en directo, asistentes de voz, dictado en directo |
**Modelos disponibles:**
* **gpt-live-transcribe**: modelo de transcripción por streaming, admite varios idiomas y produce el texto transcrito en tiempo real a medida que entra el audio.
**Esta API está pensada para integración del lado del servidor; el navegador no puede conectarse directamente.** Por motivos de seguridad, el gateway valida y rechaza las conexiones que incluyen la cabecera `Origin`, rechaza el subprotocolo `openai-insecure-api-key` y solo acepta la clave mediante la cabecera estándar `Authorization`. Los WebSocket iniciados por el navegador añaden automáticamente la cabecera `Origin`, por lo que se rechazan. Si necesitas hacer transcripción en tiempo real en el frontend, establece la conexión al gateway desde tu propio servidor y reenvía después los resultados al frontend.
## Inicio rápido
### Endpoint de conexión
```text theme={null}
wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe
```
* `intent=transcription`: **obligatorio**, declara que se trata de una sesión de transcripción.
* `model=gpt-live-transcribe`: **obligatorio**, el modelo queda fijado por el parámetro de la URL en el momento de la conexión y no se puede cambiar durante la sesión (ver las restricciones más abajo).
### Autenticación
Durante el handshake, la clave se pasa mediante la cabecera HTTP estándar:
```text theme={null}
Authorization: Bearer $AIHUBMIX_API_KEY
```
### Requisitos del formato de audio
Actualmente solo se admite un formato de entrada. Antes de enviar, convierte el audio a:
* **Codificación**: PCM16 (entero con signo de 16 bits, little-endian)
* **Frecuencia de muestreo**: 24000 Hz
* **Canales**: mono (mono)
Es decir, `audio/pcm@24000`. Enviar un formato distinto (como G.711/µ-law) provoca el rechazo y el cierre de la sesión.
**Las sesiones de transcripción no admiten la detección de actividad de voz (turn\_detection / VAD)**, por lo que debe establecerse explícitamente en `null`. Si se omite o se pasa un valor distinto de `null`, el proveedor de modelos lo rechaza con `invalid_value`. El gateway fuerza a `null` el campo `turn_detection` en la configuración que reenvía, pero se recomienda que lo establezcas en `null` de forma activa en el cliente para mantener un comportamiento claro.
## Configuración de la sesión (session.update)
Una vez establecida la conexión, el cliente envía primero un frame `session.update` para configurar los parámetros de transcripción. Si no lo envías, el gateway inyecta una configuración por defecto de respaldo con el modelo autorizado, pero se recomienda configurarla explícitamente.
```json theme={null}
{
"type": "session.update",
"session": {
"type": "transcription",
"audio": {
"input": {
"format": { "type": "audio/pcm", "rate": 24000 },
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"delay": "low"
},
"turn_detection": null,
"noise_reduction": { "type": "near_field" }
}
}
}
}
```
### Parámetros de configuración
Tipo de sesión; en el escenario de transcripción es fijo `transcription`.
Formato del audio de entrada, fijo en `{ "type": "audio/pcm", "rate": 24000 }`.
Modelo de transcripción. Debe coincidir con el parámetro `model` de la URL de conexión (`gpt-live-transcribe`). Pasar otro modelo se considera un uso no autorizado y la sesión se cierra con `1008`.
Lista de idiomas esperados, en forma de array (por ejemplo, `["en", "zh"]`). `gpt-live-transcribe` usa la forma **plural** `languages`, que permite declarar varios idiomas de una vez; especificar el idioma mejora la precisión y reduce la latencia. El diccionario de valores admitidos está más abajo en [Códigos de idioma](#códigos-de-idioma-language-codes).
Forma singular, un único código ISO-639-1 (por ejemplo, `"en"`). Es **una u otra** con `languages`, **no las pases a la vez** (pasar ambas se rechaza con `invalid_value`). Para `gpt-live-transcribe` se recomienda oficialmente usar la forma plural `languages`; el gateway también acepta la forma singular `language` para facilitar la migración desde código antiguo.
Prompt de texto libre que describe el escenario de la grabación (por ejemplo, «llamada de atención al cliente» o «consulta médica con terminología médica»), para ayudar al modelo a ajustarse al registro. En las pruebas, el servidor lo devuelve tal cual en `session.updated`, ya está en efecto.
Array de palabras clave literales, para nombres de producto, siglas, nombres propios y otras palabras propensas a error (por ejemplo, `["AiHubMix", "gpt-live-transcribe"]`). Es una **sugerencia**, no una salida forzada; cada palabra debe ir como un elemento independiente y conviene evitar que incluya `<`, `>` o saltos de línea. En las pruebas se devuelve y está en efecto.
Nivel de latencia / precisión; valores posibles: `minimal`, `low`, `medium`, `high`, `xhigh`. Cuanto más alto el nivel, mayor precisión pero también mayor latencia. **Nota**: el gateway acepta este campo (no da error), pero en las pruebas no se devuelve en `session.updated`; su efectividad se rige por la documentación oficial y de momento no está confirmada por el eco de respuesta.
Detección de actividad de voz. En las sesiones de transcripción debe ser `null`.
Configuración opcional de reducción de ruido, como `{ "type": "near_field" }` (campo cercano, adecuado cuando el micrófono está cerca de quien habla) o `{ "type": "far_field" }` (campo lejano).
### Códigos de idioma (language codes)
Los valores de `languages` / `language` siguen los formatos siguientes, **distinguen mayúsculas y minúsculas y deben tener una de las formas admitidas más abajo**; pasar un código no admitido o con formato erróneo lo rechaza la API de realtime:
| Categoría | Ejemplo | Descripción |
| -------------------------------- | ---------------------------- | ---------------------------------------------------------------------------------- |
| ISO 639-1 (dos letras) | `en`, `zh`, `es`, `fr`, `ja` | Los más usados, un código de dos letras por idioma |
| Parte de ISO 639-3 (tres letras) | `eng`, `spa`, `yue`, `cmn` | Para distinguir dialectos, como `yue`=cantonés, `cmn`=mandarín |
| Chino regionalizado | `zh-cn`, `zh-tw`, `zh-hk` | Idioma + región, subdivide simplificado/tradicional y el uso de Hong Kong y Taiwán |
Al usar la forma plural `languages`, coloca primero los idiomas con mayor probabilidad de aparecer. En escenarios con mezcla de idiomas (como chino e inglés mezclados) puedes escribir `["zh", "en"]`; para un solo idioma basta con escribir `["en"]`, que es más preciso y más rápido que no especificarlo.
## Envío de audio
Divide el audio PCM16 en fragmentos pequeños (por ejemplo, uno cada 100ms), codifícalos en base64 y envíalos de forma continua mediante el evento `input_audio_buffer.append`:
```json theme={null}
{
"type": "input_audio_buffer.append",
"audio": ""
}
```
Dado que las sesiones de transcripción no habilitan VAD (detección de actividad de voz), el servidor no determina automáticamente cuándo termina un segmento. Tras enviar un segmento de audio, debes enviar **manualmente** un frame `input_audio_buffer.commit` para marcar el fin de ese segmento, lo que desencadena el cierre de la transcripción y devuelve el resultado `completed`:
```json theme={null}
{ "type": "input_audio_buffer.commit" }
```
## Recepción de los resultados de transcripción
El servidor envía eventos de forma continua. Tipos de evento clave:
Confirmación de la creación de la sesión y de la actualización de la configuración.
Resultado **incremental** de la transcripción; el campo `delta` es el fragmento de texto añadido en esta ocasión. Se devuelve mientras se habla, adecuado para mostrarlo en pantalla en tiempo real.
Transcripción de un segmento de voz **completada**; el campo `transcript` es el texto completo de ese segmento.
Evento de error, incluye el código de error y su descripción.
## Ejemplo completo
A continuación se presentan dos enfoques; elige el que prefieras:
* **SDK oficial de OpenAI (recomendado)**: no requiere escribir el WebSocket a mano; basta con apuntar `websocket_base_url` (el parámetro de la URL base del WebSocket del SDK) al gateway para reutilizar la biblioteca oficial.
* **websockets nativos**: sin instalar el SDK, envía y recibe frames directamente según el protocolo, con dependencias mínimas y fácil de depurar.
**¿Por qué la demo oficial no pasa el nombre del modelo y nosotros sí?** El intent de transcripción de OpenAI coloca el modelo en `transcription.model` dentro de `session.update`, y la URL de conexión solo lleva `?intent=transcription`. El gateway de AiHubMix es distinto: el nombre del modelo **debe** aparecer en la URL del handshake (`?model=gpt-live-transcribe`), porque el gateway lo necesita en el instante mismo del handshake del WebSocket para **elegir el proveedor de modelos, autenticar y reservar cuota**, mientras que `session.update` llega después de completado el handshake, demasiado tarde. Por eso, al usar el SDK debes pasar `model` explícitamente a `connect()` (el SDK lo incorpora al query de la URL); si falta, el gateway responde **`400 missing_model_parameter` durante el handshake**: `connect()` lanza una excepción directamente, la conexión no llega a establecerse y nunca se alcanza el paso de `session.update`. Dentro de la sesión, `transcription.model` debe seguir coincidiendo con la URL.
```python Python (OpenAI SDK) theme={null}
# Dependencia: pip install "openai[realtime]"
import asyncio
import base64
from openai import AsyncOpenAI
# Reutilizar el SDK oficial solo requiere tres adaptaciones:
# 1) websocket_base_url apunta al gateway de AiHubMix (en lugar de la dirección por defecto de OpenAI)
# 2) connect() pasa model explícitamente: ver la Note de arriba, obligatorio para el handshake del gateway
# 3) extra_query incluye intent=transcription
client = AsyncOpenAI(
api_key="sk-***", # Reemplaza con tu clave de API de AiHubMix
websocket_base_url="wss://aihubmix.com/v1",
)
async def main():
async with client.realtime.connect(
model="gpt-live-transcribe", # Obligatorio: entra en la URL del handshake; el gateway lo usa para enrutar y facturar
extra_query={"intent": "transcription"},
) as conn:
# 1) Configurar la sesión de transcripción
await conn.session.update(session={
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {
"model": "gpt-live-transcribe",
"languages": ["en", "zh"],
"prompt": "会议录音,含产品名与英文缩写",
"keywords": ["AiHubMix", "gpt-live-transcribe"],
},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
})
# 2) Leer el audio en crudo local PCM16 / 24kHz / mono y enviarlo por fragmentos
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = frecuencia de muestreo × 2 bytes ÷ 10
for i in range(0, len(pcm), chunk):
await conn.input_audio_buffer.append(
audio=base64.b64encode(pcm[i:i + chunk]).decode()
)
await asyncio.sleep(0.1) # Simular el ritmo en tiempo real
# Sin VAD, tras enviar el audio hacer commit manual para desencadenar el cierre de la transcripción
await conn.input_audio_buffer.commit()
asyncio.create_task(send_audio())
# 3) Recibir los resultados de transcripción
async for evt in conn:
etype = getattr(evt, "type", "")
if etype.endswith("transcription.delta"):
print(getattr(evt, "delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[Completado]", getattr(evt, "transcript", ""))
break # Con el resultado completo ya se puede salir
elif etype == "error":
print("\n[Error]", evt.to_dict())
break
asyncio.run(main())
```
```python Python (websockets) theme={null}
import asyncio
import base64
import json
import websockets
API_KEY = "sk-***" # Reemplaza con tu clave de API de AiHubMix
URL = (
"wss://aihubmix.com/v1/realtime"
"?intent=transcription&model=gpt-live-transcribe"
)
async def main():
# websockets >= 13 usa additional_headers; las versiones antiguas usan extra_headers
async with websockets.connect(
URL, additional_headers={"Authorization": f"Bearer {API_KEY}"}
) as ws:
# 1) Configurar la sesión de transcripción
await ws.send(json.dumps({
"type": "session.update",
"session": {
"type": "transcription",
"audio": {"input": {
"format": {"type": "audio/pcm", "rate": 24000},
"transcription": {"model": "gpt-live-transcribe", "language": "en"},
"turn_detection": None,
"noise_reduction": {"type": "near_field"},
}},
},
}))
# 2) Leer el audio en crudo local PCM16 / 24kHz / mono y enviarlo por fragmentos
async def send_audio():
with open("audio_pcm16_24k.raw", "rb") as f:
pcm = f.read()
chunk = 24000 * 2 // 10 # 100ms = frecuencia de muestreo × 2 bytes ÷ 10
for i in range(0, len(pcm), chunk):
await ws.send(json.dumps({
"type": "input_audio_buffer.append",
"audio": base64.b64encode(pcm[i:i + chunk]).decode(),
}))
await asyncio.sleep(0.1) # Simular el ritmo en tiempo real
# Sin VAD, tras enviar el audio hacer commit manual para desencadenar el cierre de la transcripción
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
asyncio.create_task(send_audio())
# 3) Recibir los resultados de transcripción
async for msg in ws:
evt = json.loads(msg)
etype = evt.get("type", "")
if etype.endswith("transcription.delta"):
print(evt.get("delta", ""), end="", flush=True)
elif etype.endswith("transcription.completed"):
print("\n[Completado]", evt.get("transcript", ""))
break # Con el resultado completo ya se puede salir
elif etype == "error":
print("\n[Error]", evt.get("error"))
break
asyncio.run(main())
```
```bash Prueba de conexión (wscat) theme={null}
# Usa wscat para verificar rápidamente la conectividad y la autenticación (instala antes con npm i -g wscat)
wscat -c "wss://aihubmix.com/v1/realtime?intent=transcription&model=gpt-live-transcribe" \
-H "Authorization: Bearer $AIHUBMIX_API_KEY"
# Tras conectar correctamente, pega un frame session.update para empezar (el audio debes codificarlo tú en base64 y enviarlo con input_audio_buffer.append)
```
Para convertir cualquier audio al formato PCM en crudo que requiere esta API, puedes usar ffmpeg:
```bash theme={null}
ffmpeg -i input.mp3 -f s16le -acodec pcm_s16le -ac 1 -ar 24000 audio_pcm16_24k.raw
```
## Resultado de ejecución (prueba real en producción)
A continuación se muestra el resultado real de ejecutar el ejemplo anterior en el entorno de producción de `aihubmix.com` (modelo `gpt-live-transcribe`). Se configuró `languages: ["en", "zh"]` + `prompt` + `keywords` + `delay: "low"` + `noise_reduction: { "type": "near_field" }`:
```text theme={null}
# 1) Confirmación del eco del servidor (session.updated): languages / prompt / keywords / noise_reduction se devuelven todos tal cual
session.updated session.audio.input.transcription = {
"model": "gpt-live-transcribe",
"language": null,
"languages": ["en", "zh"],
"keywords": ["AiHubMix", "gpt-live-transcribe"],
"prompt": "Product demo recording, contains the brand name AiHubMix."
}
noise_reduction = { "type": "near_field" } turn_detection = null
# Nota: el campo delay enviado en la solicitud no aparece en el eco
# 2) Tras enviar por bloques el audio (PCM16 / 24kHz / mono) y hacer commit, el resultado de transcripción se devuelve de forma incremental palabra a palabra (delta), y al final se da el texto completo (completed)
Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
[completado] Hello, this is a real-time transcription test for AIHubMix. The weather is really nice today
```
En las pruebas, el servidor devuelve tal cual `languages`, `prompt`, `keywords` y `noise_reduction` en `session.updated`, lo que indica que la configuración está realmente en efecto (no que simplemente se acepte sin procesar). El campo `delay` lo acepta el gateway pero no se devuelve; su efectividad se rige por la documentación oficial. De `language` (singular) y `languages` (plural) solo se puede pasar una de las dos.
## Notas de facturación
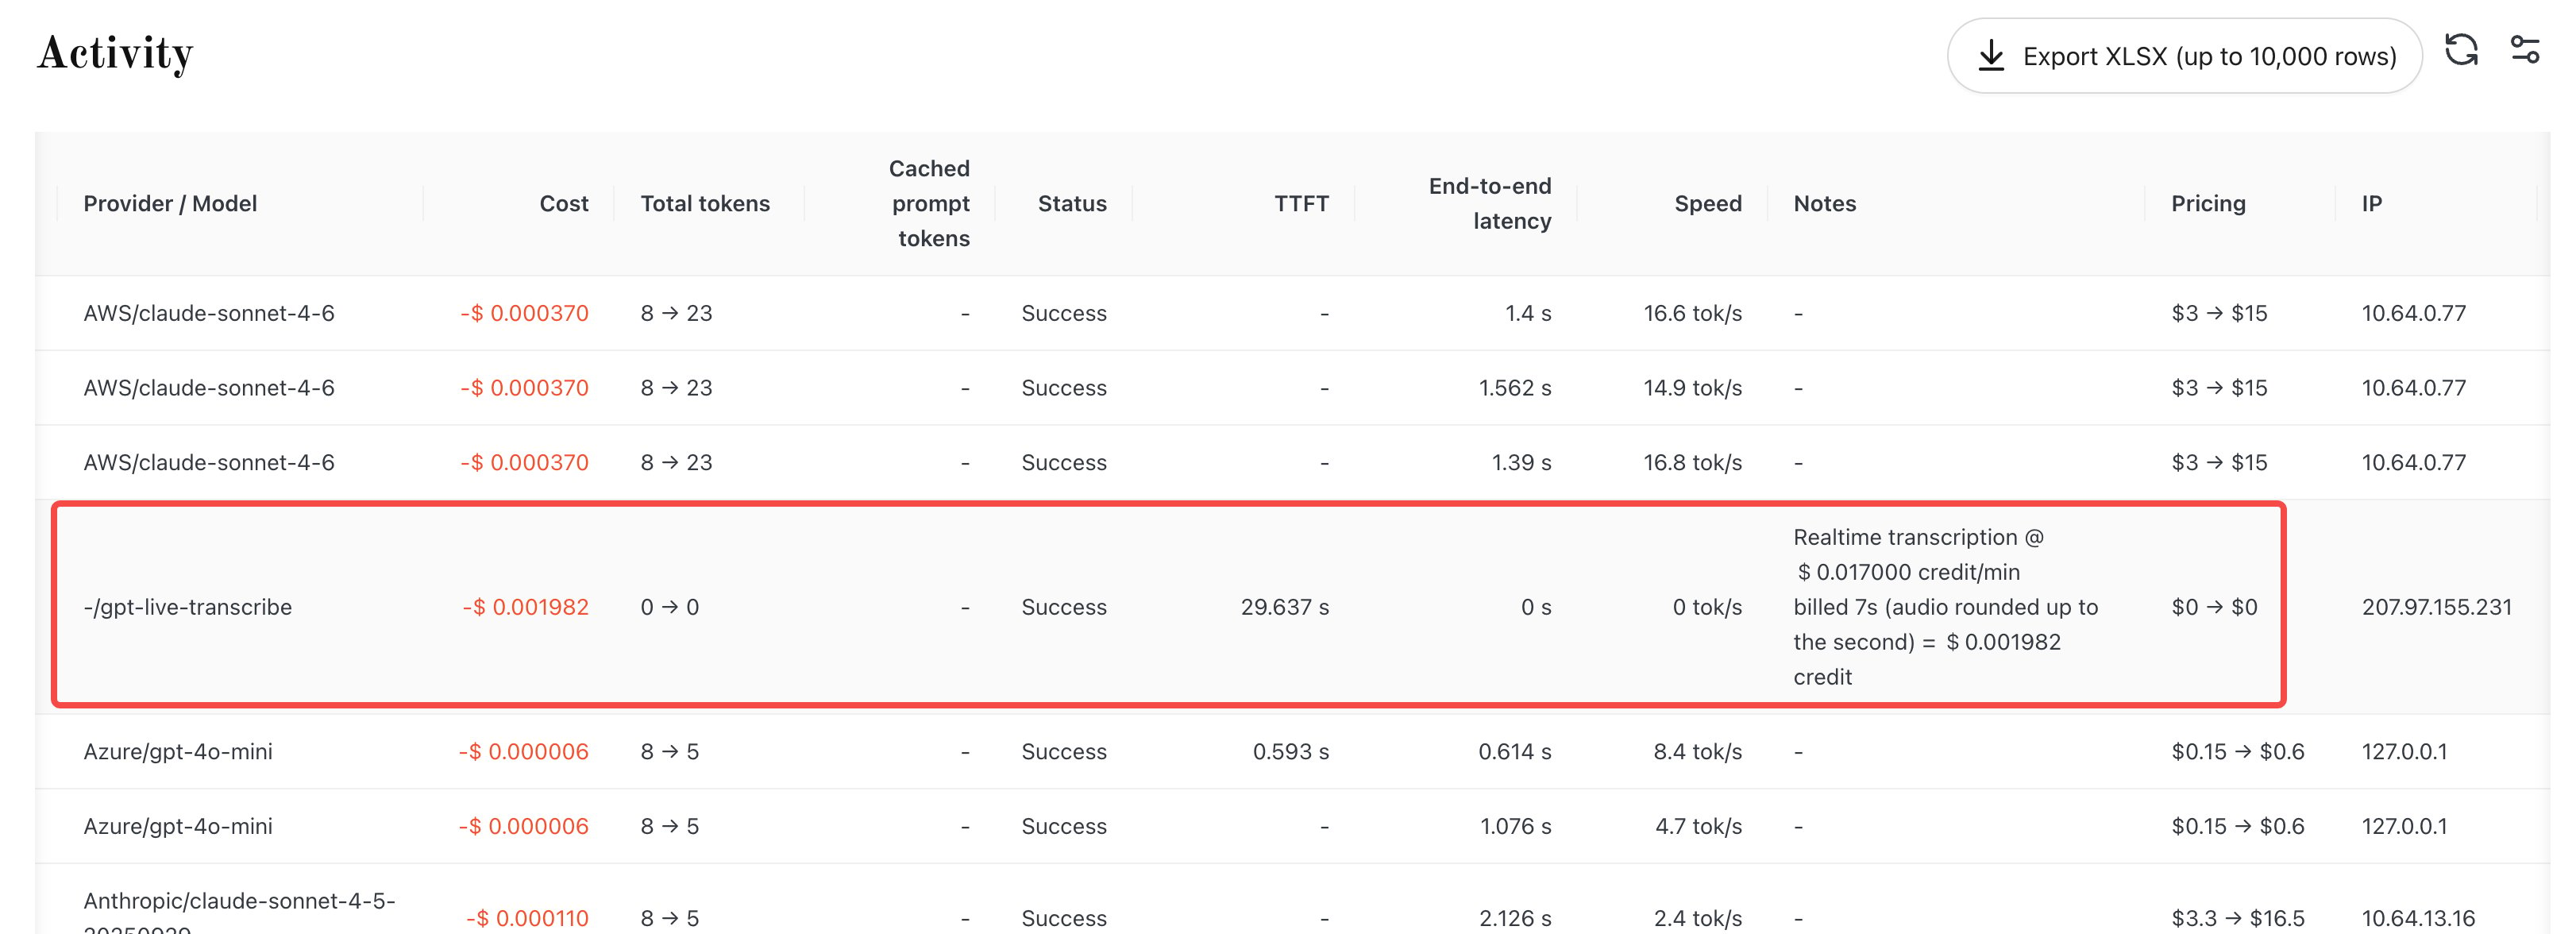
* **Precio unitario**: `gpt-live-transcribe` se factura a **\$0.017 / minuto** (rige el precio de lista en tiempo real de la [página de detalle del modelo](https://aihubmix.com/model/gpt-live-transcribe)).
* Se factura por la **duración del audio transcrito**: rige el número de segundos de audio realmente reenviados al modelo de transcripción, redondeado hacia arriba al segundo entero. Por ejemplo, transcribir 90 segundos de audio se factura como `90 ÷ 60 × $0.017 = $0.0255`.
* La facturación no se ve afectada por el ida y vuelta de red ni por la espera en inactividad; solo se cronometra el audio que realmente entra en la transcripción.
* **Liquidación sobre la marcha**: es una conexión de larga duración, por lo que el coste no se liquida de una sola vez al terminar la sesión, sino que se descuenta en tiempo real por segmentos durante la sesión. Al establecer la sesión se hace primero una **reserva de cuota** por un consumo de aproximadamente 1 minuto (solo como validación de acceso, no es un cargo real); durante la sesión, la reserva se renueva de forma continua cada 20 segundos, y el coste real se descuenta por segmentos según los segundos realmente reenviados; al terminar la sesión se libera la reserva restante. **Por lo tanto, el saldo disponible de la cuenta debe cubrir al menos un consumo de aproximadamente 1 minuto para que la sesión pueda establecerse.**
* En el detalle de consumo de [Uso y facturación](https://aihubmix.com), la **nota** de cada registro de transcripción en tiempo real indica el «precio por minuto» y los «segundos realmente cobrados en esta ocasión», para facilitar la conciliación registro a registro.
 ## Límites y restricciones
1. **Duración de una sesión**: una conexión WebSocket dura como máximo **62 minutos**; al cumplirse, el servidor la cierra de forma activa; si necesitas más tiempo, reconéctate por segmentos.
2. **Saldo insuficiente**: hay dos casos. **Al establecer la sesión**, si el saldo disponible no cubre la reserva de cuota de aproximadamente 1 minuto, el handshake se rechaza directamente (HTTP 403) y la sesión no se establece; **durante la sesión**, si se agota el saldo (detectado en la validación de renovación cada 20 segundos o en la revisión tras un descuento por segmento), la conexión ya establecida se cierra de inmediato.
3. **Solo del lado del servidor**: no se admite la conexión directa desde el navegador (se valida la cabecera `Origin`); realiza la integración en el servidor.
4. **Bloqueo del modelo**: el modelo queda fijado en la URL de conexión; cambiar el modelo durante la sesión mediante `session.update` se rechaza y se cierra la sesión.
5. **Bloqueo del formato**: solo se admite `audio/pcm@24000` en mono; cualquier otro formato se rechaza.
## Errores frecuentes
| Escenario | Código de cierre / estado | Descripción |
| ------------------------------------------------------------- | ---------------------------------- | ---------------------------------------------------------------------------------------- |
| Servicio no habilitado | HTTP 403 `realtime_disabled` | La transcripción en tiempo real no está abierta para ese entorno |
| Incluye la cabecera `Origin` / conexión directa del navegador | Handshake rechazado | Usa una conexión del lado del servidor |
| Cambio de modelo durante la sesión | `1008` `model_override_forbidden` | El modelo solo se puede indicar en la URL de conexión |
| Formato de audio distinto de PCM | `1008` `audio_format_unsupported` | Conviértelo a `audio/pcm@24000` |
| Saldo insuficiente al conectar | HTTP 403 `insufficient_user_quota` | El saldo no cubre la reserva de aproximadamente 1 minuto de consumo; recarga y reintenta |
| Saldo agotado durante la sesión | Conexión cerrada | Recarga y reconéctate |
***
Última actualización: 2026-09-16